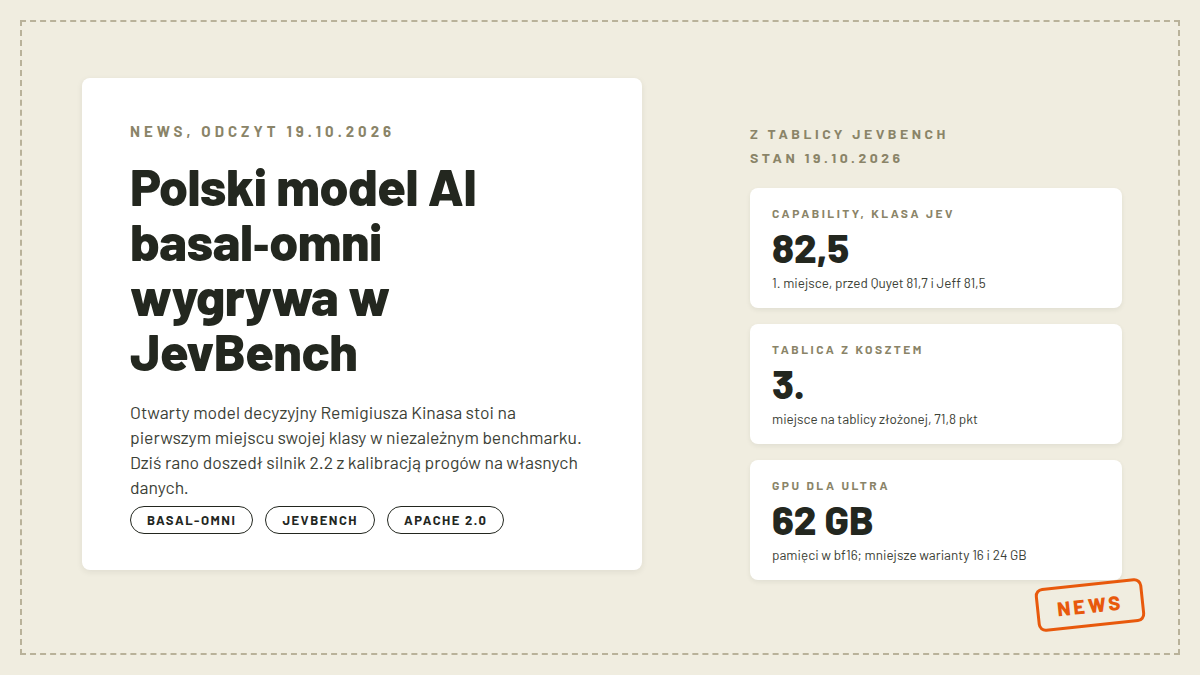
W sobotę 17 października o 9:00 na Hugging Face pojawił się basal-omni-1.0-ultra, największy model z rodziny basal. To projekt Remigiusza Kinasa, na blogu podpisanego imieniem i nazwiskiem z dopiskiem ai5, i robi coś innego niż modele, o których pisze się najczęściej. Model nie pisze odpowiedzi. Na zadane pytanie zwraca wybór z listy opcji, którą sam opisujesz w żądaniu, i prawdopodobieństwo przypisane każdej z nich. Wątek o tym na Hacker News stoi na pięciu punktach i ani jednym komentarzu, ale tablica BenchmarkHeaven zaktualizowała w niedzielę ranking JevBench i wpisała model na pierwsze miejsce wśród systemów klasy Jev: 82,5 punktu na osi Capability, przed Quyet-1.0-Large (81,7) i Jeff-1.0-Large (81,5).
Dziś w poniedziałek rano doszło drugie wydarzenie: o 6:54 czasu polskiego na GitHubie wylądował silnik basal 2.2, który dopasowuje progi ufności do danych użytkownika zamiast do danych twórcy modelu. Ten tekst porządkuje, co z tego wynika. Wyjaśniam, czym właściwie jest model decyzyjny, ile wiary w tablicę JevBench, ile sprzętu trzeba, żeby basal-omni odpalić u siebie i gdzie autorzy sami zaznaczają ograniczenia. Polskie serwisy z dzisiejszego poranka piszą o wyprzedzeniu „modelu OpenAI”; tego twierdzenia w mierzalnej formie nie potwierdziłem, a w tablicach, na które patrzyłem, modeli OpenAI w ogóle nie ma.
- Najważniejsze informacje
- Model, który zamiast pisać, decyduje
- Co dokładnie pokazuje tablica JevBench
- Dwie rodziny na Bieliku i Gemmie 4
- Ile sprzętu trzeba, żeby to odpalić
- Silnik 2.2: progi ufności na twoich danych
- Obrazy, audio i zastrzeżenia, których nie chowają
- Co z tego dla Polski
- Najczęstsze pytania
Najważniejsze informacje
| Co | Stan na 19.10.2026 |
|---|---|
| Ranking Capability klasy Jev | 1. miejsce: 82,5 pkt (tablica BenchmarkHeaven z 18.10, odczyt 19.10) |
| Tablica złożona z kosztem i szybkością | 3. miejsce: 71,8 pkt, za dwoma modelami 4B |
| Koszt na własnym GPU | ok. 0,045 USD za 1000 decyzji (H200, wg tablicy) |
| Licencja i wagi | Apache 2.0 na Hugging Face; basal-2.0 na Bieliku, omni na Gemmie 4 |
| Sprzęt dla ultra (31B) | ok. 62 GB VRAM w bf16, stany do 10 tys. tokenów; FP8 pod vLLM |
| Silnik 2.2 | wydany 19.10: kalibracja progów na własnych danych, GGUF i MLX dla omni (tekst) |
| Audio | tylko mini i max, nagrania do 30 s; ultra czyta obrazy, nie dźwięk |
| Projekt | autor jednoosobowy, repo rkinas/basal, 196 gwiazdek, start końca września |
Model, który zamiast pisać, decyduje
Basal należy do kategorii wyznaczonej przez model Jev firmy TypeSafe AI, a twórcy basal mówią wprost, że wzorowali się na System 1: szybkich, intuicyjnych decyzjach zamiast długiego rozumowania. W miejsce czatu dostajesz klasyfikator definiowany przy każdym żądaniu. Wysyłasz stan, czyli wiadomość klienta, zeskanowany dokument albo ślad pracy agenta, i pytania z listą dozwolonych odpowiedzi. Model jednym przejściem przez sieć zwraca wybór i prawdopodobieństwa, więc odpowiedź nie wyjdzie poza opcje, które podałeś, a liczba obok mówi, jak bardzo jest pewna.
Nazwa pochodzi od jąder podstawy, części mózgu wybierającej jedno działanie z konkurencyjnych opcji. API stoi pod POST /v1/systemone, tym samym endpointem co reszta tej kategorii, więc integrację piszesz raz. Pytania mają typy: choice (wybór z listy do 255 opcji), noul (tak albo nie), score (skala uporządkowana), multi (wiele etykiet), act (akcja z kosztem) i tool (wybór narzędzia agenta z definicji OpenAI albo MCP). Kilka pytań o ten sam kontekst leci w jednym żądaniu, więc z jednej skargi klienta dostajesz dział, pilność i tematy naraz. Silnik 2.1 doszedł zadania classify, verify, compress i extract: etykiety z rubrykami, sprawdzanie tez, skracanie dokumentu pod pytanie i wypełnianie schematu JSON danymi z dokumentu, wciąż bez generowania tekstu.
Co dokładnie pokazuje tablica JevBench
JevBench to otwarty benchmark dla modeli decyzyjnych: stan i rubryka na wejściu, typowana odpowiedź na wyjściu, po 1500 decyzji na system. Framework zbudował zespół Leanmcp (preprint Dheeraja Mohandasa Paja i Lu Xiana na Preprints.org, dataset na Hugging Face, kod na licencji MIT), a widoczność dał mu Show HN z końca września z 154 punktami. Wyniki agreguje między innymi tablica BenchmarkHeaven, która w niedzielę liczyła 184 policzone systemy na otwartych wagach w rewizji v1.7.46.
Basal-omni-1.0-ultra stoi tam na pierwszym miejscu z oficjalnym rankingiem, 82,5 punktu Capability. Haczyk jest taki, że tablica rankuje systemy klasy Jev, czyli takie, których koszt i typowe opóźnienie nie przekraczają dwukrotności referencyjnego Jeva. Perplexity Decider v1.1 27B ma surowo minimalnie więcej (82,8), ale jego koszt, 0,217 USD za tysiąc decyzji, wypada poza klasę i w kolumnie z miejscem dostaje samą poziomą kreskę. Podobnie Jev 1.13.0 (77,1) i Clef Cloudflare (75,3): pokazane dla porównania, bez miejsca w tabeli. Basal wygrywa więc swoją klasę cenową, a tytułowe „wyprzedza Jeva i Clefa” dotyczy dokładności, nie jednej wspólnej listy.
Na tablicy złożonej, gdzie liczą się też koszt i szybkość, basal jest trzeci z 71,8 punktu, za H2O-Lightning-4B (72,5) i Torchcast Decision 4B (71,8), dwoma maluchami, bo tutaj cena waży tyle co trafność. O modelu mówią pośrednio same osie: inteligencja 74,1 przy kalibracji 91,0, czyli profil systemu celnego i uczciwie zgranego z własną pewnością siebie. Koszt według tablicy: 0,045 USD za tysiąc decyzji.
Dwie rodziny na Bieliku i Gemmie 4
Rodzina basal-2.0 to modele tekstowe: mini (1.5B), 4.5B i max (11B), każde na polskim Bieliku od SpeakLeash. Rodzina basal-omni stawia na Gemmę 4 od Google: mini na wariant E4B, max na 12B i ultra na 31B, i dorzuca do żądania obrazy, mniejsze warianty także nagrania audio do 30 sekund. Ultra ma za sobą trening na około 640 tysiącach polskich i angielskich decyzji z typowanymi pytaniami, z miękkimi celami wyliczonymi z wcześniejszego basal-1.5.
Autorzy mierzą jakość własnym ukrytym benchmarkiem Werdykt: 10 kategorii po polsku i angielsku, 5000 decyzji w jednym protokole. Ultra dostaje 87,9% makro (po polsku 88,1%), o 5,6 punktu więcej niż omni-max i 10,6 więcej niż poprzedzający basal-1.5-max. Podkreślam uczciwie: Werdykt to benchmark twórcy, jego zbiory nie są publiczne i nikt z zewnątrz ich nie policzy. Niezależne potwierdzenie klasy daje dopiero JevBench, gdzie liczby wyciąga ktoś inny niż autor.
Ile sprzętu trzeba, żeby to odpalić
| Model | Pamięć GPU | Uruchomienie |
|---|---|---|
| omni-mini (4B) | ok. 16 GB | NVIDIA w bf16; od 2.2 też GGUF i MLX, tekst |
| omni-max (12B) | ok. 24 GB | NVIDIA w bf16; od 2.2 też GGUF i MLX, tekst |
| omni-ultra (31B) | ok. 62 GB w bf16, karta 80 GB | NVIDIA, tryb eager; FP8 pod vLLM, tekst |
| basal-2.0 (1.5B, 4.5B, 11B) | od kilku GB | NVIDIA, Mac (MLX), Ollama i llama.cpp |
Start według dokumentacji wygląda tak: środowisko przez uv, PyTorch 2.11 pod CUDA 12.8, silnik z release na GitHubie, potem basal-serve --model Remek/basal-omni-1.0-ultra --media on. Pierwsze uruchomienie kompiluje model przez kilka minut. Szybkość wg autora na jednej H200: 80 ms na pytanie w medianie i 8,6 decyzji na sekundę przy 32 klientach; mniejszy basal-1.5-max w trybie fast robi to w 27 ms i 33 decyzje na sekundę. Liczby autora, nie nasz pomiar, bo H200 nie mamy przy sobie.
Silnik 2.2 dokłada porty GGUF i MLX dla omni-mini i omni-max, ale z ważną gwiazdką: tylko tekst, bo multimediów w tych ścieżkach jeszcze nie ma. Społeczność dorzuciła silniki eksperymentalne na Google TPU (Kuba Sołtys) i AMD Strix Halo (Michał Kardyś) oraz narzędzie do naprawy GGUF, żeby llama.cpp i Ollama tokenizowały jak oryginalny tokenizer (Piotr Durlej).
Silnik 2.2: progi ufności na twoich danych
Najbardziej praktyczna część dzisiejszego wydania to polecenie basal-calibrate. Problem, który rozwiązuje: plik kalibracyjny dołączony do wagi był dopasowany na danych autora, a na twojej domenie model może być pewny siebie w inny sposób. Na otwartej domenie testowej, czyli syntetycznych decyzjach o serwisie klienta, fakturach, incydentach i śladach agentów, których model nie widział, ustawienie fabryczne „błąd 1%” automatyzowało decyzje mylące się w 8%. Po kalibracji na 800 przykładowych żądaniach przy celu 1% model nie zautomatyzował niczego, a przy celu 5% zautomatyzował 3,7% decyzji bez ani jednego błędu; błąd kalibracji pytań wyboru spadł z 0,268 do 0,083.
Przepływ jest trzystopniowy: basal-calibrate z flagą --report-only tylko mierzy i pisze raport, drugie wywołanie dopasowuje plik CALIBRATION.custom.json, trzecie startuje serwer z nim. Decyzje dzielone są 70/30 na dopasowanie i kontrolę, a przypadki jednego klienta zostają po tej samej stronie podziału. Autor słusznie podkreśla, że hostowane API decyzji takiej opcji nie daje: jego pewność siebie jest taka, jaka jest na twoich danych.
Obrazy, audio i zastrzeżenia, których nie chowają
Omni czyta obrazy przez enkoder Gemmy 4 bez treningu na mediach, a autorzy pokazują to na małych polskich próbach, podając liczby wprost. Decyzje o dokumentach z obrazu wypadają na 89,4% wobec 93,1% z samego tekstu dokumentu (baza Gemma 4 bez treningu: 76,9%), więc skan prawie dorównuje tekstowi. Ze zdjęciami jest odwrotnie: trening tekstowy nic nie dał, bo zdjęcia z obrazu dostają 80,0% wobec 83,3% dla nietrenowanej bazy. Ultra nie przyjmuje dźwięku wcale, bo baza 31B nie ma enkodera audio, a żądanie z nagraniem dostaje HTTP 422. Kalibracja wszystkich wariantów pochodzi z tekstu, więc progi na mediach każdy powinien sprawdzić na własnych przykładach przed automatyzacją.
Do kompletu: omni działa teraz tylko na NVIDIA w trybie eager (tryb fast obiecano w kolejnym wydaniu), jedno żądanie niesie do 8 plików po 20 MB, a cała rodzina jest oznaczona jako eksperymentalna. Odbiór na razie cichy: dwa wątki na Hacker News z 18 października mają razem 7 punktów i zero komentarzy, a polskie pokrycie zaczęło się w sobotę od Devstocku i zalało dziś rano: Zero.pl, MyCompanyPolska i Polski Przemysł. Benchmark jest, tłumu jeszcze nie ma.
Co z tego dla Polski
Z polskiego tu jest więcej niż nazwisko autora. Podstawą rodziny tekstowej jest Bielik, o którym pisaliśmy osobno, trening ultra liczył po połowie polskich i angielskich decyzji, próby medialne stawiają polskie dokumenty i nagrania, filmy w Basal Lab mają polski lektor, a do repo dołożyło się już trzech polskich kontrybutorów. Frazy „basal omni co to” i „basal omni github” siedzą w podpowiedziach Google, a w polskich wynikach poza serwisami z dzisiejszego poranka nie ma kto siedzieć.
Realny adresat to nie osoba, która chce pogadać z AI, tylko zespół stawiający automatyzację procesów na własnych danych: obsługi zgłoszeń, pracy dokumentowej, decyzji agentów, tam gdzie nie chcesz wysyłać treści do chmury i potrzebujesz progów, za którymi stoi policzalny błąd. Próg wejścia to karta NVIDIA i gotowość do przeczytania dokumentacji. Jeśli budujesz coś takiego na otwartych modelach, mapę pola masz w tekście o otwartych modelach AI, a hub lokalne-ai zbiera resztę opisywanych przez nas narzędzi.
Najczęstsze pytania
Co to jest basal-omni?
Rodzina otwartych modeli AI typu decyzyjnego od polskiego autora Remigiusza Kinasa. Zamiast pisać odpowiedzi, model zwraca wybór z listy opcji opisanych w żądaniu i prawdopodobieństwo każdej z nich. Rodzina czyta tekst, obrazy i (poza ultra) nagrania audio do 30 sekund.
Czy basal-omni jest darmowy?
Tak, wagi na Hugging Face i silnik na GitHubie stoją na licencji Apache 2.0. Płacisz własnym sprzętem: ultra potrzebuje karty z ok. 62 GB pamięci w bf16 (albo wariantu FP8), mniejsze warianty mieszczą się w 16-24 GB, a rodzina tekstowa 2.0 chodzi nawet przez Ollama.
Czy basal-omni działa po polsku?
Tak. Trening liczył około 640 tysięcy decyzji po polsku i angielsku, a w ukrytym benchmarku autora ultra dostaje 88,1% po polsku. Podstawa rodziny tekstowej to polski Bielik, a filmy mają polski lektor.
Czym jest JevBench?
Otwarty benchmark dla modeli decyzyjnych: na wejściu stan i rubryka, na wyjściu typowana odpowiedź, po 1500 decyzji na system. Framework zbudował zespół Leanmcp, a najczęściej cytowaną tablicą wyników prowadzi BenchmarkHeaven.
Jak uruchomić basal-omni?
Potrzebujesz środowiska uv, PyTorcha pod CUDA 12.8 i silnika z release na GitHubie. Serwer startuje poleceniem basal-serve z nazwą modelu z Hugging Face i nasłuchuje pod endpointem /v1/systemone.
Źródła
- Strona projektu basal z opisem rodzin, sprzętem i wynikami Werdyktu, odczyt 19.10.2026: https://basal.si5.pl/en/
- Karta modelu basal-omni-1.0-ultra na Hugging Face (wyniki, obrazy, szybkość, kalibracja), odczyt 19.10.2026: https://huggingface.co/Remek/basal-omni-1.0-ultra
- Repozytorium rkinas/basal z README silnika 2.2 i listą kontrybutorów, odczyt 19.10.2026: https://github.com/rkinas/basal
- Wpis blogowy „basal 2.2 engine: calibration on your own data” z pomiarami kalibracji, 19.10.2026: https://basal.si5.pl/en/blog/basal-2-2/
- Tablica JevBench BenchmarkHeaven, rewizja v1.7.46 z 18.10.2026, odczyt 19.10.2026: https://benchmarkheaven.com/jev-models
- Framework i dataset JevBench (Leanmcp), preprint cytowany w danych tablicy, odczyt 19.10.2026: https://leanmcp.github.io/jevbench/
- Wątki Hacker News o basal-Omni z 18.10.2026 (punkty i komentarze), odczyt 19.10.2026: https://hn.algolia.com/api/v1/search?query=basal-omni
- Metadane modeli basal-2.0 i basal-omni (bazy Bielik i Gemma 4, licencja), Hugging Face API, odczyt 19.10.2026: https://huggingface.co/api/models?author=Remek