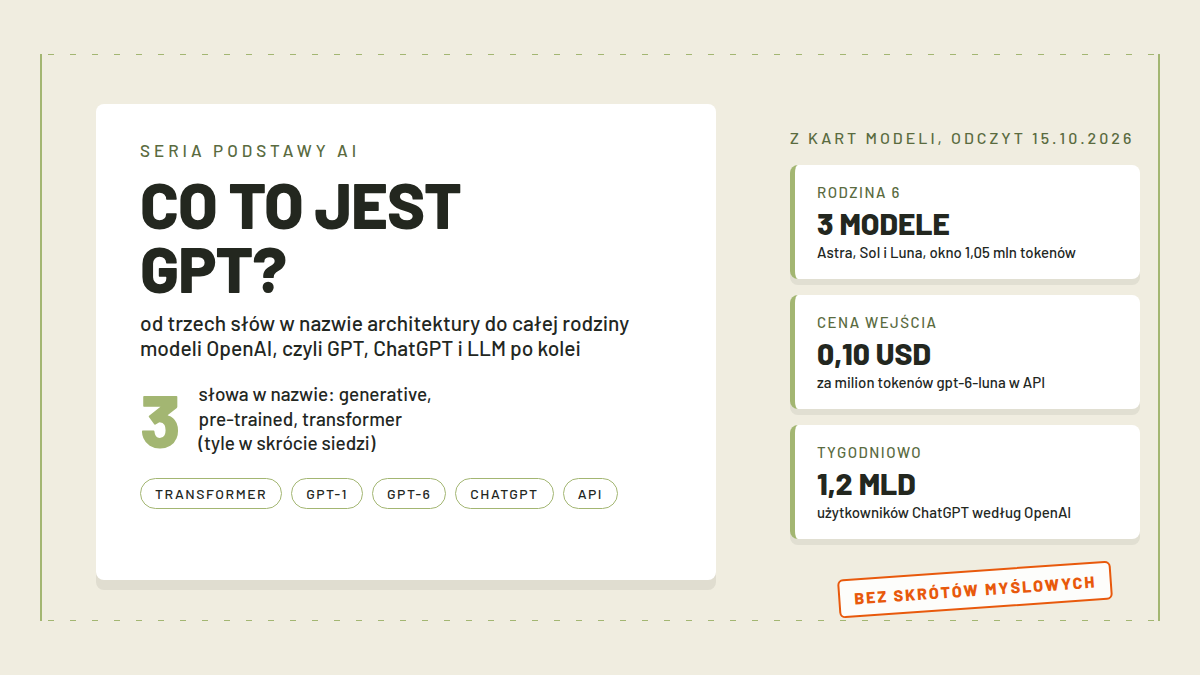
Wyobraź sobie koncern silnikowy. Konstruuje jednostki napędowe, które potem trafiają do różnych aut: miejskiego hatchbacka, rodzinnego kombi, dostawczaka. GPT działa na podobnej zasadzie, tylko zamiast mocy z paliwa sprzedaje zdolność pisania. To rodzina modeli językowych jednej firmy, OpenAI, z której korzysta czat ChatGPT, ale też dziesiątki innych aplikacji podłączonych przez API. Pytanie „co to jest GPT” pada w Google obok fraz o badaniu krwi, kryptowalutach i wersjach z imionami z kosmosu, bo skrót żyje własnym życiem. Jeśli szukasz porządku w tym zamieszaniu, dobrym miejscem startu jest nasze Podstawy AI, gdzie zbieramy hasła z tej dziedziny po polsku.
W tym tekście wyjaśniam, co dokładnie znaczy nazwa generative pre-trained transformer i dlaczego każde z trzech słów opisuje coś innego w budowie modelu. Potem idę chronologicznie: GPT-1 z 2018 roku, GPT-2, GPT-3, seria 3.5, GPT-4, GPT-5 z routerem i wreszcie seria 6 z GPT 6 Astrą, Solem i Luną. Osobno rozdzielam trzy pojęcia, które ludzie mieszają najczęściej: GPT, ChatGPT i LLM. Zamyka całość przegląd dzisiejszej oferty OpenAI, od darmowego planu czatu po cennik API, z liczbami odczytanymi dziś z żywych stron.
- Co to jest GPT: skrót rozłożony na trzy słowa
- Jak transformer zmienił robotę: uwaga i przetwarzanie równoległe
- Historia GPT: od GPT-1 z 2018 roku do serii 6
- GPT, ChatGPT i LLM: trzy pojęcia, które ludzie mieszają
- Rodzina produktów OpenAI dziś: czat, plany, API
- FAQ
Co to jest GPT: skrót rozłożony na trzy słowa
GPT to skrót od angielskiego generative pre-trained transformer. Po polsku najbliżej byłoby: transformer generujący, wytrenowany wcześniej. Wikipedia definiuje to tak: generative pre-trained transformer to rodzaj dużego modelu językowego szeroko używanego w czatach AI opartych na generowaniu treści. Model opiera się na architekturze zwanej transformerem, jest wstępnie trenowany na dużych zbiorach nieoznaczonych danych i potrafi tworzyć nową treść. Rozbijmy to zdanie na części.
Generative, czyli model, który coś tworzy
Część generative mówi o tym, co model robi po wytrenowaniu: generuje. Nie przypisuje zdjęć do kategorii spam i nie odpowiada zamkniętym tak lub nie. Buduje tekst token po tokenie, przewidując za każdym razem, co powinno wypaść dalej, jak człowiek dokańczający zdanie znane na pamięć. Raz napisze opis wycieczki, innym razem podsumuje umowę. Jeśli chcesz zobaczyć, jak działa ta loteria przewidywania i po co istnieje pokrętło zwane temperaturą, mamy osobny tekst o temperaturze w modelach AI.
Pre-trained, czyli najpierw nauka, potem praca
Część pre-trained opisuje kolejność procesu. Model najpierw przechodzi wstępne trenowanie na gigantycznym korpusie tekstu, w przypadku GPT-1 był to zbiór książek BookCorpus, i uczy się na tym etapie jednej prostej rzeczy: przewidywać kolejny token w zdaniu. Nikt wtedy nie etykietuje danych ręcznie, nauka idzie z samego tekstu. Dopiero po tym etapie przychodzi dostrajanie pod konkretne zadania albo, w przypadku czatu, trening z ocenami ludzi, znany jako RLHF. Zgodnie z Wikipedią modele GPT używają tylko części dekoderowej architektury transformera i są wstępnie trenowane dokładnie do przewidywania następnego tokena. Wstępne trenowanie samo w sobie było znane w uczeniu maszynowym dużo wcześniej, OpenAI było jednak pierwszą firmą, która połączyła tę technikę z transformerem i pokazała, że daje to model rozumiejący język na poziomie użytecznym.
Transformer, czyli architektura z pracy naukowej z 2017 roku
Trzecia część nazwy to nazwa architektury. Transformer powstał w Google i został opisany w pracy „Attention Is All You Need”, złożonej na serwer arXiv 12 czerwca 2017 roku. To sieć neuronowa, termin z osobna wyjaśniamy w tekście o sieciach neuronowych. Autorzy napisali wprost, czego się pozbyli: proponujemy nową prostą architekturę, Transformer, opartą wyłącznie na mechanizmach uwagi, całkowicie bez rekurencji i splotów. GPT bierze z tej architektury stronę dekodera, czyli tę odpowiedzialną za produkowanie kolejnych fragmentów tekstu.
Jak transformer zmienił robotę: uwaga i przetwarzanie równoległe
Starsze modele językowe, oparte na sieciach rekurencyjnych, czytały tekst po fragmencie, każdy kolejny tylko po poprzednim. Taka praca nie da się rozłożyć równolegle, bo element dwutysięczny zdania czeka na element tysięczny. Transformer zastąpił tę taśmę mechanizmem uwagi: każdy fragment tekstu przygląda się wszystkim pozostałym naraz i ocenia, które są dla niego istotne. Autorzy pracy z 2017 roku chwaili się wprost, że ich modele są lepsze jakościowo, bardziej równoległe i wymagają wyraźnie mniej czasu na trening. Gdy trening da się rozłożyć na tysiące układów pracujących jednocześnie, zaczyna działać prosta zależność: więcej mocy, więcej danych, lepszy model. Cała historia GPT od wersji 1 do 6 jest w dużej mierze historią korzystania z tej właściwości.
Uwaga ma też swój rachunek: jej koszty obliczeniowe i pamięciowe rosną kwadratowo wraz z długością sekwencji, jak podaje Wikipedia w artykule o transformerze. Dlatego długość rozmowy, którą model utrzymuje w pamięci, zwana oknem kontekstowym, przez lata była jedną z głównych liczb na kartach modeli. Dziś, zgodnie z dokumentacją OpenAI, modele GPT-6 mają okno 1 050 000 tokenów, a co ta liczba znaczy w praktyce, opisujemy w osobnym tekście o oknie kontekstowym.
Historia GPT: od GPT-1 z 2018 roku do serii 6
GPT-1 i GPT-2: dowód pomysłu i pierwsza ostrożność
Praca „Improving Language Understanding by Generative Pre-Training” ukazała się 11 czerwca 2018 roku i wprowadziła GPT-1, pierwszy model tej rodziny. Był dowodem, że wstępne trenowanie transformera na surowym tekście daje model, który po dostrajaniu wygrywa z systemami uczonymi na etykietowanych danych. Rok później, 14 lutego 2019, OpenAI pokazała GPT-2 z 1,5 miliarda parametrów, wytrenowanego na WebText, zbiorze 40 gigabajtów tekstu z 8 milionów stron internetowych. Ten model przeszedł do historii z innego powodu: firma odmówiła publikacji pełnych wag, powołując się na obawę przed złym użyciem technologii, i przez większość 2019 roku wypuszczała tylko mniejsze wersje. Pełny model trafił na zewnątrz w listopadzie, i ta ostrożność została w branży na stałe.
GPT-3: 175 miliardów parametrów i nauka z kilku przykładów
28 maja 2020 roku OpenAI opisała GPT-3, model autoregresyjny z 175 miliardami parametrów, dziesięć razy większy niż jakikolwiek wcześniejszy gęsty model językowy. Zmiana jakościowa była jednak w innym miejscu: GPT-3 wykonywał nowe zadania bez żadnego dostrajania, wystarczało kilka przykładów w samej treści zapytania. Autorzy napisali też coś, co dziś czyta się jak zapowiedź zgiełku: model generował próbki artykułów prasowych, których ludzcy oceniający nie potrafili odróżnić od napisanych przez ludzi. W tym samym roku model trafił do płatnego API, na którym programiści budowali produkty długo przed czatową rewolucją.
GPT-3.5 i ChatGPT: rodzina GPT staje się produktem
Do rodziny doszedł w 2022 roku model GPT-3.5, a na nim OpenAI wytrenowała ChatGPT, uruchomiony 30 listopada 2022 roku. Blogowe ogłoszenie mówi wprost: wytrenowaliśmy model zwany ChatGPT, który rozmawia w sposób konwersacyjny, i że ChatGPT jest dostrajany z modelu z serii GPT-3.5, skończonej na początku 2022 roku, z użyciem RLHF. Start wyglądał skromnie, darmowy podgląd badawczy, bez fajerwerków, i właśnie dlatego zaskoczył wszystkich, włącznie z OpenAI. Skokowy wzrost liczby użytkowników sprawił, że skrót GPT przestał być branżowym żargonem i wszedł do języka codziennego, a konkurencja zaczęła wypuszczać własne czaty na podobnych architekturach. Jak ta rozmowa wygląda od środka, opisujemy w tekście o tym, jak działa ChatGPT.
GPT-4: tekst i obrazki na wejściu
GPT-4 pojawił się 14 marca 2023 roku. Raport techniczny opisuje go jako duży model multimodalny, przyjmujący na wejściu obraz i tekst i oddający tekst, przy czym nadal jest to model oparty na transformerze, wytrenowany do przewidywania kolejnego tokena. Z tamtych czasów zapamiętano głównie liczby z testów: GPT-4 zdawał symulowany egzamin adwokacki na poziomie około dziesięciu procent najlepszych zdających, i wtedy ta liczba zrobiła większy szum niż jakakolwiek prezentacja produktu.
Co to jest GPT 5: system z routerem zamiast jednego mózgu
GPT-5 wystartował 7 sierpnia 2025 roku i po raz pierwszy nazwa wersji oznaczała coś innego niż pojedynczy model. Zgodnie z kartą systemową cytowaną w Wikipedii, GPT-5 to system zawierający szybki model o dużej przepustowości, głębszy model rozumujący i router działający w czasie rzeczywistym, który decyduje, którego z nich użyć, na podstawie rodzaju rozmowy, jej złożoności, potrzeby użycia narzędzi i jawnej intencji użytkownika. Ręczne wybieranie modelu z listy zniknęło, przynajmniej w teorii, bo router miał sam zgadywać, kiedy warto myśleć dłużej. W API do dziś dostępny jest snapshot o nazwie gpt-5-2025-08-07, z oknem 400 000 tokenów i wiedzą zakończoną na 30 września 2024. Dokumentacja OpenAI nazywa go dziś wprost naszym poprzednim modelem do kodowania, rozumowania i zadań agentowych i odsyła do GPT-6 Astry, co pokazuje, jak szybko w tej rodzinie robi się przeszłość.
Seria 6: GPT 6 Astra, Sol i Luna
W 2026 roku nazewnictwo rozjechało się na warianty z własnymi imionami. Zgodnie z Wikipedią GPT-6 jest rodziną dużych modeli językowych OpenAI: Astra trafiła do publiczności 4 września 2026, po jednodniowym podglądzie ograniczonym, Sol i Luna 22 września, a 7 października płatni użytkownicy dostali GPT-6 Instant z interfejsem Intelligent UI, dzień później poszedł na konta darmowe. Dokumentacja opisuje role bez owijania: Astra to nasz najbardziej zaawansowany model do najbardziej wymagającej pracy, używany do złożonego rozumowania, kodowania, obsługi komputera, researchu i dokumentów, Sol jest zbudowany do złożonego kodowania i pracy agentowej, a Luna to nasz najbardziej wydajny model do skupionych zadań o dużym wolumenie. Wszystkie trzy mają okno 1 050 000 tokenów, a wiedza kończy się 30 kwietnia 2026 dla Astry, 20 kwietnia dla Sol i 18 maja dla Luni. Jest też nowszy Sol, oznaczony gpt-6.1-sol, który według dokumentacji daje niemal wydajność Astry przy niższym koszcie. Jak Astra wypada w testach, opisujemy w osobnym materiale z opiniami o GPT 6 Astrze, tutaj zostaję przy faktach z kart modeli.
GPT, ChatGPT i LLM: trzy pojęcia, które ludzie mieszają
Trzy terminy z tego tekstu to trzy różne rzeczy. LLM, czyli duży model językowy, to cała kategoria technologiczna, do której należą modele wielu firm, nie tylko OpenAI, i wyjaśniamy to szerzej w tekście o tym, co to jest LLM. GPT to konkretna rodzina takich modeli, stworzona przez OpenAI, z własną historią wersji opisaną wyżej. ChatGPT to produkt, aplikacja czatowa, w której rodzina GPT siedzi jako silnik. Gdyby wrócić do motywu z początku tekstu: LLM to samochody w ogóle, GPT to rodzina silników jednego koncernu, ChatGPT to konkretne auto w salonie z tym silnikiem pod maską.
| Pojęcie | Co właściwie jest | Przykład użycia |
|---|---|---|
| LLM | Kategoria: duże modele językowe różnych firm | Claude, Gemini, GPT-6 |
| GPT | Rodzina modeli jednej firmy, OpenAI | gpt-6-astra w API |
| ChatGPT | Aplikacja czatowa oparta na silnikach GPT | czat na chatgpt.com |
To rozróżnienie ma praktyczny sens: czat użyjesz bez znajomości rodziny GPT, ale przez API płacisz już za konkretny model i różnice w cenniku robią się odczuwalne.
Rodzina produktów OpenAI dziś: czat, plany, API
Czat ChatGPT i plany Free, Go, Plus i Pro
Według bloga OpenAI z października 2026 roku ChatGPT używa co tydzień ponad 1,2 miliarda ludzi, a darmowe konta dostały wtedy model z serii GPT-6 wraz z interfejsem Intelligent UI, czyli odpowiedziami z interaktywnymi elementami, przyciskami i wykresami obok tekstu. Sprawdziłem dziś rano cennik na chatgpt.com, struktura planów wygląda tak: Free daje nielimitowane rozmowy tekstowe z GPT-6 z zastrzeżeniem zabezpieczeń przed nadużyciami, ale z limitami na pliki, obrazy, głos, deep research, pamięć i Codex. Go rozszerza te limity i ma adnotację o możliwych reklamach. Plus dokładuje zaawansowane modele rozumujące z serii GPT-6, projekty, zadania planowane i własne GPT-y. Pro, najdroższy plan, według pomocy OpenAI istnieje dziś w trzech poziomach: Pro 100 za 100 dolarów miesięcznie, Pro 200 za 200 dolarów i Pro 500 za 500 dolarów, przy czym tylko Pro 500 obejmuje tryby Ultrafast dla GPT-6 Astry i GPT-6.1 Sol. Kwot w złotych nie podaję, bo cennik rysuje je dopiero skryptami w przeglądarce i w moim odczycie tekstowym ich nie ma; darmowy plan opisuje szerzej nasz tekst o ChatGPT za darmo.
API dla programistów: ceny modeli z odczytu z 15.10.2026
Druga połowa rodziny żyje w API, gdzie płaci się za tokeny. Poniższa tabela pochodzi z cennika OpenAI odczytanego dziś, stawki w dolarach za milion tokenów, w trybie standardowym, przy kontekście do 272 tysięcy tokenów.
| Model | Wejście za 1M | Wyjście za 1M | Okno kontekstu |
|---|---|---|---|
| gpt-6-astra | 10 USD | 50 USD | 1,05 mln |
| gpt-6.1-sol | 2 USD | 10 USD | 1,05 mln |
| gpt-6-luna | 0,10 USD | 0,50 USD | 1,05 mln |
| gpt-5 | 1,25 USD | 10 USD | 400 tys. |
Rozstrzał cen w jednej rodzinie, sto razy między Astrą i Luną na wejściu, pokazuje, że nazwa GPT sama w sobie nic nie mówi o koszcie. Cennik przewiduje też tryby tańsze i droższe: Flex i Batch połowę stawek standardowych, Fast dwukrotność, a Ultrafast, dostępny dla Astry i 6.1 Sol, sześciokrotność. Za przetwarzanie w wybranych regionach, w tym w UE, dokłada się dziesięć procent dla modeli wydanych po 5 marca 2026 roku, a ceny promocyjne GPT-5.6 Sol obowiązują co najmniej do 21 listopada 2026. Obok głównych modeli w cenniku siedzą linie wyspecjalizowane: Daybreak do zadań cyberbezpieczeństwa i Rosalind do nauk o życiu, na razie w programie zaufanego dostępu dla wybranych organizacji badawczych.
Modele do kodowania: Codex i emerytura GPT-5.5
Trzecia gałąź to narzędzia programistyczne. W dokumentacji Codex na learn.chatgpt.com jest nota z 14 października 2026: GPT-5.5 przechodzi na emeryturę w południe czasu pacyficznego, konta Plus, Pro, Business, Enterprise i Edu mają wybierać GPT-6.1 Sol, a konta Free i Go model GPT-6 Lunę w aplikacji desktopowej. To dobry przykład zarządzania rodziną: stare wersje schodzą, pośrednie tanieją, na czele stoi wariant flagowy. Cennik czatu zalicza ograniczony dostęp do Codex nawet do planu darmowego.
FAQ
Czy GPT to to samo co ChatGPT?
Nie. GPT to rodzina modeli językowych OpenAI, czyli silniki, a ChatGPT to aplikacja czatowa zbudowana na tych silnikach. Model z rodziny GPT można spotkać też w API, w narzędziach do kodowania albo w produktach innych firm podłączonych przez interfejs programistyczny. Zdanie „używam GPT” zwykle znaczy więc „używam czatu ChatGPT”, ale zdanie „firma używa GPT w swojej aplikacji” już zwykle nie ma z czatem nic wspólnego.
Co to jest GPT 6 Astra?
Najmocniejszy model z serii GPT-6, opisany w dokumentacji OpenAI jako najbardziej zaawansowany model do najbardziej wymagającej pracy, z oknem kontekstu 1 050 000 tokenów i wiedzą zakończoną na 30 kwietnia 2026. Trafił do odbiorców 4 września 2026 roku, a jego wariant czatowy zasila rozumowanie w planie Pro. W API kosztuje 10 dolarów za milion tokenów na wejściu i 50 na wyjściu, według cennika z dnia publikacji.
Co to jest GPT 5.6 Sol?
Wariant rodziny GPT sprzed serii 6, widoczny w dzisiejszym cenniku API ze stawką promocyjną 4 dolary za milion tokenów na wejściu i 20 na wyjściu, obowiązującą co najmniej do 21 listopada 2026. Rodzina 5.6 dzieliła się na Sol, Terrę i Lunę, a we wrześniu 2026 zastąpiła ją seria 6, więc Sol 5.6 to dziś model schodzący, tańszy na okres przejścia.
Co to jest GPT w badaniu krwi?
To zupełnie inna dziedzina i częste źródło zamieszania w wynikach wyszukiwania. W medycynie GPT to nazwa genu, który koduje aminotransferazę alaninową, enzym badany przy ocenie wątroby; gen GPT leży według polskiej Wikipedii na chromosomie 8. Model językowy OpenAI nie ma z tym badaniem nic wspólnego, oba pojęcia dzielą tylko skrót.
Co to jest GPT Work?
Podpowiedzi Google podsuwają ten skrót często, a w produktach OpenAI widnieje on jako ChatGPT Work: funkcja pracy agentowej, która w cenniku z 15 października 2026 pojawia się z limitem na planie Free, rozszerzona w Plus i z dłuższymi sesjami w Pro. Osobnej strony opisującej to narzędzie od podstaw nie znalazłem w dokumentacji, więc rozpisuję się tylko do tego, co przeczytałem w cenniku.
Źródła
- Wikipedia, Generative pre-trained transformer, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Generative_pre-trained_transformer
- Wikipedia, Transformer (deep learning), odczyt 15.10.2026: https://en.wikipedia.org/wiki/Transformer_(deep_learning)
- Wikipedia, GPT-6, odczyt 15.10.2026: https://en.wikipedia.org/wiki/GPT-6
- Wikipedia, GPT-5, odczyt 15.10.2026: https://en.wikipedia.org/wiki/GPT-5
- Vaswani i in., Attention Is All You Need (arXiv 1706.03762), odczyt 15.10.2026: https://arxiv.org/abs/1706.03762
- Radford i in., Improving Language Understanding by Generative Pre-Training (GPT-1), odczyt 15.10.2026: https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- OpenAI, Better language models and their implications (GPT-2), odczyt 15.10.2026: https://openai.com/index/better-language-models/
- Brown i in., Language Models are Few-Shot Learners (GPT-3, arXiv 2005.14165), odczyt 15.10.2026: https://arxiv.org/abs/2005.14165
- OpenAI, Introducing ChatGPT, odczyt 15.10.2026: https://openai.com/index/chatgpt/
- OpenAI, GPT-4 Technical Report (arXiv 2303.08774), odczyt 15.10.2026: https://arxiv.org/abs/2303.08774
- OpenAI docs, model GPT-6 Astra, odczyt 15.10.2026: https://developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI docs, model GPT-6 Sol, odczyt 15.10.2026: https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI docs, model GPT-6 Luna, odczyt 15.10.2026: https://developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI docs, model GPT-6.1 Sol, odczyt 15.10.2026: https://developers.openai.com/api/docs/models/gpt-6.1-sol
- OpenAI docs, model GPT-5, odczyt 15.10.2026: https://developers.openai.com/api/docs/models/gpt-5
- OpenAI docs, cennik API, odczyt 15.10.2026: https://developers.openai.com/api/docs/pricing
- Cennik ChatGPT, odczyt 15.10.2026: https://chatgpt.com/pricing/
- Pomoc OpenAI, About ChatGPT Pro tiers, odczyt 15.10.2026: https://help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers
- OpenAI, GPT-6 and Intelligent UI for everyone, odczyt 15.10.2026: https://openai.com/index/gpt-6-for-everyone/
- learn.chatgpt.com, Models (dokumentacja Codex), odczyt 15.10.2026: https://learn.chatgpt.com/docs/models
- Wikipedia, Aminotransferaza alaninowa, odczyt 15.10.2026: https://pl.wikipedia.org/wiki/Aminotransferaza_alaninowa