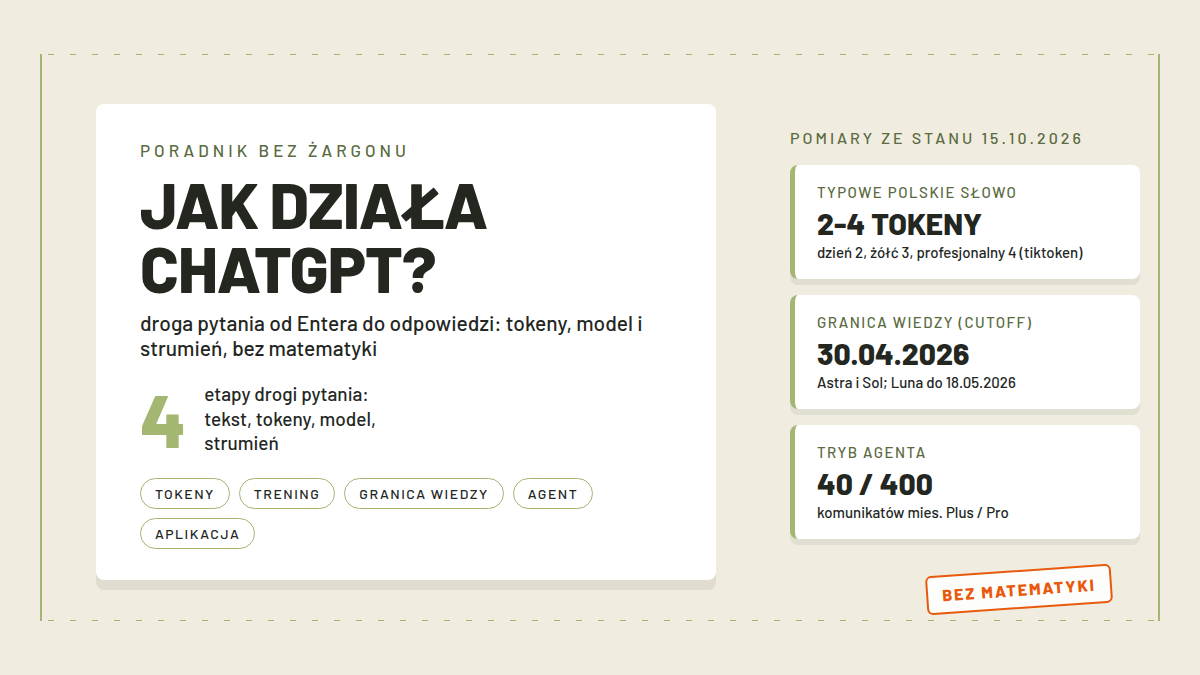
Pytanie wpisane do ChatGPT przechodzi cztery etapy, zanim zamieni się w gotową odpowiedź: tnie się na tokeny, trafia do modelu, ten przewiduje kolejne fragmenty po jednym, a aplikacja dosyła wyrazy na ekran w miarę ich powstawania. Ten tekst rozkłada tę drogę na części z datami i liczbami z dokumentacji OpenAI, bo fraza „jak działa chatgpt” ma w Google sporo odpowiedzi z jednozdaniową definicją, a praktyczne konsekwencje, na przykład to, że model ma datę graniczną wiedzy, w nich giną. Wyjaśniamy też, czym różni się rozmowa od treningu, czat od agenta i aplikacji oraz jak działa darmowe konto. Cała seria „AI bez żargonu” stoi na stronie Podstawy AI: 30 pytań i odpowiedzi.
- Najważniejsze informacje
- Od Entera do odpowiedzi: jak działa ChatGPT krok po kroku
- Trening a rozmowa: dwa tryby pracy modelu
- Skąd ChatGPT wie o świecie i gdzie kończy się jego wiedza
- Czat, agent czy aplikacja: trzy oblicza tego samego produktu
- Jak działa darmowy ChatGPT?
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Droga zapytania | Pytanie zamienia się w tokeny, model przewiduje kolejne fragmenty, odpowiedź płynie na ekran strumieniem |
| Token | Kawałek tekstu: znak, fragment słowa albo całe słowo; polskie „żółć” to 3 tokeny, „profesjonalny” 4 (nasz pomiar, 15.10.2026) |
| Tokeny rozumowania | Niewidoczne „myślenie” przed odpowiedzią; liczą się do zużycia jak zwykłe tokeny wyjścia |
| Granica wiedzy | GPT-6 Astra i GPT-6.1 Sol wiedzą do 30 kwietnia 2026, GPT-6 Luna do 18 maja 2026 (odczyt 15.10.2026) |
| Okno kontekstu | 1,05 mln tokenów w całej rodzinie GPT-6; tyle tekstu model widzi naraz w rozmowie |
| Czat a agent | Czat odpowiada w rozmowie; tryb agenta sam wykonuje zadania w wirtualnej przeglądarce, pauzując na potwierdzenia |
| Aplikacje | Web, iOS, Android, macOS i Windows to jeden produkt na tych samych modelach; rozmowy chodzą za kontem |
| Plan darmowy | 0 zł na modelu GPT-6 Luna; bez generowania obrazów, limity niepublikowane |
Od Entera do odpowiedzi: jak działa ChatGPT krok po kroku
Enter na komputerze albo ikona wysyłania na telefonie puszczają tekst w podróż, której pierwszy przystanek nazywa się tokenizer. To program tnący tekst na kawałki zwane tokenami, a według centrum pomocy OpenAI token może reprezentować pojedynczy znak, część słowa, całe słowo albo interpunkcję, i na podział wpływają też spacje. Dla angielskiego dokumentacja podaje szacunki: jeden token to około czterech znaków albo trzy czwarte słowa, czyli sto tokenów to mniej więcej siedemdziesiąt pięć słów. Te liczby nie są prawem, tylko miarą przybliżoną, i dla innych języków relacja wygląda inaczej.
Po polsku wychodzi drożej. Zmierzonym u nas przykładem niech będzie zdanie „Jak działa ChatGPT? Model przewiduje kolejne fragmenty tekstu.”: w tokenizerze o kodowaniu o200k_base, liczonym biblioteką tiktoken OpenAI, dostaje szesnaście tokenów, a jego angielski odpowiednik piętnaście. Pojedyncze słowa rozpadają się jeszcze wyraźniej, bo „dzień” to dwa tokeny, „żółć” trzy, „rozsądnie” i „profesjonalny” po cztery. Starsze kodowanie o nazwie cl100k_base policzyło to samo polskie zdanie na dziewiętnaście tokenów, więc podział zależy też od wersji tokenizera. Zastrzeżenie dla rzetelności: którego dokładnie kodowania używa rodzina GPT-6, OpenAI nie publikuje, więc nasz pomiar traktuj jako obraz współczesnego mechanizmu, nie oficjalną specyfikację. Tokeny liczą się w dwóch miejscach naraz: wchodzą do okna kontekstu, czyli limitu tego, co model widzi, i w API są jednostką rozliczeniową.
Właściwy model nie czyta słów, tylko ciąg tokenów, i w każdym kroku robi jedno: wylicza, jaki token najpewniej pojawi się następny, dokleja go i powtarza procedurę, aż do kropki. Zanim twoje pytanie dotrze do modelu, aplikacja dokłada własne instrukcje, na przykład o roli asystenta i granicach tematów; dokumentacja API opisuje to rolami komunikatów, w których polecenia aplikacji mają pierwszeństwo przed wiadomością użytkownika. Długa odpowiedź to setki takich obiegów zrobionych w ułamkach sekund, a dokładniej ten mechanizm, bez matematyki, rozłożyliśmy w pierwszym tekście serii, podstawach LLM. Dokumentacja OpenAI zastrzega wprost, że generowanie jest niedeterministyczne: to samo pytanie zadane dwa razy może dostać dwie różne odpowiedzi, i nie jest to usterka, tylko własność metody. Modele rozumujące, do których należy cała rodzina GPT-6, robią przy okazji coś jeszcze: przed widoczną odpowiedzią generują tokeny rozumowania, których na ekranie nie widać, a które liczą się do zużycia jak zwykłe tokeny wyjścia. Dlatego przy trudniejszym pytaniu czat milczy o kilka sekund dłużej, zanim zacznie pisać.
Że odpowiedź pojawia się partiami, a nie w jednym kawałku, zawdzięczasz strumieniowaniu. W API domyślnym trybem jest wygenerowanie całej odpowiedzi przed jej odesłaniem, ale tryb streamingu, oparty na zdarzeniach serwera, dosyła początek wyniku wtedy, gdy reszta dopiero powstaje. Aplikacja ChatGPT korzysta z tego samego pomysłu, stąd litery i wyrazy dopisują się na żywo. OpenAI nie publikuje prędkości generowania w słowach na sekundę; ta zależy od modelu, ustawionego wysiłku rozumowania i długości odpowiedzi, więc każdy konkretny numer z internetu jest czyimś domysłem.
Model nie pamięta rozmowy w sobie. Jest bezstanowy, a to aplikacja przy każdej twojej wiadomości odsyła mu do przetworzenia całą dotychczasową wymianę, od pierwszego pytania aż po bieżący akapit, doklejoną do nowego wpisu. Stąd bierze się wrażenie ciągłości: model za każdym razem czyta rozmowę od początku, choćby liczyła już setną wiadomość. Konsekwencja jest praktyczna i widoczna gołym okiem, bo w długiej konwersacji każda kolejna odpowiedź startuje z coraz większym workiem tokenów wejścia, więc dłużej trwa i bliżej jest wyczerpania okna kontekstu.
Trening a rozmowa: dwa tryby pracy modelu
Model nauczył się języka dawno przed twoim pierwszym pytaniem, w treningu przeprowadzonym raz i zamkniętym. Najpierw miliardy zdań z zakrytym dalszym ciągiem, potem dostrajanie do roli asystenta i oceny ludzkie, a efektem są parametry, po angielsku weights, które podczas rozmowy są zamrożone. Kiedy więc piszesz w czacie, model pracuje w trybie użycia: nic się w nim wtedy nie doucza, a odpowiedzi w poniedziałek i w piątek wychodzą z tych samych wag. Jeśli model coś rozumie źle albo ma dziurę w wiedzy, powtórzy to jutro i za miesiąc, bo między sesjami nie ma procesu poprawiania. Z rozmowy nie wynika więc nauka na bieżąco, tylko tekst, i to on jest całym materiałem, z którego model w danym momencie korzysta.
Co innego zostaje po zamknięciu karty. Rozmowy zapisują się w historii konta: można je szukać, archiwizować i usuwać, a trwałe skasowanie dociera do systemów w ciągu trzydziestu dni, co opisaliśmy szczegółowo w tekście o historii rozmów w ChatGPT. Osobno działa pamięć, w której ChatGPT zbiera trwałe fakty o tobie i twoich preferencjach: to notatki i profil trzymane przy koncie, a nie zmiana w samym modelu, i tę różnicę rozkładamy w rozbiórce pamięci ChatGPT. Historia trzyma to, co powiedziałeś w rozmowach, pamięć fakty o tobie na dłużej, i żadna z nich nie przepisuje wag.
Trzeci wątek to udostępnianie rozmów do przyszłego treningu. W kontach prywatnych decyduje o tym ustawienie w ścieżce Settings, Data controls, Improve the model for everyone: po wyłączeniu nowe rozmowy nie trafiają do treningu modeli, a w planach firmowych rezygnacja jest domyślna. Nawet gdy rozmowa zostanie użyta, zasili trening przyszłych wersji, więc bieżąca wersja nie zmieni się pod twoim wpływem ani o minutę.
Skąd ChatGPT wie o świecie i gdzie kończy się jego wiedza
Model nie ma pod spodem encyklopedii ani stałego okna na świat. Wie tyle, ile wchłonął z tekstów treningowych, a ta wiedza ma datę graniczną zwaną cutoff, podawaną w kartach modeli. Według stanu na piętnasty października 2026 rodzina GPT-6 wygląda tak: GPT-6 Astra i GPT-6.1 Sol kończą wiedzę trzydziestym kwietnia 2026, GPT-6 Luna osiemnastym maja 2026. Dziś, w połowie października, te modele znają świat sprzed niecałego pół roku.
Wszystko późniejsze model zna tylko wtedy, gdy dostanie to w rozmowie. Wklejony artykuł, wgrany plik, wynik wyszukiwania: taki materiał trafia do okna kontekstu, które w całej rodzinie GPT-6 ma milion pięćdziesiąt tysięcy tokenów, i w tym oknie model widzi go w całości. Okno to pojemność na jeden raz, nie trwała pamięć, więc bardzo długa rozmowa potrafi wypchnąć swój początek poza to, co model jeszcze widzi. Praktyczne wnioski są dwa: o sprawy sprzed daty granicznej można pytać wprost, a przy świeższych lepiej poprosić o wyszukiwanie albo podać materiał do przeczytania.
Niejednoznaczność bywa tu podchwytliwa, bo model nie oznacza odpowiedzi etykietą „wiem to z treningu” ani „zgaduję po dacie granicznej”. Zapytany o wydarzenie sprzed cutoffu, odpowiada z tego, co wchłonął; zapytany o późniejsze bez podpiętego wyszukiwania i bez materiału, też odpowie, płynnie i pewnym tonem, choć będzie musiał wygenerować coś z niczego. Dlatego przy dacie, cenie albo wyniku, gdzie liczy się aktualność, najpewniej jest podać źródło w samym pytaniu, zamiast zakładać, że czat wie.
Czat, agent czy aplikacja: trzy oblicza tego samego produktu
Zwykły czat to pętla pytań i odpowiedzi: model przewiduje tokeny, dopisuje je pod twoją wiadomością i czeka na następną. Od siódmego października 2026 odpowiedzi potrafią przybierać szerszą formę, bo wraz z GPT-6 weszło do ChatGPT tzw. Intelligent UI: obok tekstu pojawiają się diagramy, porównania ustawione obok siebie i narzędzia używane bezpośrednio w rozmowie, jak kalkulator. Mechanizm pod spodem się nie zmienia, zmienia się sposób podania wyniku, a pętla przewidywania tokenów jest ta sama, jaka napędiała czat w dniu premiery, trzydziestego listopada 2022 roku.
Tryb agenta to inny tryb pracy niż czatowanie. Włącza się go z menu narzędzi albo wpisując /agent w polu pisania, po czym opisujesz zadanie, na przykład znalezienie terminu i rezerwacji, a agent wykonuje je krok po kroku: planuje, używa narzędzi i reaguje na ich wyniki, a strony internetowe widzi przez zrzuty ekranu swojej wirtualnej przeglądarki. Po drodze pauzuje, żeby doprecyzować albo potwierdzić działanie, a przy logowaniu na stronach oddaje ci sterowanie przeglądarki, żeby nie dotykać twojego hasła. Na niektórych stronach pracuje w trybie nadzorowanym, w którym trzeba mu się przyglądać. W wynikach agent cytuje źródła linkami lub zrzutami. To nadal model przewidujący kolejne tokeny, ale zapętlony z narzędziami, i ta pętla rozróżnia agenta od czatu.
Skończone zadanie da się też zapętlić w czasie: ikoną zegara ustawiasz powtórzenie codzienne, cotygodniowe albo comiesięczne, a wszystkie harmonogramy przeglądasz pod adresem chatgpt.com/schedules. Sprzątanie po agencie wygląda jak w zwykłej rozmowie, bo zrzuty i historia przeglądania wiszą przy konwersacji do momentu jej usunięcia, a skasowanie rozmowy usuwa je również z systemów, w ciągu dziewięćdziesięciu dni.
Aplikacja to pojęcie jeszcze prostsze, choć bywa mylone z modelem. ChatGPT działa w przeglądarce, na iOS, na Androidzie oraz w aplikacjach na macOS i Windows, i każda z tych wersji jest klientem tego samego produktu na tych samych modelach. Konto spina je w całość, więc rozmowę zaczętą na komputerze dokończysz w telefonie. Stan całego produktu, plany i nowości zbiera nasz przewodnik po ChatGPT.
Jak działa darmowy ChatGPT?
Konto darmowe to pełny produkt, nie demo: cennik z trzynastego października 2026 przypisuje planowi Free model GPT-6 Luna w standardowej szybkości pracy. Bez zakładania konta działa też osobny czat w przeglądarce, w którym rozmowa nie zapisuje się do żadnej historii. Mechanika odpowiedzi jest w obu przypadkach ta sama co na planach płatnych: tokeny, przewidywanie, strumień, więc „darmowy” oznacza ograniczenia w narzędziach i limitach, a nie wolniejszy albo inny rodzaj silnika.
Czego na Free nie ma, to trzy rzeczy:
- generowania obrazów,
- publikowanych limitów wiadomości,
- comiesięcznych kredytów na API.
Limity objawiają się w praktyce komunikatem o odczekaniu albo zachętą do planu płatnego, a nie tabelą liczb. Cennik zaznacza przy okazji, że nowości wdrażają się falami i aplikacja na komputer bywa na czele kolejki, więc krótkotrwała różnica między urządzeniami nie jest błędem konta. Ile który plan kosztuje i co dokładnie dostaje, rozpisaliśmy w tekście o darmowym GPT-6.
Najczęstsze pytania
Jak działa agent ChatGPT?
Włączasz go z menu narzędzi albo wpisując /agent, opisujesz zadanie, a agent wykonuje je krok po kroku w wirtualnej przeglądarce, pauzując na potwierdzenia i cytując źródła. Limit to 40 komunikatów miesięcznie na planie Plus i 400 na Pro; plan darmowy trybu agenta nie obejmuje. Działa w przeglądarce, na telefonach i w aplikacjach na komputery.
Jak działa aplikacja ChatGPT?
Aplikacja to klient, nie osobny model: web, iOS, Android oraz wersje na macOS i Windows korzystają z tego samego konta i tych samych modeli, a rozmowy synchronizują się między urządzeniami. Odpowiedzi generuje się identycznie jak w przeglądarce. Do pracy offline nie służy, bo model liczy na serwerach OpenAI, nie na twoim urządzeniu.
Jak działa projekt w ChatGPT?
Projekt trzyma razem rozmowy, pliki i instrukcje jednej sprawy, dzięki czemu ChatGPT ma wspólny kontekst do pracy ciągłej. Zakładasz go przyciskiem New project w pasku bocznym, a pamięć da się ograniczyć do kontekstu samego projektu.
Czym jest i jak działa ChatGPT?
ChatGPT to produkt z interfejsem, aplikacjami i planami, zbudowany na modelach rodziny GPT: mechanizm pracy to zamiana tekstu na tokeny i przewidywanie kolejnych fragmentów po jednym. Model jest silnikiem, ChatGPT samochodem.
Co działa jak ChatGPT?
Na tym samym mechanizmie dużego modelu językowego pracują Claude od Anthropic i Gemini od Google, Copilot od Microsoftu, Perplexity, a także dziesiątki mniejszych czatów. Różnią się danymi treningowymi, narzędziami i cenami, nie zasadą działania.
Źródła
- OpenAI Help Center, Understanding and counting tokens (odczyt 15.10.2026): https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- OpenAI, lista modeli, karty GPT-6 Astra, GPT-6.1 Sol i GPT-6 Luna: cutoffy, okna kontekstu, narzędzia (odczyt 15.10.2026): https://platform.openai.com/docs/models
- OpenAI Help Center, ChatGPT agent: tryb pracy, limity, zrzuty ekranu, prywatność (odczyt 15.10.2026): https://help.openai.com/en/articles/11752874-chatgpt-agent
- OpenAI, Text generation, przewodnik po generowaniu tekstu w API: niedeterminizm, tokeny rozumowania (odczyt 15.10.2026): https://platform.openai.com/docs/guides/text-generation
- OpenAI, Streaming API responses (odczyt 15.10.2026): https://platform.openai.com/docs/guides/streaming
- OpenAI Help Center, Projects in ChatGPT (odczyt 15.10.2026): https://help.openai.com/en/articles/10169521-projects-in-chatgpt
- OpenAI Help Center, Finding your chats, projects, and files in ChatGPT (odczyt 15.10.2026): https://help.openai.com/en/articles/10056348-finding-your-chats-projects-and-files-in-chatgpt
- OpenAI Help Center, ChatGPT release notes, wpis z 7.10.2026 o GPT-6 i Intelligent UI (odczyt 15.10.2026): https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- Własny pomiar tokenizacji polskiej: biblioteka tiktoken 0.14.0 (OpenAI), kodowania o200k_base i cl100k_base, 15.10.2026
- Cennik ChatGPT, plan Free na modelu GPT-6 Luna (odczyt 13.10.2026, za naszym tekstem o darmowym ChatGPT): https://learn.chatgpt.com/codex/pricing