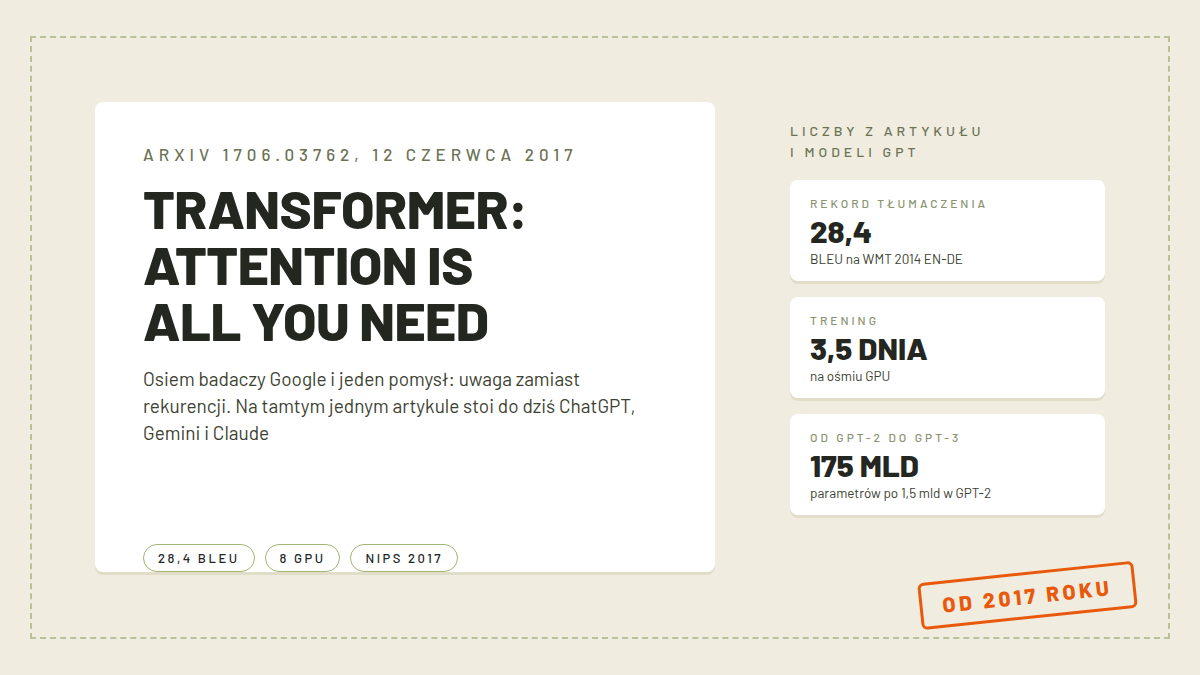
Transformer to sposób, w jaki zbudowana jest większość sztucznej inteligencji, z której korzystasz na co dzień. To nie żaden konkretny model, tylko architektura, czyli sprawdzony projekt sieci neuronowej, z którego składa się ChatGPT, Gemini, Claude i tysiące mniejszych modeli. Nazwa pochodzi od artykułu Attention Is All You Need, opublikowanego w arXiv 12 czerwca 2017 przez ośmiu badaczy Google, a cała konstrukcja stoi na jednym mechanizmie: uwagi, po angielsku attention. Zanim pojawił się transformer, sieci uczyły się języka słowo po słowie, jak ktoś, kto czyta zdanie przez rurkę od kartki po wydruku. Po jego pojawieniu się mogły patrzeć na całe zdanie naraz.
W tym tekście idę chronologicznie, bo ta historia najlepiej tłumaczy sama siebie. Najpierw pokażę świat sprzed 2017 roku, czyli sieci RNN i LSTM z ich bolączkami. Potem rozbiorę sam artykuł, a mechanizm self-attention wyjaśnię na polskim zdaniu z zaimkiem. Dalej pokażę, dlaczego równoległość obliczeń zmieniła ekonomię treningu, jak od jednego tekstu doszło do GPT, Claude i Gemini, i ile ta uwaga kosztuje, bo z tej ceny wynikają okna kontekstowe. Jeśli dopiero wchodzisz w temat, mapa podstawowych haseł czeka w Podstawach AI.
- Najważniejsze informacje
- Zanim pojawił się transformer: RNN i LSTM
- Attention Is All You Need: osiem osób i jeden pomysł
- Self-attention po ludzku
- Dlaczego trening nagle przyspieszył
- Od transformera do GPT, Claude i Gemini
- Cena uwagi: okna kontekstowe i ich koszt
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Praca założycielska | artykuł Attention Is All You Need, arXiv 1706.03762, zgłoszony 12.06.2017, wydany też na konferencji NIPS 2017 (dziś NeurIPS) |
| Autorzy | 8 badaczy Google: Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Łukasz Kaiser, Polosukhin |
| Rdzeń pomysłu | sam mechanizm uwagi self-attention, bez rekurencji i bez konwolucji |
| Pierwsze zadanie | tłumaczenie maszynowe: 28,4 BLEU na WMT 2014 EN-DE, ponad 2 BLEU nad dotychczasową czołówką |
| Dlaczego wygrał | trening równoległy na GPU, szybszy o rzędy wielkości, dalekie zależności w jednym kroku |
| Skalowanie | od 165 mln parametrów w 2017 do setek miliardów w kolejnych latach |
| Gdzie dziś jest | GPT, BERT, ChatGPT, Gemini, Claude, Vision Transformer, generatory obrazu i wideo |
| Główny koszt | uwaga rośnie kwadratowo z długością tekstu, stąd okna kontekstowe i cenniki za tokeny |
Zanim pojawił się transformer: RNN i LSTM
Przez dekadę przed transformerami językiem sieci neuronowych rządziły sieci rekurencyjne, RNN. Pomysł brzmi rozsądnie: czytaj tekst element po elemencie i po każdym słowie aktualizuj wewnętrzny stan, który ma pamiętać, co było wcześniej. Tylko że ten stan ma fizyczny limit. Wikipedia w haśle o transformerach zapisuje to wprost: problem zanikającego gradientu zostawia w praktyce stan sieci na końcu długiego zdania bez precyzyjnej informacji o wcześniejszych tokenach. Sieć deklarująca pamięć gubiła początek zdania.
Próbnym lekarstwem był LSTM, długa pamięć krótkotrwała, opisana w raporcie technicznym z 1995 roku i opublikowana formalnie w 1997. To wciąż sieć rekurencyjna, ale z bramkami, które uczą się decydować, co zapisać do pamięci, a co wyrzucić, i przez dwie dekady był to standard pracy z długimi sekwencjami. Bramki pomogły, ale dwóch rzeczy nie ruszyły. Przetwarzanie szło dalej krok po kroku, bo LSTM z definicji nie umie pracować na wszystkich słowach naraz, a połączenie słów odległych o dwadzieścia pozycji wymagało dwudziestu kroków pośrednich, a im więcej takich kroków, tym trudniej sieci nauczyć się zależnych od nich decyzji.
Że problem był realny, pokazuje historia Google Tłumacza. W 2016 roku Google przebudowało go na model GNMT, gdzie koder i dekoder to po osiem warstw dwukierunkowego LSTM, a przebudowa zajęła dziewięć miesięcy. Lepiej niż statystyczne tłumaczenie, ale podłoga została ta sama: sekwencyjność. Ciekawe, że uwaga wcale nie była wtedy nowością, bo do tłumaczenia maszynowego wprowadzili ją Bahdanau z zespołem w 2014 roku, tyle że doklejoną do sieci rekurencyjnych, a nie zamiast nich.
Attention Is All You Need: osiem osób i jeden pomysł
W karcie arXiv 1706.03762 stoi ośmioro autorów: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser i Illia Polosukhin, wszyscy wtedy z Google. Vaswani kierował pracami, Gomez był wtedy stażystą i wspominał, że w noc składania artykułu z Vaswanim nie poszli spać do rana, a on sam dosypiał potem parę godzin w jednej z małych sal konferencyjnych. Artykuł trafił do arXiv 12 czerwca 2017 roku, a finałem była konferencja NIPS 2017, dziś znana jako NeurIPS, z pozycją w tomie Advances in Neural Information Processing Systems 30.
Tytuł to nie poetycki wybryk, tylko dokładnie jedna hipoteza. Wcześniej każdy najlepszy model doklejał uwagę do rekurencji albo konwolucji, a Uszkoreit podejrzewał, że sama uwaga wystarczy do tłumaczenia, co według zapisu w Wikipedii było wtedy poglądem przeciw konwencji, sceptyczny był nawet jego ojciec, znany językoznawca komputerowy Hans Uszkoreit. Samą nazwę wymyślił Uszkoreit, a jak opowiadał później Vaswani, pierwsza propozycja Attention Net „nie brzmiała zbyt ekscytująco”, więc zostało przy transformerze, bo zespół transformował reprezentacje. Model oryginalny to koder-dekoder, który w materiałach konferencji NIPS figuruje jako pojedynczy model o 165 mln parametrów, liczba, która dziś brzmi jak błąd zaokrąglenia.
Wyniki rozstrzygnęły spór szybciej, niż ktokolwiek się spodziewał. Na zadaniu tłumaczenia z angielskiego na niemiecki z WMT 2014 model osiągnął 28,4 BLEU, bijąc dotychczasowe najlepsze wyniki, łącznie z systemami ensemble, o ponad 2 BLEU, a na tłumaczeniu na francuski ustawił nowy rekord 41,8 BLEU, trenując się 3,5 dnia na ośmiu GPU. Autorzy pisali w abstrakcie wprost o modelu „more parallelizable”, wymagającym znacznie mniej czasu treningu, a blog Google Research podsumował efekt jako przyspieszenie treningu do rzędu wielkości. Z architektury zamiast rekurencji i konwolucji została wyłącznie uwaga, w wersji wielogłowej, bo oryginalny model liczył osiem niezależnych głów atencji naraz.
Self-attention po ludzku
Sam mechanizm da się opisać jednym zdaniem: każde słowo w zdaniu patrzy na wszystkie pozostałe słowa i waży, jak bardzo każde z nich jest ważne dla jego własnego znaczenia. Blog Google Research pokazuje to na przykładzie zdania „I arrived at the bank after crossing the river”. Czy „bank” to brzeg, czy bank finansowy, rozstrzyga słowo „river”, i transformer uczy się, żeby przy przetwarzaniu „bank” przywiązywać dużą wagę właśnie do „river”, jednym krokiem, niezależnie od tego, jak daleko oba słowa od siebie stoją. Siła tej relacji zapisuje się jako tzw. attention score, a nowe znaczenie słowa powstaje jako średnia ważona reprezentacji wszystkich słów z tymi wagami.
W praktyce każdy token dostaje trzy wektory: query (czego szuka), key (co oferuje) i value (co przekazuje dalej), a uwaga porównuje query jednego tokena z key wszystkich pozostałych. Tokeny są tu konieczne, bo sieć nie widzi słów, tylko liczby; jak dochodzi do tej zamiany, opisałem osobno w tekście o tym, co to jest token AI. AWS porównuje to do słuchania kogoś w hałaśliwym pokoju: mózg wzmacnia jeden głos i wycisza resztę, a self-attention robi to samo z tokenami.
Najlepiej czuje się to na zaimkach, i tu polszczyzna ma zresztą ułatwienie. Weź zdanie „Zwierzę nie przeszło przez ulicę, bo było zbyt zmęczone”. Kto był zmęczony? Człowiek odpowiada bez zastanowienia, a model musi połączyć „było” ze „zwierzęciem”, bo gdyby chodziło o ulicę, zdanie brzmiałoby „bo była zbyt zmęczona”. Po angielsku trudniej, bo „it” nie ma rodzajów; dokładnie takie zdanie, „The animal didn’t cross the street because it was too tired”, posłużyło za przykład Jayowi Alammarowi w Illustrated Transformer, a blog Google pokazywał, że transformery tłumaczą podobny zaimek na francuski poprawnie tam, gdzie ówczesny Google Tłumacz się mylił, i że widać to na mapie wag uwagi, gdzie jedna z ośmiu głów wskazuje właściwy rzeczownik.
Dlaczego trening nagle przyspieszył
Różnica wobec RNN jest mechaniczna, a nie tylko jakościowa. Sieć rekurencyjna musi policzyć krok 400 po kroku 399, więc tysiąc kroków to tysiąc kolejnych zależnych operacji, jedna za drugą. Transformer liczy wagi uwagi dla wszystkich pozycji sekwencji jednocześnie, bo żadna pozycja nie czeka na wynik poprzedniej, a takie równoległe obliczenia to dokładnie to, do czego zaprojektowano GPU i TPU. Blog Google Research nazywa to wprost: sekwencyjna natura RNN utrudnia pełne wykorzystanie układów stworzonych do przetwarzania równoległego. Do tego dochodzi odległość logiczna, bo zamiast dwudziestu kroków między „bank” a „river” jest jeden, przez co modele dalekich zależności uczą się łatwiej.
Ta zmiana odwróciła ekonomię całej dziedziny. Skoro trening zamiast miesięcy trwał dni i skoro dał się skalować przez dokładanie kolejnych układów, przestał liczyć się sprytny projekt pojedynczej sieci, a zaczął liczyć się rozmiar. Tu transformer trafił w najczulsze miejsce uczenia maszynowego, bo im większy model i im więcej danych, tym lepsze wyniki, co jest głównym wątkiem tego, jak AI się uczy. NVIDIA w swoim omówieniu przypomina skok z laboratorium w Monachium, gdzie zespół w 18 miesięcy przeszedł od RNN z 90 mln parametrów do transformera z 567 mln, i to był dopiero początek krzywej.
Od transformera do GPT, Claude i Gemini
Nazwa GPT to nie przypadek, tylko skrót od generative pre-trained transformer, czyli wstępnie wytrenowany transformer generatywny. Już w 2018 roku OpenAI wzięło z artykułu tylko część dekodera, wyrzuciło koder i zaczęło trenować taki model na przewidywanie kolejnego tokena w sekwencji, a seria GPT szybko została stanem sztuki w generowaniu języka, jak zapisuje Wikipedia. Tego samego roku drugi zespół Google zrobił odwrotnie, wziął sam koder i zbudował BERT, który ustawił 11 nowych rekordów i wszedł pod spód wyszukiwarki Google w październiku 2019. Te dwie gałęzie, dekoderowa i koderowa, to do dziś główne nurty tej samej architektury.
Skalowanie zrobiło z transformera fundament branży. GPT-2 miał 1,5 mld parametrów, GPT-3 już 175 mld, a kolejne generacje poszły w setki miliardów, aż pod koniec 2022 roku ChatGPT, czyli dostrajany wariant GPT-3.5, trafił do konsumentów i odpalił całą obecną falę dużych modeli językowych, o których pisałem osobno w tekście o tym, czym jest LLM. Ta sama architektura wyszła poza tekst, bo Vision Transformer tnie obraz na kawałki i traktuje je jak tokeny, a generatory obrazu i wideo, od DALL-E po Sora, liczą uwagę między tokenami różnych modalności. Claude i Gemini to ten sam rodowód, różnią się tym, kto i na czym wytrenował swoją wersję dekoderów.
Cena uwagi: okna kontekstowe i ich koszt
Transformer nie jest darmowy i jedna własność decyduje o wszystkim, co widzisz w cennikach. Standardowa uwaga porównuje każdy token z każdym, więc koszt obliczeń i pamięci rośnie kwadratowo z długością sekwencji, jak zapisuje Wikipedia; czterokrotnie dłuższa rozmowa to szesnaście razy więcej porównań. Dlatego nie ma modeli czytających całe księgi naraz, tylko okna kontekstowe, czyli górne limity tokenów, które model przetworzy w jednym przebiegu; jak to wygląda w praktyce poszczególnych usług, opisałem osobno w tekście o oknie kontekstowym.
To tłumaczy, dlaczego dłuższe konteksty są droższe i dlaczego spora część badań idzie dziś w optymalizacje samej uwagi, żeby kwadratowy koszt ugryźć. Gdy w opisie modelu czytasz o kontekście 128 tysięcy albo milionie tokenów, to nie jest oznaka wielkiej mądrości, tylko twardy kompromis między architekturą z 2017 roku a fizyką liczenia, i taki zostanie, dopóki ktoś nie pokaże konstrukcji, która uwagę zastąpi równie dobrze, a taniej. Przez osiem lat nikt tego nie zrobił, więc wszystkie duże modele, które znasz, wciąż stoją na tamtym jednym artykule.
FAQ
Co to jest transformer w AI?
To architektura sieci neuronowej oparta w całości na mechanizmie uwagi, opublikowana przez Google w 2017 roku w artykule Attention Is All You Need. Zamiast czytać tekst krok po kroku, jak robiły to sieci RNN i LSTM, transformer patrzy na wszystkie tokeny naraz i waży relacje między nimi, dzięki czemu trening da się równoleglić na GPU. Tą samą receptą zbudowane są dziś praktycznie wszystkie duże modele językowe, od GPT po Gemini i Claude, a także modele wizyjne i generatory obrazu.
Co to jest attention is all you need?
To tytuł artykułu naukowego z 12 czerwca 2017 roku, w którym ośmioro badaczy Google opisało architekturę transformera. Tytuł jest jednocześnie tezą: do dobrego modelowania języka wystarczy sam mechanizm uwagi, bez rekurencji i bez konwolucji, które były wtedy standardem. Artykuł ustawił rekordy w tłumaczeniu maszynowym WMT 2014, 28,4 BLEU dla angielskiego na niemiecki i 41,8 BLEU dla angielskiego na francuski, a autorzy rozeszli się później po branży, jak Aidan Gomez, dziś szef firmy Cohere budującej usługi językowe na transformerach.
Dlaczego transformer wygrał z wcześniejszymi sieciami?
Z trzech powodów, które napędzają się nawzajem. Po pierwsze, liczy wszystko równolegle, więc trening na GPU i TPU jest szybszy o rzędy wielkości niż sekwencyjny trening RNN. Po drugie, łączy odległe słowa jednym krokiem uwagi zamiast kilkunastoma krokami stanu ukrytego, więc lepiej łapie dalekie zależności w zdaniu. Po trzecie, świetnie się skaluje, a większy model na większych danych daje lepsze wyniki, co zamieniło uczenie maszynowe w wyścig mocy obliczeniowej.
Czy ChatGPT działa na transformerze?
Tak. ChatGPT to dostrajany wariant GPT-3.5, a cała seria GPT, od pierwszej wersji z 2018 roku, to transformery zbudowane z samej części dekodera oryginalnej architektury, trenowane na przewidywaniu kolejnego tokena. Nazwa GPT rozwija się zresztą w generative pre-trained transformer. To samo dotyczy konkurencji: Gemini, Claude czy modele open source typu Llama to również transformery, różniące się danymi, rozmiarem i dostrajaniem, nie podstawową konstrukcją.
Co to jest self-attention po ludzku?
To mechanizm, w którym każde słowo zdania ocenia, jak bardzo pozostałe słowa są ważne dla jego własnego znaczenia. W zdaniu „Zwierzę nie przeszło przez ulicę, bo było zbyt zmęczone” token „było” musi się dowiązać do „zwierzęcia”, a nie do „ulicy”, i właśnie taką relację uwaga uczy się ważyć liczbami. Każdy token ma wektory query, key i value, uwaga porównuje query z key wszystkich pozostałych tokenów i miesza ich value w proporcjach wynikających z tych porównań. Efekt jest taki, że znaczenie słowa nie jest sztywne, tylko zależy od kontekstu, w którym wypadło.
Źródła
- Karta arXiv artykułu Attention Is All You Need, rekord API: tytuł, ośmioro autorów, data 12.06.2017, abstrakt z wynikami
BLEU, odczyt 17.10.2026: https://arxiv.org/abs/1706.03762 - Pozycja w materiałach konferencji NIPS 2017 (Advances in Neural Information Processing Systems 30), odczyt 17.10.2026: https://papers.nips.cc/paper_files/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html
- Wikipedia EN, hasło Transformer (deep learning): historia,
RNNiLSTM, równoległość, kwadratowy koszt uwagi,GPTiBERT, odczyt 17.10.2026: https://en.wikipedia.org/wiki/Transformer_(deep_learning_architecture) - Wikipedia PL, hasło Transformer (sztuczna inteligencja), odczyt 17.10.2026: https://pl.wikipedia.org/wiki/Transformer_(sztuczna_inteligencja)
- Google Research blog, Transformer: A Novel Neural Network Architecture for Language Understanding, 31.08.2017, Jakob Uszkoreit; przykład bank/river, analiza zaimka it, lista badaczy, odczyt 17.10.2026: https://research.google/blog/transformer-a-novel-neural-network-architecture-for-language-understanding/
- NVIDIA blog, What Is a Transformer Model? (nazwa architektury, trening 3,5 dnia na 8 GPU, cytaty Vaswaniego i Gomeza, skalowanie), odczyt 17.10.2026: https://blogs.nvidia.com/blog/what-is-a-transformer-model/
- AWS, What are Transformers in Artificial Intelligence? (wektory
query,key,value, analogia pokoju, porównanie zRNN), odczyt 17.10.2026: https://aws.amazon.com/what-is/transformers-in-artificial-intelligence/ - Jay Alammar, The Illustrated Transformer (przykład The animal didn’t cross the street, mechanika
self-attentionkrok po kroku), odczyt 17.10.2026: https://jalammar.github.io/illustrated-transformer/