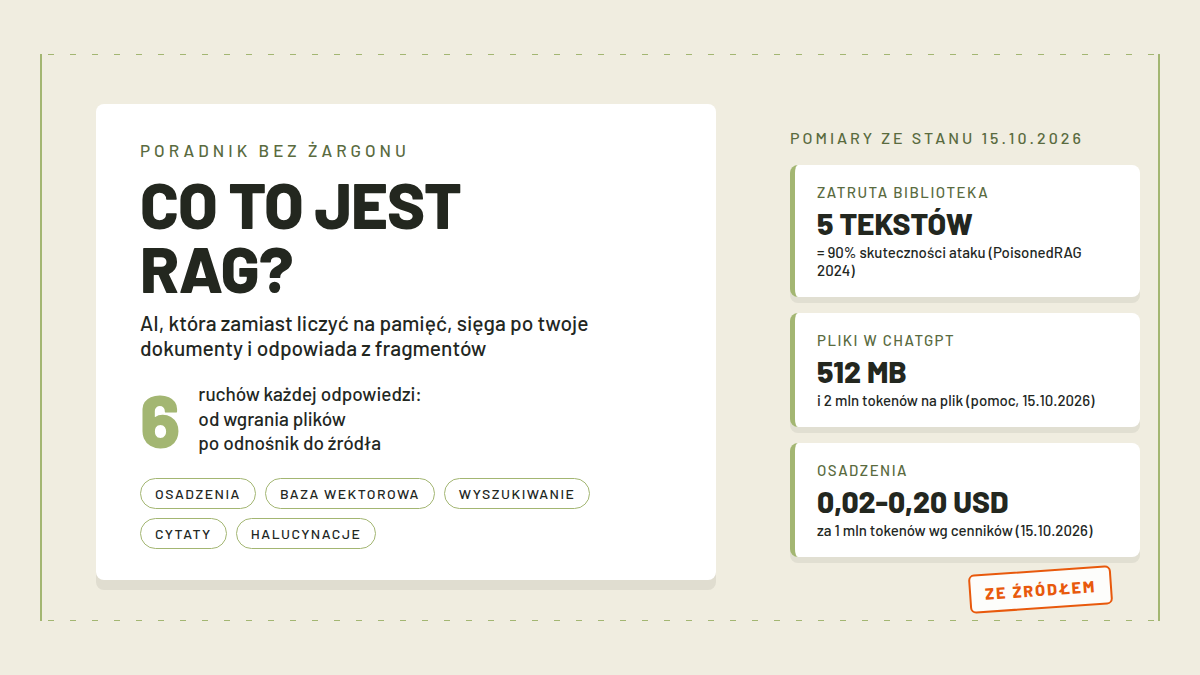
RAG, po angielsku retrieval-augmented generation, to technika, w której model językowy zanim coś odpowie, przeszukuje wskazaną mu bibliotekę dokumentów i układa odpowiedź ze znalezionych fragmentów. Nie doucza się tych dokumentów i nic z nich nie zapisuje na stałe. Działa jak autor, który zamiast liczyć na pamięć ma wycinki rozłożone na biurku. Stąd dwie praktyczne zalety: odpowiedzi rzadziej mijają się z faktami i można je skonfrontować ze źródłem, które model podaje obok. Ten tekst wpisuje się w serię AI bez żargonu, w której rozbieramy takie pojęcia na części. Znajdziesz tu mechanikę krok po kroku, historię pomysłu z 2020 roku, produkty, które RAG stosują już dziś, i koszty, gdybyś chciał złożyć własny.
- Po co ktoś w ogóle wymyślił RAG?
- Jak RAG działa, krok po kroku?
- Czym RAG różni się od zwykłego czatu z modelem?
- Gdzie już dziś spotykasz RAG?
- Kiedy wystarczy RAG, a kiedy okno kontekstowe albo fine-tuning?
- Czego RAG nie naprawi?
- Jak zacząć z RAG w praktyce?
- Co z tego ma firma albo twórca w Polsce?
- Najważniejsze informacje
- Najczęstsze pytania
Po co ktoś w ogóle wymyślił RAG?
Model językowy bez własnej biblioteki zna tylko to, co zapamiętał podczas treningu. LlamaIndex zapisuje to w dokumentacji wprost: „LLMs are trained on enormous bodies of data but they aren’t trained on your data”. Nie zna umowy, którą podpisałeś w marcu, nie zna wewnętrznej wikii firmy, nie zna niczego, co wydarzyło się po dacie granicznej treningu. LangChain dorzuca drugą stronę problemu: nawet gdybyś chciał wrzucić całą dokumentację do rozmowy, według dokumentacji po prostu nie całość zmieści się w oknie, w którym model czyta.
Ten problem opisano na gruncie naukowym, zanim RAG trafił do produktów. W maju 2020 dwunastu badaczy z University College London, Facebook AI Research i NYU na czele z Patrickiem Lewisem opublikowało pracę, od której pochodzi sama nazwa (złożona na arXiv 22.05.2020, przyjęta na NeurIPS 2020). Pomysł przedstawili przez dwa rodzaje pamięci. Parametryczna to wagi modelu, czyli wszystko, co zapamiętał z treningu. Nieparametryczna to zewnętrzny indeks, u nich gęsty indeks wektorowy Wikipedii, po którym porusza się osobny, wstępnie wytrenowany wyszukiwacz. Model odpowiada, sięgając do obu pamięci naraz. Na trzech zadaniach pytania-odpowiedź na otwartą domenę ich podejście osiągnęło wtedy stan techniki, a generowany tekst był bardziej konkretny, zróżnicowany i faktograficzny niż czysty model bez wyszukiwania. Autorzy nazwali wprost dwie bolączki, które chcieli załatwić: pochodzenie odpowiedzi, czyli skąd model to wie, oraz aktualizację wiedzy o świecie bez dotykania wag.
Z pomysłu naukowego zrobił się najpierw wzorzec inżynierski, potem produkt. Microsoft Learn opisuje dziś RAG jako powtarzalny schemat budowania systemów, który zakotwicza odpowiedzi w treści własnej organizacji, a AWS jako proces optymalizowania odpowiedzi modelu przez odwołanie do zaufanej bazy wiedzy przed generowaniem. Frameworki open source, LangChain i LlamaIndex, ustandardyzowały kroki. Producenci aplikacji wciśli mechanikę pod przycisk: wgranie pliku do czatu, baza wiedzy w projekcie, notatnik z dokumentami.
Jak RAG działa, krok po kroku?
Cykl da się opisać w sześciu ruchach, dokładnie takich, jakie wymienia dokumentacja LangChain. Najpierw ładujesz dokumenty: PDF-y, strony internetowe, eksporty z baz. Potem tniesz je na fragmenty. Azure AI Search tłumaczy, po co: podział dużych dokumentów sprawia, że fragmenty dają się dopasowywać niezależnie, więc wynik wyszukiwania bywa trafniejszy niż dopasowanie do całej strony.
Trzeci ruch to osadzenia. Każdy fragment zamieniany jest w ciąg liczb, który zachowuje znaczenie tekstu. OpenAI w przewodniku definiuje osadzenie jako wektor, listę liczb zmiennoprzecinkowych, i zauważa, że małe odległości między takimi wektorami oznaczają duże podobieństwo treści. Mechanikę osadzeń opisałem szeroko w tekście o embeddingach. Warto znać skalę: text-embedding-3-small od OpenAI daje wektor z 1536 liczb, text-embedding-3-large z 3072, wg dokumentacji z odczytem 15.10.2026.
Czwarty ruch: fragmenty razem z ich współrzędnymi trafiają do bazy wektorowej, czyli kartoteki uporządkowanej po znaczeniu, nie po alfabecie. Piąty: przychodzi pytanie, ono również zostaje zamienione na wektor, po czym wyszukiwarka szuka fragmentów leżących w tej przestrzeni najbliżej. Tu jest sedno. Dopasowanie idzie po sensie, nie po wspólnych słowach. Przykład z dokumentacji Azure: pracownik pyta o politykę urlopową (po angielsku PTO policy), a w dokumentach stoi „time off” albo „telecommute”. Wyszukiwanie po słowach zawodzi, wyszukiwanie po znaczeniu znajduje. Wyszukiwarka zwraca kilka najlepszych fragmentów, zwykle z limitem top-k i dodatkowym rankingiem semantycznym.
Szósty ruch to sama odpowiedź: model dostaje prompt, w którym siedzi i pytanie, i znalezione fragmenty, i pisze odpowiedź na ich podstawie. Sensowne wdrożenia dokładają odnośniki do źródeł, Azure ma wbudowane śledzenie pochodzenia cytatu. Do tego dochodzi konserwacja: wg AWS dane zewnętrzne bez aktualizacji starzeją się, więc indeks się odświeża. Nowa wersja umowy wchodzi do biblioteki, model zostaje ten sam.
Czym RAG różni się od zwykłego czatu z modelem?
Zwykły czat odpowiada z pamięci wag. Nie ma czego klikać, nie wyczyta wczorajszej decyzji rady nadzorczej, a gdy brakuje mu danych, zmyśla z pełnym przekonaniem. IBM w materiale porównującym RAG z fine-tuningiem przypomina: bez stałego dopływu nowych danych duże modele stoją w miejscu, a przy brakującej wiedzy potrafią halucynować. RAG z tego nie ustrzega w stu procentach; o halucynacjach AI pisaliśmy osobno i nawet z biblioteką model potrafi ułożyć zdanie, którego w fragmentach nie było. Różnica jest w proporcjach: odpowiada raczej z materiału niż z wyobraźni.
Druga różnica to sprawdzalność. Odpowiedź z RAG-a ma przypis do fragmentu, odpowiedź z czystego czatu ma tylko pewny siebie ton. Możesz otworzyć źródło i sprawdzić, czy model dobrze przeczytał. Trzecia różnica: wiedza leży tam, gdzie ją postawisz, a nie tam, gdzie skończył się trening. Ta sama zasada napędza pamięć czatów, o której pisałem przy ChatGPT i pamięci: system odzyskuje ją też przez wyszukiwanie po osadzeniach, tylko biblioteką są twoje poprzednie rozmowy, nie pliki z umowami.
Gdzie już dziś spotykasz RAG?
W aplikacjach, które wielu z nas ma otwarte codziennie. Limity spisałem z dokumentacji 15.10.2026, więc traktuj je jako odczyt z tego dnia, nie obietnicę na zawsze.
Gemini Notebook, dawniej NotebookLM, to notatnik zbudowany wokół biblioteki źródeł. Według pomocy Google plan Standard ma 100 notebooków po 50 źródeł, plan Pro 500 notebooków po 300 źródeł, a najwyższy Ultra 500 notebooków po 600 źródeł. ChatGPT przyjmuje pliki DOCX, PDF, TXT, arkusze i prezentacje; według pomocy z października 2026 jeden plik może mieć do 512 MB, plik tekstowy do 2 mln tokenów, a darmowy plan dostaje 3 wgrywania dziennie. W projektach pliki limitowane do 5 na planie darmowym i 40 na Pro czy Business. Ta sama pomoc wyjaśnia mechanikę bez owijania: poza Enterprise z wizualnym odczytem PDF stosowane jest „text-based retrieval”, czyli wyciąganie cyfrowego tekstu z pliku. Claude ma Projects: bez płacenia pięć projektów, na planach płatnych baza wiedzy projektów rozbudowywana przez RAG, wg pomocy Anthropica do dziesięciokrotności pojemności okna kontekstowego.
W firmach ten sam schemat siedzi w Copilocie. Microsoft Learn (aktualizacja 14.10.2026) opisuje zakotwiczanie odpowiedzi w danych organizacji przez Microsoft Graph i Work IQ, przy czym dostęp jest ograniczony uprawnieniami: pytający dostaje tylko to, do czego i tak ma prawa. W praktyce to RAG nad twoją skrzynką i dyskiem sieciowym.
Na marginesie: fraza agent AI, o której pisaliśmy osobno, często znaczy dokładnie to plus narzędzia. LlamaIndex zaznacza, że silniki zapytań, silniki czatu i agenci często wykonują swoje zadania przez RAG: agent, zanim cokolwiek zrobi, sięga po dokumenty.
Kiedy wystarczy RAG, a kiedy okno kontekstowe albo fine-tuning?
Okno kontekstowe, czyli ile tekstu model widzi naraz, i RAG nie są konkurentami. RAG korzysta z okna, tylko wkłada do niego wybrane fragmenty zamiast całej biblioteki; samo okno kontekstowe omawialiśmy już osobno. Dokumentacja LangChain mówi wprost, że całości często nie da się zmieścić. Azure liczy przykładem: model przyjmujący 128 tys. tokenów kontra 10 tys. stron dokumentacji, bo przesyłanie wszystkiego marnuje tokeny i psuje jakość. Koszt rośnie z każdym zapytaniem, a model tonie w nadmiarze.
Fine-tuning to inna operacja: dotrenowujesz sam model na własnym zbiorze zamiast dołączać mu materiał na czas odpowiedzi. Według IBM przydaje się do stylu, terminologii i powtarzalnych zadań domenowych, gdzie dotrenowany model zwykle wygrywa z bazowym. Nie dowozi jednak faktów na dzień zadany. Jeśli cennik się zmieni, dotrenowany model dalej będzie twierdził stare, a RAG wystarczy zaktualizować bibliotekę.
| Podejście | Co wnosi | Kiedy wystarcza |
|---|---|---|
| Duże okno kontekstowe | cały tekst w promptcie | jeden dokument, analiza jednorazowa |
| RAG | wybrane fragmenty z biblioteki | dużo plików, dane prywatne albo świeże |
| Fine-tuning | przestrajenie wag modelu | styl, terminologia, powtarzalne zadania |
W praktyce podejścia łączy się: biblioteka przez RAG, obszerny kontekst tam, gdzie potrzebny, a fine-tuning tylko wtedy, gdy styl albo terminologia naprawdę przeszkadzają.
Czego RAG nie naprawi?
Słabego indeksu. Model odpowiada z tego, co wyszukiwanie mu podało; jeśli najtrafniejszy fragment nie wypadnie w pierwszych wynikach, odpowiedź będzie pewna siebie i zła. Azure poświęca strojeniu trafności osobne rozdziały dokumentacji, co samo w sobie mówi, że to częsty punkt awarii.
Zatrutej biblioteki. Zespół Wei Zou opisał w 2024 atak PoisonedRAG: wstrzyknięcie pięciu złośliwych tekstów na jedno pytanie do bazy z milionami tekstów dawało 90 proc. skuteczności ataku, a ocenione obrony nie wystarczały (wersja pracy z 13.08.2024, publikacja na USENIX Security 2025). Biblioteka jest tak zaufana, jak jej najgorszy dokument.
Poleceń ukrytych w dokumentach. Greshake i wsp. opisali w lutym 2023 pośrednią injekcję promptu: instrukcje wstrzyknięte w dane, które najpewniej zostaną pobrane, przejmują aplikację zintegrowaną z modelem. Atak pokazano między innymi na Bing Chat napędzanym GPT-4. RAG czyta wszystko, co mu dasz, i nie odróżnia treści od rozkazu; to ten sam mechanizm, o którym pisałem przy promptach. Dokument z internetu wgrany do biblioteki jest wejściem od obcego.
I prozaicznie: uprawnień oraz praw. W firmie RAG bez dołożonej kontroli dostępu zacytuje umowę temu, kto nie ma do niej praw; Azure wylicza nadzór nad dostępem jako jedno z głównych wymagań wobec wdrożenia. Sam model potrafi cytować dosłownie, więc jeśli w indeksie leżą teksty, których nie masz prawa rozpowszechniać, cytaty pojadą do każdego, kto zapyta.
Jak zacząć z RAG w praktyce?
Jako użytkownik potrzebujesz konta i własnych plików, tyle. Gemini Notebook wystarczy z kontem Google. ChatGPT na darmowym planie przyjmie trzy pliki dziennie, Claude da pięć projektów bez opłat (odczyty 15.10.2026). Zacznij od jednego notatnika z garstką sensownych źródeł i pytaj, prosząc o wskazanie fragmentu, na którym oparto odpowiedź.
Jako deweloper masz dwie najczęściej używane drogi: LangChain albo LlamaIndex. Musisz mieć dokumenty, klucz API do modelu i do osadzeń oraz bazę wektorową, która może na starcie działać lokalnie. Framework spina resztę: wg LangChain ładujesz, tniesz, osadzasz, zapisujesz, wyszukujesz, generujesz; wg LlamaIndex to loading, indexing, storing, querying i evaluation, czyli dodatkowo mierzenie jakości odpowiedzi. Obie dokumentacje prowadzą od zera do działającego prototypu. Uczciwie dodam, że własnej instancji na potrzeby tego tekstu nie stawiałem; opis opieram na dokumentacji obu frameworków z odczytem 15.10.2026.
Co z tego ma firma albo twórca w Polsce?
Policzmy wejście, bo osadzenia są tańsze, niż większość ludzi oczekuje. Karta cennika Gemini API z odczytu 15.10.2026 pokazuje darmowy tier dla tekstu w modelu Gemini Embedding 2, a płatnie 0,20 USD za 1 mln tokenów (w trybie batch 0,10 USD). OpenAI w dokumentacji osadzeń podaje tabelę stron za dolara: ok. 62 500 stron za dolara modelem text-embedding-3-small i ok. 9 615 stron modelem text-embedding-3-large, przy założeniu 800 tokenów na stronę; dokładnych stawek za 1 mln tokenów aktualna karta cennika już nie wymienia. Voyage, dostawca osadzeń polecany w dokumentacji Anthropica, bo Anthropic własnych nie prowadzi, wycenia 0,02-0,12 USD za 1 mln tokenów zależnie od modelu i daje 200 mln darmowych tokenów na start. Przykładowa biblioteka z 10 tys. stron PDF to w osadzeniach od kilkudziesięciu groszy do kilku złotych wg przeliczenia z cenników z 15.10.2026. Prawdziwy ciężar leży gdzie indziej: w odpowiedziach modelu przy każdym pytaniu.
Prywatność ma dwie półki. Warunki Gemini API obowiązujące od 23.03.2026 na usługach darmowych pozwalają Google używać przesyłanych treści do rozwijania produktów, z możliwością wglądu reviewerów; na usługach płatnych Google deklaruje, że promptów i odpowiedzi nie używa do doszkalania. Dla Polski ważny dopisek: w Europejskim Obszarze Gospodarczym ostrzejsze warunki płatne obowiązują także na usługach darmowych. Po stronie OpenAI wgrywy w aplikacjach konsumenckich mogą służyć do treningu zależnie od ustawień danych, a API i oferty biznesowe są z tego wyłączone. W Microsoft 365 Copilot ruch z UE zostaje w granicach EU Data Boundary wg dokumentacji z 14.10.2026.
Moim zdaniem dla danych służbowych to rozstrzyga wybór: płatny tier albo własne wdrożenie na własnej maszynie, a darmowe plany tylko na rzeczach, które i tak są jawne.
Najważniejsze informacje
| Co | W skrócie |
|---|---|
| Czym jest RAG | technika: wyszukanie w bibliotece, potem odpowiedź z fragmentów |
| Pierwsza praca naukowa | Lewis i in., arXiv 22.05.2020, NeurIPS 2020 |
| Kolejność kroków | dokumenty, cięcie, osadzenia, wyszukiwanie, odpowiedź, odświeżanie |
| Halucynacje | mniej niż na czystym czacie, nie zero |
| Gemini Notebook | 50-600 źródeł na notebook wg planu (odczyt 15.10.2026) |
| ChatGPT pliki | do 512 MB i 2 mln tokenów na plik (odczyt 15.10.2026) |
| Claude Projects | baza wiedzy z RAG na planach płatnych, do 10x kontekstu |
| Ceny osadzeń | 0,02-0,20 USD za 1 mln tokenów (odczyty 15.10.2026) |
Najczęstsze pytania
Co to jest RAG w AI?
Technika łącząca wyszukiwanie z generowaniem: model przed odpowiedzią przeszukuje wskazaną bazę dokumentów i układa odpowiedź z znalezionych fragmentów, często z odnośnikami do źródeł. Skrót pochodzi od angielskiego retrieval-augmented generation, czyli generowanie wspomagane wyszukiwaniem.
Czy RAG to model AI?
Nie. AWS opisuje RAG jako proces, Microsoft Learn jako wzorzec składania systemów. Model językowy generuje tekst, RAG tylko dobiera, co trafi mu do ręki przed odpowiedzią. Ten sam model może działać z RAG-iem albo bez niego.
Czym różni się RAG od ChatGPT?
ChatGPT to produkt, RAG to technika. Czysty czat odpowiada z tego, co model zapamiętał w treningu. Wersje z wgranymi plikami i projektami korzystają z RAG-a: najpierw wyszukują w twoich dokumentach, potem odpowiadają. Wg pomocy OpenAI z października 2026 wgrane pliki czytane są wyszukiwaniem tekstowym, a limity zależą od planu.
Czy RAG jest darmowy?
W gotowych produktach bywa darmowy w ramach limitów planu: Gemini Notebook Standard bez opłat, ChatGPT na darmowym planie przyjmie trzy pliki dziennie, Claude pięć projektów. Własny RAG darmowy nie jest, bo płacisz za osadzenia i odpowiedzi modelu. Łagodzą to darmowe progi: Google ma darmowy tier tekstu w osadzeniach, Voyage 200 mln tokenów na start (odczyty 15.10.2026).
Jak zrobić własny RAG?
Najkrótsza droga wg dokumentacji: framework, LangChain albo LlamaIndex, klucz API do modelu i osadzeń, baza wektorowa oraz twoje dokumenty. Kroki: załaduj, potnij, osadź, zapisz, wyszukaj, wygeneruj. Prototyp to jedna wieczorna sesja; dopracowanie produkcyjne, czyli uprawnienia, odświeżanie i pomiary jakości, to już praca na tygodnie.
Źródła
- Patrick Lewis i in., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, arXiv, złożone 22.05.2020 (odczyt 15.10.2026): https://arxiv.org/abs/2005.11401
- AWS, „What is RAG?” (odczyt 15.10.2026): https://aws.amazon.com/what-is/retrieval-augmented-generation/
- Microsoft Learn, „RAG and generative AI in Azure AI Search”, aktualizacja 17.09.2026 (odczyt 15.10.2026): https://learn.microsoft.com/en-us/azure/search/retrieval-augmented-generation-overview
- LangChain, dokumentacja budowy RAG (odczyt 15.10.2026): https://docs.langchain.com/oss/python/langchain/rag
- LlamaIndex, „Introduction to RAG” (odczyt 15.10.2026): https://developers.llamaindex.ai/python/framework/understanding/rag/
- IBM, „RAG vs. fine-tuning” (odczyt 15.10.2026): https://www.ibm.com/think/topics/rag-vs-fine-tuning
- Wei Zou, Runpeng Geng, Binghui Wang, Jinyuan Jia, „PoisonedRAG”, arXiv, v3 13.08.2024 (odczyt 15.10.2026): https://arxiv.org/abs/2402.07867
- Kai Greshake i in., „Not what you’ve signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection”, arXiv, v2 05.05.2023 (odczyt 15.10.2026): https://arxiv.org/abs/2302.12173
- OpenAI, przewodnik po osadzeniach na platformie API (odczyt 15.10.2026): https://platform.openai.com/docs/guides/embeddings
- Google, cennik Gemini API (odczyt 15.10.2026): https://ai.google.dev/gemini-api/docs/pricing
- Google, Gemini API Additional Terms of Service, obowiązują od 23.03.2026 (odczyt 15.10.2026): https://ai.google.dev/gemini-api/terms
- Voyage AI, cennik osadzeń (odczyt 15.10.2026): https://docs.voyageai.com/docs/pricing
- Anthropic, dokumentacja osadzeń (odczyt 15.10.2026): https://platform.claude.com/docs/en/docs/build-with-claude/embeddings
- Claude Help Center, „What are projects?” (odczyt 15.10.2026): https://support.claude.com/en/articles/9517075-what-are-projects
- OpenAI Help Center, „Uploading files and audio to ChatGPT”, aktualizacja ok. 08.10.2026 (odczyt 15.10.2026): https://help.openai.com/en/articles/8555545-file-uploads-faq-for-chatgpt
- Google Help, „Learn about Gemini Notebook’s plans” (odczyt 15.10.2026): https://support.google.com/gemininotebook/answer/16213268
- Microsoft Learn, „What is Microsoft Copilot?”, aktualizacja 14.10.2026 (odczyt 15.10.2026): https://learn.microsoft.com/en-us/microsoft-365/copilot/microsoft-365-copilot-overview