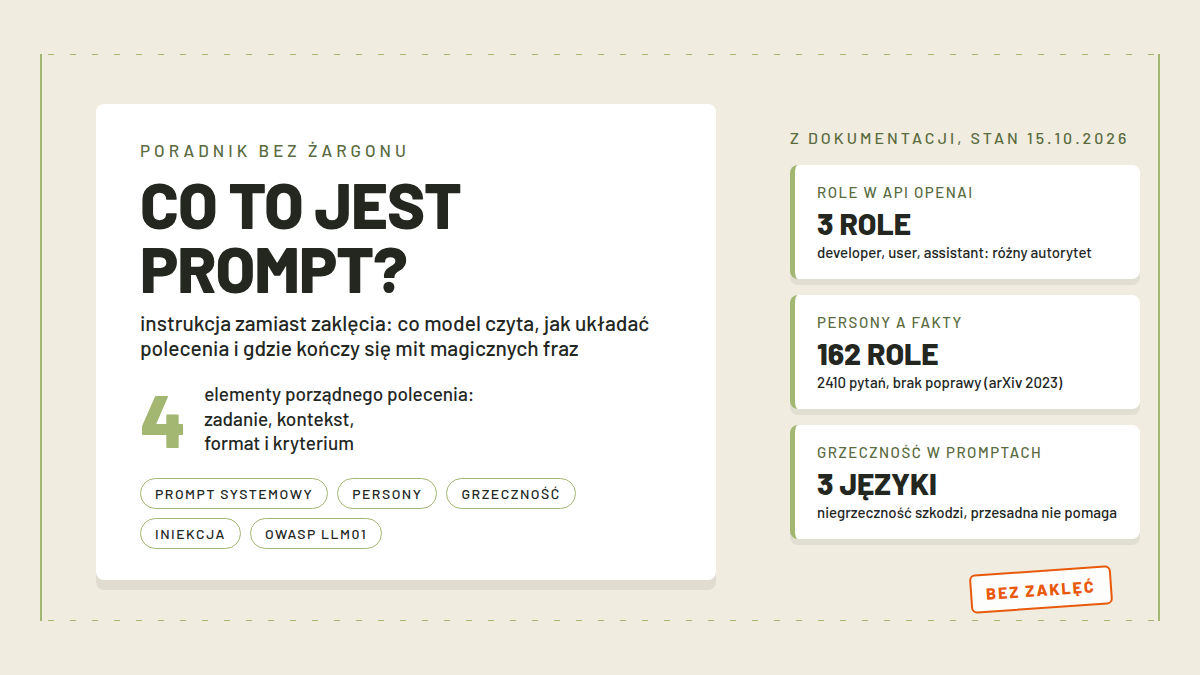
Prompt to instrukcja, którą zlecasz modelowi AI pracę: pytanie, polecenie albo opis zadania razem z materiałem do obróbki. Każde pole tekstowe w czacie to okazja do napisania promptu, od krótkiego „przetłumacz to zdanie” po rozpiskę na kilka akapitów. Tekst należy do serii Podstawy AI, w której bez żargonu składam podstawy pracy z modelami. Znajdziesz tu definicję i warstwy promptu, praktyczny sposób układania poleceń po polsku oraz rozliczenie, gdzie kończy się mit magicznych formuł, a zaczyna prompt injection. Etykiety interfejsu i definicje sprawdziłem w dokumentacji OpenAI, Anthropica i Google z odczytem z 15 października 2026.
- Czym właściwie jest prompt?
- Co model naprawdę widzi, kiedy wysyłasz wiadomość?
- Gdzie kończy się twoje polecenie, a zaczyna okno kontekstowe i pamięć?
- Jak pisać prompty, żeby zrozumiano cię za pierwszym razem?
- Grzeczność, „proszę” i odgrywanie ról: co działa, a co mitem zostaje?
- Prompt engineering: co to naprawdę jest?
- Prompt injection: kiedy prompt staje się bronią?
- Jak to wygląda w ChatGPT, Claude i Gemini?
- Najważniejsze informacje
- Najczęstsze pytania
Czym właściwie jest prompt?
W pomocy OpenAI prompt opisano jako tekstowe wejście, które rozpoczyna rozmowę albo wywołuje odpowiedź modelu, przy czym wejście może być też obrazem albo dźwiękiem. W praktyce więc prompt to wszystko, co wstawiasz w okno czatu, plus załączniki, jeśli narzędzie je przyjmuje.
Samo słowo pochodzi z angielskiego i oznacza zachętę, jak znak zachęty w starym terminalu. Model nie odgaduje intencji spoza tekstu: dostaje ciąg znaków i kontynuuje go najbardziej prawdopodobnym zakończeniem. Z tego jednego zdania wynika połowa porad z tego artykułu. Co się przy tym dzieje pod spodem, opisuje tekst co to jest LLM.
Co model naprawdę widzi, kiedy wysyłasz wiadomość?
Model czyta twoją wiadomość jako tekst pocięty na tokeny, czyli drobne kawałki słów (mechanikę opisuję w tekście co to jest token AI). Nie dostaje przy okazji żadnych informacji o tobie, których sam mu nie napisał. Twoje zawody, upodobania i sytuacja istnieją dla niego tylko wtedy, gdy są częścią tekstu albo zapisane w ustawieniach, o czym niżej.
Obok twojej wiadomości w tym samym wejściu podróżuje instrukcja operatora narzędzia. W dokumentacji OpenAI role wiadomości nazywają się developer, user i assistant i mają różne poziomy autorytetu: komunikaty developera niosą „reguły systemu i logikę biznesową”, a komunikaty użytkownika działają jak argumenty przekazywane do funkcji. Anthropic przekazuje tę warstwę osobnym parametrem `system`, Google parametrem `system_instruction`. Przykład z dokumentacji Gemini jest nieśmiały, bo wystarczy linijka „You are a cat. Your name is Neko.”, żeby model zmienił sposób mówienia.
Tę ukrytą warstwę nazywa się promptem systemowym i ona odpowiada za to, czemu asystent w aplikacji banku nie żartuje. Jako użytkownik nie widzisz jej treści, bo ustawia ją twórca narzędzia przed rozmową. Korzystając z gotowej aplikacji, część pracy nad promptem ktoś wykonał więc za ciebie, a twoje pole tekstowe jest ostatnią warstwą całości. Jak warstwy składają się w produkt, opisuję w tekście jak działa ChatGPT.
Gdzie kończy się twoje polecenie, a zaczyna okno kontekstowe i pamięć?
To, co wysyłasz teraz, model czyta razem z wcześniejszym przebiegiem rozmowy, w granicach okna kontekstowego. Okno to po prostu limit tekstu, który da się w ogóle podać modelowi w jednym podejściu; liczby i pułapki opisuję w tekście okno kontekstowe. To, co wypadnie za okno, przestaje wpływać na odpowiedź, bo model nie pamięta nic poza tekstem, który akurat dostał.
Producenci dosypują do tego warstwę trwałą, która daje wrażenie, że asystent „pamięta” między rozmowami. W ChatGPT siedzi to pod Settings, Personalization i Memory, z przełącznikami dla wspomnień zapisanych i odwołań do historii czatów; czat tymczasowy z wyboru „Unpersonalized” nie tworzy wspomnień, szerzej piszę o tym w tekście ChatGPT pamięć. W Claude stałe instrukcje dla wszystkich rozmów nazywają się Instructions for Claude i siedzą w Settings, a do tego są jeszcze instrukcje na poziomie projektu. W Gemini ścieżka nazywa się Personal context z polem Your instructions for Gemini, a pełna pamięć między rozmowami jest wg dokumentacji Google na stan 15.10.2026 dostępna tylko w USA.
Praktyczny wniosek jest taki, że twój prompt żyje w trzech miejscach naraz: w polu czatu, w ustawieniach konta i w historii rozmów. Kiedy odpowiedź wydaje się znać coś, czego ci nie napisałeś, to nie telepatia, tylko jedna z tych warstw. Stałe instrukcje w ustawieniach to zresztą też prompt, tylko taki, który działa w każdej rozmowie.
Jak pisać prompty, żeby zrozumiano cię za pierwszym razem?
Anthropic w dokumentacji podaje prostą próbnę czytelności: pokaż swój prompt koledze bez kontekstu i jeśli on będzie zdezorientowany, model też będzie. To tłumaczy, czemu połowa rozczarowań AI bierze się nie z głupoty modelu, tylko z instrukcji pisanych dla samego siebie. Polecenie „popraw ten tekst” zawiera całe zadanie w twojej głowie i ani słowa z tej głowy nie dotarło do modelu.
Elementy, które powinny się znaleźć w porządnym poleceniu, są z grubsza cztery:
- zadanie, czyli co dokładnie ma zrobić model i dla kogo to jest,
- kontekst, czyli materiał i okoliczności, których model nie może odgadnąć,
- format wyniku, czyli jak ma wyglądać odpowiedź, żebyś mógł jej użyć,
- kryterium, po którym poznasz, że wynik jest dobry.
Przykład układam poglądowo, dokładnie tak, jak radzi dokumentacja, a nie jako wynik jakiegokolwiek testu. Zamiast „zrób mi plan posiłków” lepiej wyszłoby coś w stylu „ułóż plan posiłków na trzy dni dla osoby wegetariańskiej, budżet 40 zł dziennie na osobę, podaj w tabeli z listą zakupów na końcu”. Różnica nie tkwi w uprzejmości ani sekretnych słowach, tylko w tym, że przeniosłeś do tekstu to, co siedziało w głowie.
| Element | Pytanie, które sobie zadajesz | Przykład w treści polecenia |
|---|---|---|
| Zadanie | Co dokładnie ma zrobić model? | ułóż plan posiłków na 3 dni |
| Kontekst | Co model musi wiedzieć od ciebie? | wegetariańskie, 40 zł dziennie na osobę |
| Format | Jak ma wyglądać wynik? | tabela, lista zakupów na końcu |
| Kryterium | Po czym poznasz dobry wynik? | przygotowanie posiłku do 30 minut |
Dokumentacja dorzuca dwa narzędzia. Pierwsze to oddzielanie materiału od polecenia, w pomocy OpenAI wklejony tekst bywa opatrzony potrójnymi cudzysłowami, żeby nie zmieszał się z instrukcją. Drugie to przykłady oczekiwanego wyniku, po angielsku few-shot: jeden dobry wzór zastępuje akapit opisów. Gdy pierwsza odpowiedź nie trafiła, pomoc OpenAI zaleca wprost iterację: popraw sformułowanie, dosyp kontekstu, wyślij jeszcze raz.
Zaznaczę uczciwie granicę tych rad: pochodzą z dokumentacji producentów i badań cytowanych niżej, nie z moich porównawczych testów, bo takich nie robiłem. Kierunek w tych źródłach jest spójny: konkretność, nie zaklęcia.
Grzeczność, „proszę” i odgrywanie ról: co działa, a co mitem zostaje?
Kultura poleceń to temat, przy którym badania są mieszane, więc rozliczę go bez rewelacji. Zespół Yin, Kawahary i Sekine zbadał w 2024 roku wpływ uprzejmości promptów w trzech językach: angielskim, chińskim i japońskim. Wynik: niegrzeczne prompty często pogarszały wyniki, ale przesadna grzeczność też niczego nie gwarantowała, a najkorzystniejszy poziom uprzejmości różnił się zależnie od języka. Polskiego w badaniu nie było, więc na nasz język wnioski przenosisz na własną odpowiedzialność.
Persony, czyli otwieranie promptu od „jesteś doświadczonym prawnikiem”, wypadają w badaniach jeszcze słabiej. Zespół Zheng i współpracowników przetestował 162 role na 2410 pytaniach faktograficznych w czterech rodzinach modeli i wnioskiem był brak poprawy względem promptu bez persony, a wpływ poszczególnych ról opisano jako w dużej mierze losowy. To nie znaczy, że rola nigdy nie pomaga: pomaga ustawiać ton, styl i format odpowiedzi, o czym dokumentacja Anthropica pisze wprost, już jedno zdanie roli zmienia zachowanie. Nie pomaga jednak w faktach i dokładności.
Moim zdaniem kurtuazja jest bezpieczna, bo „proszę” kosztuje kilka tokenów, natomiast niegrzeczna forma potrafi realnie zepsuć wynik. Jeśli zależy ci na jakości, budżet uwagi wydaj na kontekst i format, nie na formuły grzecznościowe. Na marginesie: to jedyny fragment tematu, w którym internet pełen jest pewności, a literatura daje tylko zastrzeżenia.
Prompt engineering: co to naprawdę jest?
W pomocy OpenAI prompt engineering zdefiniowano jako projektowanie i optymalizacja promptów, które skutecznie prowadzą model do pożądanych odpowiedzi. Brzmi jak zawód przyszłości, a rdzeń tej praktyki to iteracja znana z każdej pracy z tekstem: szkic, przegląd wyniku, korekta, kolejna próba. Anthropic idzie o krok dalej i wymaga przed startem trzech rzeczy: jasnych kryteriów sukcesu dla danego zastosowania, sposobu ich empirycznego testowania i pierwszego szkicu promptu do poprawy.
W wersji inżynierskiej dochodzą do tego elementy z dokumentacji: struktura ze znaczników XML albo nagłówków Markdown u Google, dzielenie dużych zadań na łańcuchy promptów, przykłady few-shot, przechowywanie promptów w kodzie z testami. To rzemiosło pisania instrukcji i mierzenia wyników, bez magicznych fraz. Zastrzeżenie z dokumentacji Anthropica: czasem lepszy efekt da zmiana modelu niż męczenie się z jednym promptem.
Dla zwykłego użytkownika czatu ta cała inżynieria sprowadza się do nawyków z poprzednich sekcji: konkretna prośba, kontekst, format, iteracja. Nazwa brzmi jak odrębny zawód, a w codziennym użyciu jest umiejętnością pisania instrukcji, którą masz w sobie już od szkoły.
Prompt injection: kiedy prompt staje się bronią?
OWASP na liście ryzyk dla aplikacji LLM opisuje podatność LLM01:2025 jako sytuację, w której prompty zmieniają zachowanie modelu albo jego wynik w niezamierzony sposób. Rozróżnia się iniekcję bezpośrednią, gdy własne wejście próbuje nadpisać instrukcje narzędzia, i pośrednią, gdy szkodliwa instrukcja siedzi w treści, którą model czyta za ciebie: na stronie, w pliku, w mailu. Jailbreak jest opisany jako podtyp, w którym atak zmusza model do odrzucenia protokołów bezpieczeństwa w całości. Dokument ma jedno zdanie, które warto cytować dosłownie: iniekcje „nie muszą być widoczne ani czytelne dla człowieka”, wystarczy, że przeczyta je model.
Incydenty z tej rodziny zdarzały się publicznie. W grudniu 2023 roku czat na stronie salonu Chevrolet of Watsonville, oznaczony jako „powered by ChatGPT”, przepuścił wiralową ofertę zakupu Chevy Tahoe za jednego dolara; Business Insider zastrzega przy okazji, że oferta nie była prawnie wiążąca, a bot większość żartobliwych próśb z logów po prostu odrzucał. Dostawca czatu, firma Fullpath, wyłączyła go po głośnym weekendzie. We wrześniu 2026 roku OpenAI opisało samoreplikujące się iniekcje, odkryte w czerwcu 2026 w w pełni symulowanych środowiskach: iniekcja ukryta w mailu nakazuje asystentowi odpowiadać po hiszpańsku i cytować całą wiadomość, przez co payload sam przenosi się do kolejnych maili, co raport porównuje do robaka komputerowego. Na liście OWASP wisi z 2024 roku CVE-2024-5184, iniekcja kodu w asystencie mailowym.
Ryzyko rośnie razem z tym, ile narzędzi dostaje model: czat, który tylko pisze tekst, zrobi mniej szkody niż agent z dostępem do poczty i kalendarza (rozróżnienie opisuję w tekście czym jest agent AI). OWASP pisze wprost, że nie wiadomo o metodach w 100% skutecznych, a zaleca minimalne uprawnienia modelu, zatwierdzanie przez człowieka akcji wysokiego ryzyka i wyraźne oddzielanie treści niezaufanych od instrukcji. Po stronie użytkownika zostaje jeden nawyk: nie podpinaj poufnych skrzynek i dokumentów pod asystenta czytającego obce strony bez kontroli.
Jak to wygląda w ChatGPT, Claude i Gemini?
Te same warstwy nazywają się w każdym narzędziu inaczej, a nazwy zmieniają się często, więc podaję je z datą odczytu 15.10.2026. ChatGPT trzyma personalizację i wspomnienia pod Settings, Personalization i Memory, z czatem tymczasowym poza personalizacją. Claude ma Instructions for Claude w ustawieniach konta, do tego instrukcje projektu i Skills. Gemini prowadzi przez Personal context i pole Your instructions for Gemini, przy czym pamięć między rozmowami jest wg dokumentacji dostępna tylko w USA i wymaga planu Google AI.
| Narzędzie | Stałe instrukcje (odczyt 15.10.2026) | Pamięć między rozmowami |
|---|---|---|
| ChatGPT | Settings → Personalization → Memory | wspomnienia plus historia czatów, przełączniki w tym samym miejscu |
| Claude | Settings → Instructions for Claude | dodatkowo instrukcje w obrębie projektu |
| Gemini | Personal context → Your instructions for Gemini | Memory wg dokumentacji tylko w USA (stan 15.10.2026) |
Producenci przyznają się przy tym do granic. Google pisze wprost, że instrukcje typu „zapomnij o tym temacie” nie zawsze działają i skuteczniejsze bywa usuwanie czatów z aktywności Gemini. OpenAI zastrzega, że samo usunięcie czatu nie usuwa automatycznie osobnego wspomnienia z niego zbudowanego. Wniosek praktyczny: pamięć to prompt, którego nie widzisz na pierwszym planie, więc zanim stwierdzisz, że model „jest uparty”, zajrzyj do tych ustawień i posprzątaj, co tam siedzi.
Najważniejsze informacje
| Pojęcie | W jednym zdaniu | Źródło z datą |
|---|---|---|
| Prompt | Instrukcja tekstowa zlecająca modelowi zadanie | pomoc OpenAI, odczyt 15.10.2026 |
| Prompt systemowy | Stała instrukcja operatora, jej nie widzisz | docs Anthropic, odczyt 15.10.2026 |
| Role developer i user | Różny autorytet instrukcji w API | docs OpenAI, odczyt 15.10.2026 |
| Okno kontekstowe | Limit tekstu, który model w ogóle przeczyta | wpis technetblog, 2026 |
| Pamięć | Ustawienia konta działają jak stojący prompt | pomoc ChatGPT, odczyt 15.10.2026 |
| Grzeczność | Niegrzeczność szkodzi, przesadna nie pomaga | arXiv, v1 22.02.2024 |
| Persony | Brak poprawy na 2410 pytaniach faktograficznych | arXiv, v1 16.11.2023 |
| Prompt injection | LLM01:2025 na liście OWASP, direct i indirect | genai.owasp.org, odczyt 15.10.2026 |
Najczęstsze pytania
Co to jest prompt w AI?
Prompt to tekstowe wejście, które wywołuje odpowiedź modelu: pytanie, polecenie albo zadanie z materiałem do obróbki. W pomocy OpenAI za prompt uznaje się też obraz albo dźwięk, jeśli narzędzie przyjmuje takie wejścia. Każda kolejna wiadomość w rozmowie to również prompt, bo model czyta całą historię razem.
Co to jest prompt systemowy?
To stała instrukcja operatora narzędzia, ustawiana przed rozmową, której ty jako użytkownik nie widzisz. W API Anthropica trafia do parametru `system`, u Google do `system_instruction`, a w dokumentacji OpenAI rolę o najwyższym autorytecie pełni komunikat developera. To on decyduje o tonie i granicach tego, co asystent zrobi, zanim cokolwiek napiszesz.
Co to jest promptowanie?
Potocznie tak nazywa się układanie promptów, czyli pisania instrukcji do modelu i doszlifowywanie ich po obejrzanej odpowiedzi. W praktyce to konkretne zadanie, kontekst, ustalony format wyniku i iteracja. Nazwa brzmi nowocześnie, ale opisuje umiejętność, którą znasz z pisania poleceń dla ludzi.
Jak pisać prompty do Chatu GPT?
Podaj zadanie, kontekst i format: zamiast „napisz o rowerze” lepiej „opisz w pięciu zdaniach dobór rozmiaru ramy dla początkującego rowerzysty”. Wklejany materiał oddzielaj od polecenia, a dobry wynik podawaj za przykład. Jeśli odpowiedź nie trafiła, popraw sformułowanie i wyślij ponownie, bo iterację zaleca sama pomoc OpenAI, a stałe preferencje zapisz pod Settings, Personalization.
Co to jest prompt engineering?
To projektowanie i optymalizacja promptów, które prowadzą model do pożądanych odpowiedzi. W wersji inżynierskiej obejmuje kryteria sukcesu, testowanie, strukturyzowanie promptów, przykłady i dzielenie zadań na łańcuchy. Nie istnieją magiczne frazy odblokowujące model; istnieje iteracja i pomiar wyników.
Źródła
- OpenAI Help Center, Prompt engineering best practices for ChatGPT, odczyt 15.10.2026: https://help.openai.com/en/articles/10032626-prompt-engineering-best-practices-for-chatgpt
- OpenAI Help Center, Best practices for prompt engineering with the OpenAI API, odczyt 15.10.2026: https://help.openai.com/en/articles/6654000-best-practices-for-prompt-engineering-with-the-openai-api
- OpenAI Developers, przewodnik Prompt engineering, odczyt 15.10.2026: https://developers.openai.com/api/docs/guides/prompt-engineering
- OpenAI Help Center, Memory FAQ, odczyt 15.10.2026: https://help.openai.com/en/articles/8590148-memory-faq
- OpenAI Alignment, raport Self-replicating prompt injections exist, odczyt 15.10.2026: https://alignment.openai.com/misalignment-reports/self-replicating-prompt-injections-exist/
- Anthropic Docs, Prompt engineering: system prompts, odczyt 15.10.2026: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/system-prompts
- Anthropic Docs, Prompt engineering overview, odczyt 15.10.2026: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/overview
- Google AI Docs, Prompt design strategies, odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/prompting-strategies
- Google AI Docs, System instructions, odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/system-instructions
- Google Support, Manage what Gemini remembers about you and customize responses, odczyt 15.10.2026: https://support.google.com/gemini/answer/16598625
- Anthropic Support, Understanding Claude’s personalization features, odczyt 15.10.2026: https://support.claude.com/en/articles/10185728-understanding-claude-s-personalization-features
- OWASP Gen AI Security Project, LLM01:2025 Prompt Injection, odczyt 15.10.2026: https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Business Insider, artykuł o czacie salonu Chevrolet z 18.12.2023, odczyt 15.10.2026: https://www.businessinsider.com/car-dealership-chevrolet-chatbot-chatgpt-pranks-chevy-2023-12
- Z. Yin, H. Wang, K. Horio, D. Kawahara, S. Sekine, Should We Respect LLMs?, arXiv, v1 z 22.02.2024, odczyt 15.10.2026: https://arxiv.org/abs/2402.14531
- M. Zheng, J. Pei, L. Logeswaran, M. Lee, D. Jurgens, When „A Helpful Assistant” Is Not Really Helpful, arXiv, v1 z 16.11.2023, odczyt 15.10.2026: https://arxiv.org/abs/2311.10054
- technetblog.pl, Podstawy AI, hub serii, odczyt 15.10.2026: https://technetblog.pl/podstawy-ai/