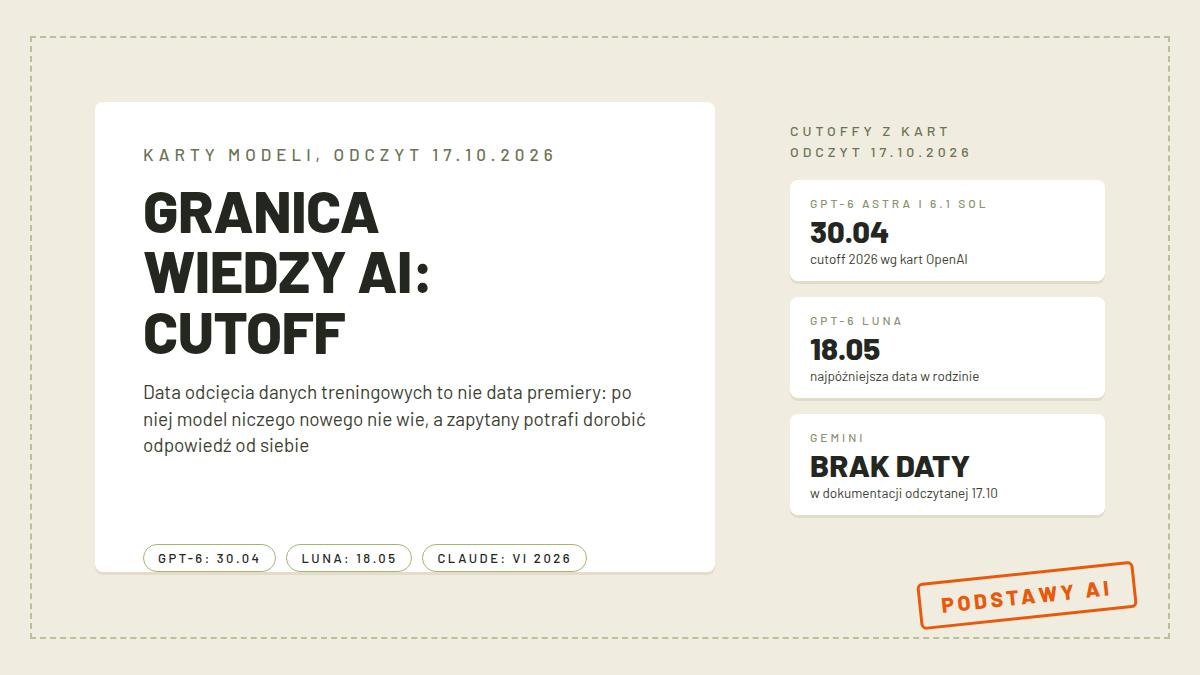
Model językowy nie dokształca się między rozmowami. Znajomość świata dostaje na starcie, z ogromnego zbioru tekstów zebranych do konkretnego dnia, a kiedy trening się kończy, ta wiedza zostaje zamrożona w wersji modelu, do której piszesz. Granica wiedzy, po angielsku knowledge cutoff, to właśnie ta data odcięcia: ostatni moment, o którym model może coś wiedzieć z samego treningu. Pytanie o wydarzenie sprzed tygodnia wypada już za tą linią, więc model albo przyzna, że nie wie, albo, co bywa gorsze, ułoży odpowiedź zmyśloną, ale brzmiącą całkiem pewnie. Halucynacja to druga strona tej samej monety: tam, gdzie wiedzy brak, model potrafi ją dorobić i nie zasygnalizuje, że improwizuje.
W tym artykule tłumaczę, skąd granica wiedzy się bierze i dlaczego producenci podają ją wprost przy każdym modelu, gdzie znaleźć datę odcięcia dla rodzin GPT-6, Claude i Gemini (wszystkie liczby pochodzą z kart i dokumentacji przeczytanej 17 października 2026, każda ma odesłanie do źródła), jak modele dowiadują się o rzeczach nowszych niż ich cutoff i czy da się granicę przesunąć, dostrajając model na świeższych danych. Przy okazji rozplączę zagadkę linii GPT-6, w której dwie karty producenta podają różne daty i żadna nie kłamie.
- Najważniejsze informacje
- Tabela cutoffów znanych modeli
- Skąd się bierze granica wiedzy
- Jak sprawdzić granicę wiedzy swojego modelu
- Co model wie po dacie odcięcia i jak dowiaduje się nowszych rzeczy
- Czy granicę wiedzy da się przesunąć
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Granica wiedzy (knowledge cutoff) | Data, po której w danych treningowych modelu nie ma już nowych materiałów; to nie jest data premiery modelu |
| GPT-6 Astra (OpenAI) | „Apr 30, 2026 knowledge cutoff” wg karty modelu |
| GPT-6.1 Sol (OpenAI) | „Apr 30, 2026 knowledge cutoff” wg karty modelu |
| GPT-6 Sol (starszy wariant linii) | „Apr 20, 2026 knowledge cutoff” wg starszej karty, która nadal jest dostępna |
| GPT-6 Luna (OpenAI) | „May 18, 2026 knowledge cutoff” wg karty modelu |
| Claude Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 (Anthropic) | Training data cutoff i reliable knowledge cutoff: Jun 2026 wg Models overview |
| Google Gemini | Nie podano na stronach dokumentacji przeczytanych 17.10 |
| Jak obchodzić granicę | Wyszukiwarka w czacie, wgrane pliki, RAG; sama rozmowa granicy nie przesuwa |
Tabela cutoffów znanych modeli
| Rodzina/model | Cutoff wg dokumentacji, odczyt 17.10.2026 |
|---|---|
| GPT-6 Astra (OpenAI) | Apr 30, 2026, karta modelu |
| GPT-6.1 Sol (OpenAI) | Apr 30, 2026, karta modelu |
| GPT-6 Sol (starszy wariant) | Apr 20, 2026, starsza karta |
| GPT-6 Luna (OpenAI) | May 18, 2026, karta modelu |
| Claude Fable 5.1 (Anthropic) | Jun 2026, training i reliable |
| Claude Opus 5.5 (Anthropic) | Jun 2026, training i reliable |
| Claude Sonnet 5.5 (Anthropic) | Jun 2026, training i reliable |
| Claude Haiku 5.5 (Anthropic) | Jun 2026, training i reliable |
| Claude Opus 5 (poprzednia) | May 2026, Transparency Hub |
| Claude Sonnet 5 i Fable 5 | Jan 2026, Transparency Hub |
| Claude Opus 4.5 i Opus 4.6 | May 2025, Transparency Hub |
| Gemini 4 Argon i rodzina | Nie podano w dokumentacji |
Dwie uwagi do tabeli. Po pierwsze, Anthropic podaje osobno training data cutoff, czyli do kiedy sięgnął zbiór treningowy, i reliable knowledge cutoff, czyli do kiedy model zna świat naprawdę pewnie, a te dwie daty w starszych generacjach się rozjeżdżały: Opus 4 i Sonnet 4 miały zbiór do marca 2025, ale reliable knowledge cutoff dopiero na styczniu 2025, co Transparency Hub objaśnia zdaniem, że wiedza modelu jest „most extensive and reliable” właśnie do tej drugiej daty. Po drugie, Google na liście modeli Gemini API (dokument z adnotacją aktualizacji 13.10.2026) ani w przewodniku Gemini 4 Argon nie podał żadnej daty odcięcia, więc zapisałem wprost „nie podano” zamiast zgadywać. Granica wiedzy modeli Google nie jest tym samym co brak granicy, po prostu w przeczytanej przeze mnie dokumentacji jej nie ma.
Skąd się bierze granica wiedzy
Sedno opisuje hasło Knowledge cutoff w Wikipedii: punkt w czasie, po którym model językowy nie był już trenowany na nowych danych. Model jest pretrenowany na statycznym zdjęciu internetu, książek i innych zbiorów zrobionym do określonego dnia, więc wiedza o późniejszych wydarzeniach w danych po prostu nie występuje i nie ma jej skąd pobrać, dopóki model nie dostanie dostępu do źródeł na żywo. Cały proces, od zbierania danych przez pretrening po dostrajanie i testy, rozkładamy osobno w tekście jak AI się uczy; tutaj wystarczy konstatacja: między momentem zebrania danych a premierą modelu mijają miesiące, bo trening, ewaluacje i praca nad bezpieczeństwem trwają, a nic z tego nie da się zrobić na danych, które wpadły do zbioru w ostatnich tygodniach przed uruchomieniem.
Producenci podają datę odcięcia z kilku powodów naraz. Użytkownik wie, o czym nie pytać bez włączonej wyszukiwarki, deweloper planuje integrację inaczej, gdy widzi, że jego domena zmienia się szybciej niż cykl wydań modelu, a przy zastosowaniach wrażliwych, medycyna jest tu podręcznikowym przykładem z Wikipedii, badania pokazały, że modele z późniejszym cutoffem odpowiadały celniej na pytania oparte na nowszych wytycznych klinicznych, granica staje się parametrem bezpieczeństwa, a nie ciekawostką. Do tego dochodzi prosta uczciwość rachunkowa: trening największych systemów jest na tyle drogi, że badacze ze Stanforda i Epoch AI szacowali już w 2024, że koszty największych treningów pójdą w miliardy dolarów przed 2027 rokiem, więc nikt nie przeprowadza go po to, żeby odświeżyć model o dwa miesiące.
Jak sprawdzić granicę wiedzy swojego modelu
Najpewniejsza droga prowadzi przez dokumentację producenta, konkretnie przez kartę modelu. Karty OpenAI mają sekcję Model details z pozycją typu „Apr 30, 2026 knowledge cutoff”, katalog modeli ma tryb porównywania dwóch modeli obok siebie z wierszem Knowledge Cutoff, a Anthropic w Models overview prowadzi tabelę całej aktualnej linii z wierszami Reliable knowledge cutoff i Training data cutoff. Przy produktach konsumenckich dołóż daty z dokumentacji produktowej: learn.chatgpt.com prowadzi notę Models, z której widać, że zestaw modeli w Twoim planie się zmienia (przykład z odczytu 17.10: GPT-5.5 przeszła na emeryturę w Codexie 14 października 2026 o 19:00 UTC, a na jej miejsce wchodzi tam GPT-6.1 Sol, dostępny na planach Plus, Pro, Business, Enterprise i Edu, nie na Free i Go). Jak ta machina z modelami w tle działa od środka, opisujemy w tekście jak działa ChatGPT. Pytanie „do kiedy zna świat ChatGPT” jest więc pytaniem niepełnym, bo zależy od tego, jaki model stoi w danej chwili za Twoją rozmową; datę sprawdza się przy konkretnym modelu, nie przy produkcie.
Na tym tle warto rozłożyć przypadek linii Sol, bo to lekcja czytania dokumentacji dla całego tematu. Wcześniejsza praca przy innym artykule zanotowała 15 października pozorną sprzeczność: notka pomocy wymieniała Astrę i Sol z cutoffem 30.04.2026 i Lunę z 18.05.2026, a karta modelu o adresie gpt-6-sol pokazywała 20.04.2026. Sprawdziłem obie drogi 17.10 i rozbieżność się rozpuszcza: na developers.openai.com istnieją równolegle dwie karty, starsza GPT-6 Sol z cutoffem 20 kwietnia i nowsza GPT-6.1 Sol z cutoffem 30 kwietnia, przy czym starsza karta sama odsyła zdaniem „See GPT-6.1 Sol for the newer Sol model”. Daty z tamtej notki pomocy pokrywają się dokładnie z trójką Astra, 6.1 Sol, Luna, czyli wszystko wskazuje, że w jednym zapisie „Sol” znaczył 6.1, a w drugim porównującemu pokazała się karta poprzednika. Praktyczny wniosek: czytaj identyfikator modelu na karcie, nie samą nazwę rodzinną, bo „Sol” i „6.1 Sol” to dwa różne zbiory danych.
Sam model też możesz zapytać, do kiedy sięga jego wiedza, i w czatach taka odpowiedź często pada od ręki, bo data siedzi w notce systemowej. Traktuj ją jednak jako wskazówkę, nie źródło: modele potrafią w tej odpowiedzi pomylić wersje albo przytoczyć datę innej generacji z tej samej rodziny. Ostatecznym źródłem pozostaje dokumentacja; z modelem natomiast sprawdzić możesz, jak radzi sobie z faktami tuż przy granicy, pytając o wydarzenie, którego datę znasz, i oglądając, czy odpowiedź jest aktualna, czy już zmyślona.
Co model wie po dacie odcięcia i jak dowiaduje się nowszych rzeczy
Granica wiedzy nie tnie świata ostrym nożem. Model może coś wiedzieć o wydarzeniu sprzed daty odcięcia, ale płytko, albo znać je z plotek i przecieków zamiast z potwierdzonych komunikatów. Stąd rozróżnienie Anthropica między training data cutoff a reliable knowledge cutoff: obszar tuż przy granicy to wiedza słabnąca, nie pełna. W drugą stronę jest jeszcze prościej: informacji o wydarzeniach po dacie odcięcia w danych treningowych nie ma wcale, a model zapytany o nie nie odpowie pustką, tylko skonstruuje coś prawdopodobnego, bo tak został zbudowany. Wikipedia wymienia wprost halucynacje, luki informacyjne i spadek celności na wiedzy, która się zmienia, jako główne skutki tej granicy.
Dobra wiadomość jest taka, że granicę można objechać, nie przesuwając jej. Modele w czatach mają coraz częściej wbudowane wyszukiwanie, a karty OpenAI dla całej trójki GPT-6 wymieniają w sekcji Supported tools między innymi web_search, file_search i computer use, do tego MCP, czyli podpięcie zewnętrznych narzędzi i danych. Dokumenty wgrane do rozmowy działają na tej samej zasadzie: model nie zna treści z treningu, ale czyta to, co mu dasz w kontekście. Ten mechanizm pobierania wiedzy z zewnętrznego źródła na żądanie nazywa się RAG i tłumaczymy go osobno, a w słowniku podstaw AI znajdziesz też pozostałe pojęcia z tego obszaru. Przy okazji: okno kontekstowe modeli GPT-6 ma 1 050 000 tokenów, więc miejsca na wgrane materiały jest realnie dużo, o ile wiesz, czym w ogóle jest token i jak go liczą producenci.
Czy granicę wiedzy da się przesunąć
Teoretycznie jest fine-tuning: dostrajasz istniejący model na własnym zbiorze z nowszymi danymi i mówisz, że model „wie więcej”. W praktyce to najdroższa i najmniej przewidywalna droga z możliwych, a przy flagowych modelach GPT-6 w ogóle zamknięta: karty Astry, 6.1 Sol i Luny wykazują w tabeli endpointów Fine-tuning „Not supported”, co przeczytałem 17.10 wprost w dokumentacji. Dostrajanie sprawdza się w nadawaniu stylu, formatu i znajomości domeny, a nie w wpajaniu kalendarza faktów; dane zapisane w wagach nie dają gwarancji, że model odpowie o nie poprawnie w każdej sformułowanej inaczej rozmowie. Właśnie dlatego do świeżych faktów używa się RAG-a i wyszukiwania, które pobierają informację w momencie pytania, a nie próbują ją wpoić modelowi na zapas. Jak wygląda dostrajanie od kuchni, gdy już jest dostępne, opisujemy w osobnym tekście o fine-tuningu.
Nie myl też granicy wiedzy z pamięcią rozmowy ani z ustawieniami personalizacji. Zapisy w pamięci czatu to notatki o Tobie i Twoich preferencjach, które model dostaje do wglądu w kolejnych rozmowach, to mechanizm przypominania na poziomie konta, a nie zmiana tego, co model wie o świecie; po wyłączeniu pamięci wiedza modelu wraca do stanu z treningu. Realnym sposobem przesuwania granicy pozostaje kolejna generacja modelu, i widać to zresztą w tabeli wyżej: w obrębie jednej linii Sol cutoff przesunął się z 20 kwietnia przy GPT-6 Sol do 30 kwietnia przy GPT-6.1 Sol, a Luna od startu miała 18 maja. Producenci trenują nowe wersje na świeższych zbiorach, a stare modele stopniowo schodzą, jak GPT-5.5 14 października. Dla Ciebie jako użytkownika z tego płynie prosta kolejność działań: najpierw wyszukiwarka i wgrane pliki, potem RAG, jeśli budujesz własne rozwiązanie, a dostrajanie rozważaj tylko wtedy, gdy granica wiedzy jest Twoim realnym problemem biznesowym, nie gdy chodzi o ogarnięcie tygodnia z życia branży.
FAQ
Co to jest granica wiedzy AI?
Granica wiedzy to data odcięcia danych treningowych modelu: ostatni moment, o którym model coś wie z samego treningu. Wydarzenia późniejsze nie istnieją w jego danych, więc bez narzędzi typu wyszukiwanie albo RAG model nie ma jak się o nich dowiedzieć, a zapytany potrafi zmyślić odpowiedź brzmiącą wiarygodnie.
Do kiedy zna świat ChatGPT?
Zależy od modelu, który akurat obsługuje Twoją rozmowę, a ten zmienia się wraz z rolloutami. Dla rodziny GPT-6 karty OpenAI podają z odczytu 17.10.2026: Astra i 6.1 Sol po 30 kwietnia 2026, starszy Sol po 20 kwietnia 2026, Luna po 18 maja 2026. Który model masz w czacie, zobaczysz w interfejsie, a datę jego granicy sprawdzisz na karcie tego konkretnego modelu.
Dlaczego modele nie znają najnowszych wydarzeń?
Bo wiedza modelu powstaje raz, podczas treningu na zbiorze zmontowanym do określonego dnia. Trening trwa miesiące i kosztuje miliardy dolarów w przypadku największych systemów, więc nie powtarza się go co tydzień. Po zakończeniu treningu wagi są zamrożone i nic, co wydarzyło się później, nie dostaje się do wiedzy modelu samo z siebie.
Jak zapytać model o jego cutoff?
Możesz zapytać wprost: „do kiedy sięga Twoja wiedza” albo „jaki jest Twój knowledge cutoff”. Większość modeli odpowie poprawnie, bo data jest wpisana w ich konfigurację, ale odpowiedź bywa nieścisła, więc przy decyzjach, na których Ci zależy, potwierdź ją w karcie modelu albo dokumentacji producenta. To jedyne źródła, które nie mylą wersji.
Czy cutoff da się ominąć?
Samo promptowanie nie, bo model nie ma dostępu do tego, czego nie ma w jego danych. Ominiesz granicę narzędziami: wyszukiwarką wbudowaną w czat, dokumentami wgranymi do rozmowy albo RAG-em we własnej aplikacji, które pobierają świeże informacje na żądanie. Dostrajanie modelu na nowszych danych brzmi jak rozwiązanie, ale jest drogie, bywa niedostępne dla flagowych modeli i nie gwarantuje poprawnych odpowiedzi o faktach.
Źródła
- Karta modelu GPT-6 Astra (pole knowledge cutoff, sekcja Model details), odczyt 17.10.2026: https://developers.openai.com/api/docs/models/gpt-6-astra
- Karta modelu GPT-6.1 Sol, odczyt 17.10.2026: https://developers.openai.com/api/docs/models/gpt-6.1-sol
- Karta modelu GPT-6 Sol, starszy wariant linii (odsyłacz do 6.1 Sol), odczyt 17.10.2026: https://developers.openai.com/api/docs/models/gpt-6-sol
- Karta modelu GPT-6 Luna, odczyt 17.10.2026: https://developers.openai.com/api/docs/models/gpt-6-luna
- Katalog modeli OpenAI API (lista rodzin i opisy), odczyt 17.10.2026: https://developers.openai.com/api/docs/models
- Porównanie modeli GPT-6.1 Sol i GPT-6 Sol (wiersz Knowledge Cutoff), odczyt 17.10.2026: https://developers.openai.com/api/docs/models/compare?model=gpt-6.1-sol&model2=gpt-6-sol
- Dokumentacja produktowa ChatGPT i Codex, strona Models (emerytura GPT-5.5 z 14.10.2026, zakres rolloutu 6.1 Sol), odczyt 17.10.2026: https://learn.chatgpt.com/docs/models
- Models overview, dokumentacja Anthropic (wiersze Reliable knowledge cutoff i Training data cutoff dla Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5), odczyt 17.10.2026: https://platform.claude.com/docs/en/about-claude/models/overview
- Anthropic Transparency Hub (zdania „Knowledge Cutoff Date” dla starszych modeli, w tym rozróżnienie Opus 4 i Sonnet 4: zbiór marzec 2025, reliable knowledge styczeń 2025), odczyt 17.10.2026: https://www.anthropic.com/transparency
- Lista modeli Gemini API, Google AI for Developers (dokument z aktualizacją 13.10.2026, brak dat cutoffu), odczyt 17.10.2026: https://ai.google.dev/gemini-api/docs/models
- Gemini 4 Argon, przewodnik modelu w dokumentacji Google Cloud (brak daty odcięcia), odczyt 17.10.2026: https://cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-argon
- Hasło Knowledge cutoff, Wikipedia (rewizja 19.09.2026: definicja, halucynacje, badanie kliniczne, koszty treningów Stanford i Epoch AI), odczyt 17.10.2026: https://en.wikipedia.org/wiki/Knowledge_cutoff