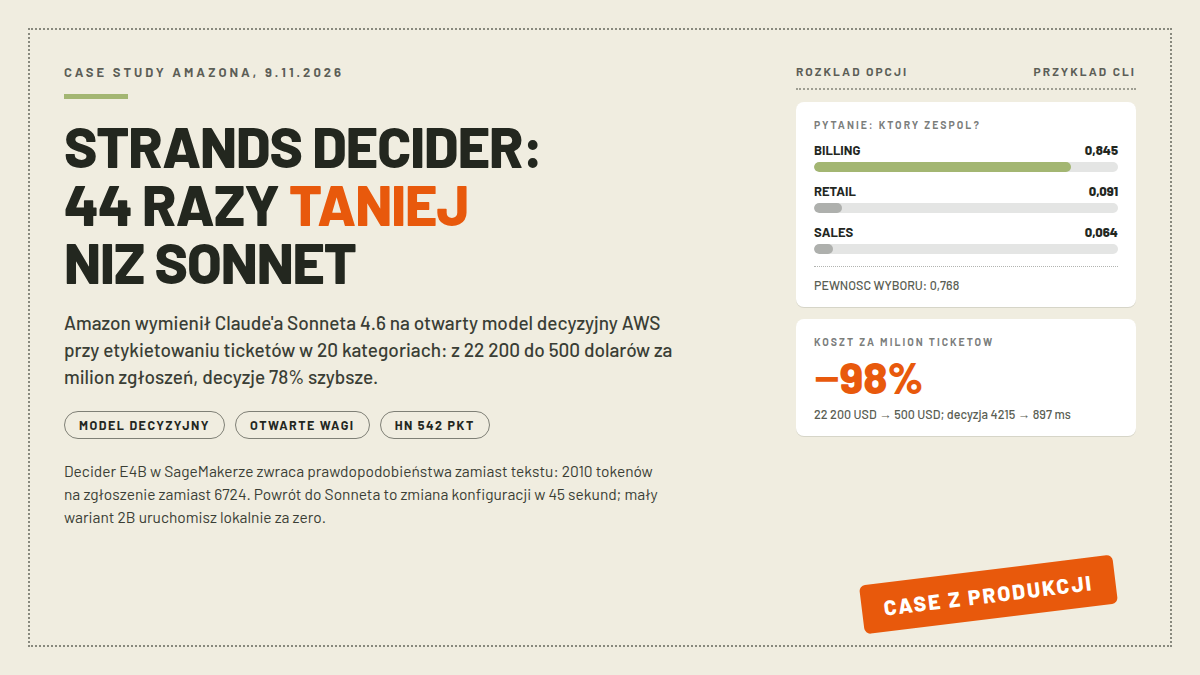
Dziewiątego listopada zespół Strands Agents, otwarta linia narzędzi agentowych AWS, opublikował opis wymiany modelu w jednym z największych wewnętrznych systemów ticketowych Amazona. Dwóch inżynierów, Carr Onstott i Mehul Jaiswal, podmieniło Claude’a Sonneta 4.6 na Strands Decider, mały otwarty model decyzyjny własnej produkcji, przy etykietowaniu zgłoszeń w dwudziestu kategoriach. W ich pomiarach decyzja wyszła 44 razy tańsza, 78% szybsza i 70% lżejsza w tokenach, a cofnięcie zmiany to edycja jednego ustawienia. Ten tekst tłumaczy, czym w ogóle jest model decyzyjny, skąd biorą się te liczby, co wynika z nich dla kogoś, kto dziś płaci za klasyfikację dużym LLM, i gdzie kategoria ma granice. Modelu nie testowaliśmy; wszystkie liczby pochodzą z posta Amazona, kart modeli na Hugging Face i dyskusji na Hacker News, z odczytami z 10 listopada.
- Najważniejsze informacje
- Czym jest Strands Decider
- Wymiana Sonnet 4.6 na Decider: liczby
- Kiedy taki model ma sens, a kiedy odpada
- Hacker News: reklama czy przełom
- Co z tego dla Polski
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Co się stało | 9.11.2026 Amazon opisał wymianę Sonnet 4.6 → Strands Decider przy etykietowaniu ticketów w 20 kategoriach |
| Koszt | 0,0222 USD → ok. 0,0005 USD za ticket; na milion ticketów 22 200 → 500 USD (44 razy taniej) |
| Czas | 4215 → 897 ms na decyzję (minus 78%); czas Lambda spadł o 74% |
| Tokeny | 6724 → 2010 na ticket (minus 70%); odpowiedź to 1 wybór zamiast 170 tokenów |
| Model produkcyjny | Strands Decider E4B na bazie Gemma 4; wagi Apache-2.0 na Hugging Face |
| Sprzęt | SageMaker ml.g5.xlarge (A10G 24 GB), ok. 19 GiB wag, ok. 640 ms na żądanie |
| Wariant 2B | baza Qwen3.5-2B, mediana ok. 115 ms na RTX 3090, ok. 153 ms na M3 MacBooku |
| Powrót do Sonneta | przełącznik BEDROCK/DUAL/DECIDER w AppConfig; cofnięcie = zmiana konfiguracji w 45 s |
Czym jest Strands Decider
Model decyzyjny nie generuje tekstu. Dostaje stan, na przykład treść zgłoszenia, plus pytanie z zamkniętym zestawem opcji, a w odpowiedzi zwraca prawdopodobieństwo dla każdej opcji i ocenę pewności. To kategoria, którą we wrześniu otworzył Jev od TypeSafe, potem dołączyło Decisions API od OpenAI, pierwszego października Strands Decider, a dziewiątego Microsoft-Decision-1. TechCrunch nazwał go wprost klonem Jeva. Cztery duże wejścia w niecały miesiąc to sygnał, że sortowanie i ocenianie tekstu bez generowania go wyrosło na osobny rynek.
Architektura 2B jest banalna na papierze i pomysłowa w efekcie. Autorzy posta premierowego (Marc Brooker, Mike Chambers i Fabio Nonato de Paula) wzięli torso Qwen3.5-2B, odcięli mu warstwę generującą tokeny i zastąpili ją głowicą punktową o nieco ponad milionie parametrów, która porównuje ukryty stan każdego wariantu odpowiedzi z ukrytym stanem pozycji odpowiedzi. Całość dotrenowano adapterem LoRA o randze 16, a wersja udostępniona publicznie to już dziewiętnasta iteracja; pierwsza, z inną głowicą, wypadała wyraźnie gorzej. Repo na GitHubie stanęło 29 września, licencja Apache-2.0 obejmuje też dane treningowe i skrypty. Na publicznym zbiorze benchmarku JevBench utrzymywanym przez TypeSafe ten rozmiar klasyfikuje 77,92% przykładów przy oknie 4096 tokenów, trzecie miejsce w klasie 2B i pierwsze wśród trzydziestu, gdy odliczyć modele tuż powyżej tej klasy. Mediana decyzji to ok. 115 ms na RTX 3090 i ok. 153 ms na M3 MacBooku.
Smaczek ekosystemowy: AWS mierzy własny model na benchmarku TypeSafe’a, a w zbiorze treningowym siedzi m.in. tasksource-jev-typed-decisions, dane nazwane od produktu konkurenta. Kategoria jest za młoda na wojny standardami, więc wszyscy liczą się na tym samym boisku.
Produkcyjny wariant, na którym zrobił się cały szum, to większy brat: Decider E4B na bazie Gemma 4. Karta modelu pokazuje ewaluacje wewnętrzne AWS: 68,4% trafności na krótkich zadaniach odłożonych poza trening (n=6000), 87,2% na klasyfikacji klauzul kontraktowych ContractNLI, 98,9% przy rozpoznawaniu, czy tekst to wiadomość commita, i 37,1% przy ocenie, czy rozwiązanie kodu jest poprawne. Ta ostatnia liczba jest uczciwą definicją kategorii: model wybiera spośród opcji, a nie rozumie kod jak model czatowy.
Wymiana Sonnet 4.6 na Decider: liczby
Zgłoszenia w tym systemie to eskalacje klientów, prośby o zasoby, alarmy automatyczne i ustalenia bezpieczeństwa, a każde musiało wpaść w jedną z 20 kategorii. Sonnet 4.6, model sprzed dziewięciu miesięcy, obsługiwał każde zgłoszenie z długim promptem systemowym i zwracał JSON plus rozumowanie. Zespół zaczął od Decidera 2B, ale na testowym zbiorze ticketów wariant E4B wyszedł wyraźnie lepiej, więc do produkcji poszedł on. Serwer to SageMaker ml.g5.xlarge, czyli jedna karta A10G 24 GB na instancję, model zajmuje ok. 19 GiB, a pojedyncze żądanie zajmuje ok. 640 ms; instancja przerabia ok. 5 600 ticketów na godzinę i skaluje się z ruchem, przy sieci odciętej od świata, z wagami wczytywanymi z S3.
Praca była bardziej promptowa niż modelowa. Opisy 20 kategorii produkcyjnych same w sobie przekraczają okno 4096 tokenów Decidera, więc każdą etykietę przepisano na kryterium z jednego albo dwóch zdań, a do kompletu doszła opcja „none”. Przy długich ticketach model gubi najstarsze komentarze, żeby zmieścić resztę. Tabela z posta wygląda tak:
| Miara | Sonnet 4.6 | Decider E4B |
|---|---|---|
| Średni czas decyzji | 4215 ms | 897 ms |
| Tokeny wejściowe na ticket | 6554 | 2009 |
| Tokeny wyjściowe na ticket | 170 | 1 |
| Koszt za ticket | 0,0222 USD | ok. 0,0005 USD |
| Koszt za milion ticketów | 22 200 USD | ok. 500 USD |
Bezpiecznik procesowy jest tu ciekawszy niż sama tabela. Lambda czyta z AppConfig tryb trzywartościowy: BEDROCK oznacza stary tor, DUAL puszcza oba modele równolegle i porównuje wynik na żywym ruchu, DECIDER zostawia tylko nowy. Zespół oceniał każdą niezgodność z trybu DUAL i pisze, że dało mu to więcej niż jakikolwiek test offline; cofnięcie to zmiana konfiguracji w 45 sekund. Dzień wyłączenia Sonneta widać na wykresie czasów Lambda: średnia spadła o 74%.
Drobiazg, który wykroczył poza ten jeden projekt: kolejność kluczy w JSON-ie zmieniała wynik. Te same dane posłane z kluczami w innym porządku przesuwały zwracane prawdopodobieństwa do 0,19, więc wszystkie żądania idą teraz z kluczami posortowanymi. Kto testuje model decyzyjny za API, powinien to sprawdzić, zanim porówna dwa przebiegi.
To ceny katalogowe, bez rabatów za cache i tryb wsadowy, za to też bez kosztów Lambda, które skróciły się o te same 74%. Pieniądze nie znikają z grupy Amazona, przechodzą z faktur za tokeny Anthropicu na godziny instancji SageMakera; oszczędność jest realna dla budżetu zespołu ticketowego, a jednocześnie to case study produktu tej samej firmy, na co komentujący HN zwracali uwagę sami. Ostateczne liczby pochodzą od zespołu wdrażającego, niezależnej replikacji nie ma (odczyt 10.11).
Kiedy taki model ma sens, a kiedy odpada
Zespół sam nazywa warunki: zamknięty wybór ze znanego katalogu, wysoki wolumen i czas odpowiedzi, który realnie miał znaczenie. Jeśli etykiety wymagają tekstu wyjaśnienia, katalog zmienia się co tydzień albo sensowny kontekst nie mieści się w kilku tysiącach tokenów, model decyzyjny nie zastąpi pracy LLM. To ostra lista, a jednocześnie pierwsze dwa punkty spełnia spora klasa zadań, które dziś płacą stawki za token tam, gdzie wystarczyłby wybór z listy: routing zgłoszeń, wybór narzędzia przez agenta, filtry guardrails, klasyfikacja polityk. Autorzy posta premierowego proponują agentów hybrydowych: LLM podejmuje trudne decyzje, Decider przejmuje te rutynowe.
Rynek jest przy tym młody i nierówny. W pomiarze Microsoftu na 36 zbiorach i 147 137 pytaniach Strands-Decider 2B odpowiadał tylko na 23 z nich, choć to mniejszy wariant. Wybierając kandydata na własne etykietowanie, nie patrz na kategorię, tylko na konkretny model i własny zbiór testowy, bo rozrzut trafności między czterema dostępnymi modelami jest większy niż różnica cen między nimi.
Hacker News: reklama czy przełom
Wątek zebrał 542 punkty w odczycie z 10 listopada i zaczyna się od nieufności. „This is more of less an advert, using their internal adoption as a case study”, pisze swiftcoder, i w tym jest ziarno prawdy: autorzy sprzedają framework tego samego koncernu, który zaoszczędził. Inny komentujący pyta, czemu zespół nie przeszedł na nowszego Sonneta, a odpowiedź (brak wsparcia API wsadowego dla nowszych modeli na Bedrock) jest tylko zgadywaniem innego użytkownika, nie informacją od Amazona.
Ciekawsza część dyskusji sięga głębiej niż ten jeden przypadek. armcat opisuje klasyfikator ticketowy zbudowany na SVM sześć lat temu, trenujący się w minuty i odpowiadający w milisekundach, z publikacją przyjętą na ICSE 2021. W jego opowieści siedzi cała pętla historii: branża porzuciła takie systemy dla LLM, teraz wraca do tanich klasyfikatorów, tylko że z nowym fasonem. Argument za LLM też słychać w wątku i jest mocny: duży model pozwala zacząć bez danych treningowych i bez data scientist, przy zmieniającym się katalogu kategorii. Wynika z tego prosta sekwencja: najpierw drogi prototyp na dużym modelu, potem tania produkcja na małym. Dokładnie ten ruch zrobił Amazon: długo płacił za duży model, aż system ustabilizował się na tyle, że wymiana na mały stała się bezpieczna.
Co z tego dla Polski
Droga wejścia jest krótka, bo wagi są darmowe. Repo strands-labs/strands-decider na GitHubie (926 gwiazdek, odczyt 10.11), dwa zestawy wag na Hugging Face w organizacji StrandsAgents i instalacja przez pip install strands-decider; wariant 2B odpala lokalnie na procesorze albo karcie, bez chmury. Przykład z dokumentacji: zgłoszenie „Help! My payouts have been failing for 3 days!” wraca jako billing z prawdopodobieństwem 0,845 i pewnością 0,768, retail i sales schodzą do ułamków. Interfejs i dokumentacja są po angielsku, a karty modeli nie deklarują języków, więc jakości na polskich zgłoszeniach nie potwierdzamy.
Cięcia kosztów pokazane przez Amazona przekładają się na każdy projekt, który dziś klasyfikuje płacąc za tokeny: wybierając narzędzia dla agentów, stawkę za token można teraz zastąpić darmowymi wagami i godzinami własnej karty, a cały ekosystem agentów opisywaliśmy niedawno osobno. Popytu po polsku jeszcze nie ma: prasa PL milczy (odczyt Google News z 10.11), a podpowiedzi Google pokazują już całą rodzinę „strands decider”, od „2b” przez „aws” i „bedrock” po „strands decider vs jev”.
Najczęstsze pytania
Strands Decider vs Jev: czym się różnią?
Licencją i modelem dystrybucji. Jev od TypeSafe to komercyjny model za API, dostęp według stanu z końca września rozdawany z listy oczekujących; Strands Decider od AWS to wagi Apache-2.0 do ściągnięcia i uruchomienia na własnym sprzęcie. Ekosystem jest wspólny: AWS mierzy trafność na JevBench TypeSafe’a i trenował na zbiorze nazwanym od Jeva.
Czy Strands Decider jest dostępny na Bedrock?
W opisanym wdrożeniu Amazon serwuje go przez SageMaker, nie przez Bedrock. Wagi i kod są otwarte, więc można je hostować gdziekolwiek; ogłoszonej oferty zarządzanej na 10 listopada nie ma.
Ile kosztuje Strands Decider?
Wagi są darmowe (Apache-2.0), płacisz za sprzęt. W przypadku Amazona: ml.g5.xlarge po 1,408 USD za godzinę instancji, ok. 250 USD za milion ticketów przy pełnym obłożeniu i ok. 500 USD z rezerwą na skoki ruchu. Wariant 2B uruchomisz lokalnie za zero, na CPU lub GPU, którego już masz.
Czym jest Strands Decider 2B?
Mniejszy wariant modelu decyzyjnego AWS: torso Qwen3.5-2B bez warstwy generującej tekst, głowica punktowa o nieco ponad milionie parametrów, adapter LoRA o randze 16. Decyduje w medianie ok. 115 ms na RTX 3090, trafność na publicznym JevBench 77,92% przy oknie 4096 tokenów.
Źródła
- Strands Agents, „Amazon saves millions by replacing Sonnet 4.6 with Strands Decider” (09.11.2026, autorzy Carr Onstott i Mehul Jaiswal; tabele czasów, tokenów i kosztów, tryb DUAL, przesunięcia od kolejności kluczy JSON)
- Strands Agents, „Introducing Strands Decider 2B: a small, open source, decision model” (01.10.2026, architektura głowicy punktowej, latencje 115/153 ms, wyniki JevBench)
- Repo strands-labs/strands-decider na GitHubie (odczyt 10.11.2026: Apache-2.0, 926 gwiazdek, utworzone 29.09.2026)
- Karta modelu strands-decider-2B-qwen3.5-v1-2610 (odczyt 10.11.2026: Apache-2.0, baza Qwen3.5-2B, JevBench public 77,92% przy 4096)
- Karta modelu strands-decider-E4B-gemma4-v1-2610 (odczyt 10.11.2026: Apache-2.0, ewaluacje wewnętrzne: short tasks 68,4%, ContractNLI 87,2%, commit message 98,9%)
- TechCrunch, „Amazon releases its own Jev clone as decision models flood the web” (01.10.2026)
- Wątek Hacker News (odczyt 10.11.2026: 542 punkty; komentarze o charakterze case study, o nowszych Sonnetach i o historii klasyfikatorów SVM)