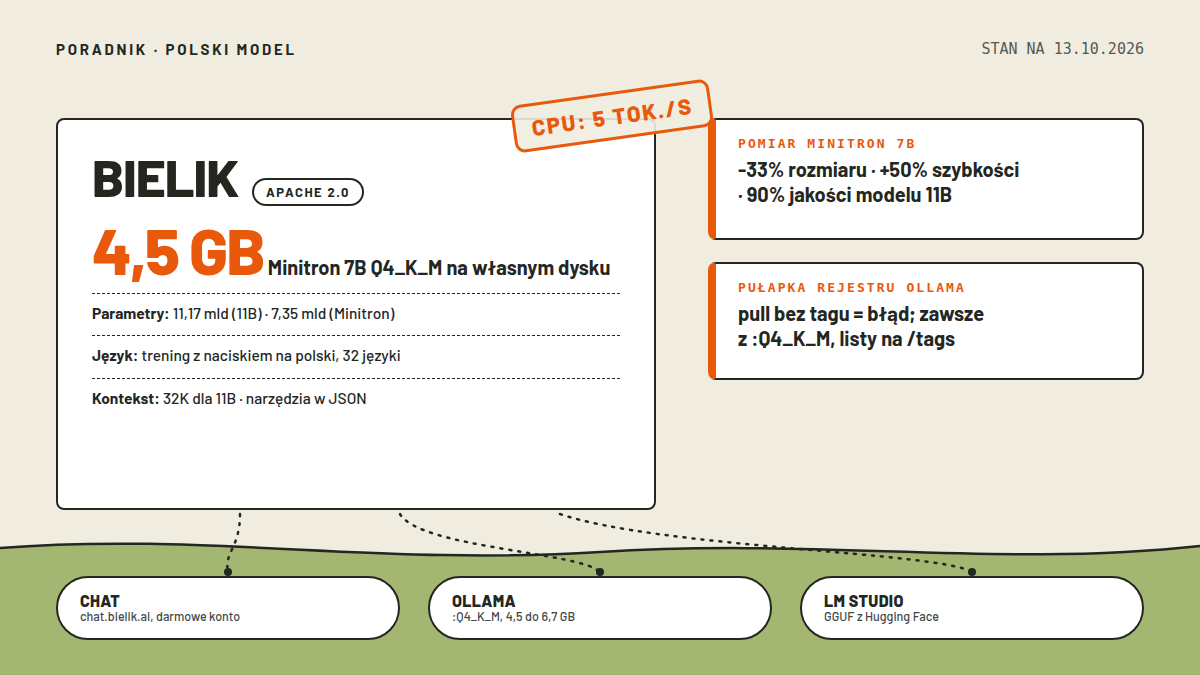
Wyniki na hasło „bielik ai” mieszają się dziś z ptakiem: model nazwano po orle bieliku, więc wyszukiwarka podsuwa i sztuczną inteligencję, i ornitologię. Ludzie pytający o tego pierwszego chcą zwykle jednego z dwóch: sprawdzić polski odpowiednik ChatGPT albo uruchomić model własnoręcznie, bez chmury i bez abonamentu. Dobra wiadomość jest taka, że Bielik spełnia oba scenariusze naraz. To model otwarty na licencji Apache 2.0, trenowany przede wszystkim po polsku, dostępny w darmowym chacie po zalogowaniu i do pobrania na własny komputer w wersji skompresowanej do 4,5 GB. Ta strona składa całość obrazu: rodzinę modeli, nasz test na zwykłym procesorze i pułapki instalacji, z uczciwym rozdzieleniem dokumentacji od własnych pomiarów.
Kilka liczb na rozgrzewkę, wszystkie ze strony projektu i kart modeli pobranych 13 października 2026. Bielik ma za sobą ponad 4,7 miliona pobrań, ponad 100 tysięcy użytkowników i społeczność liczoną w tysiącach osób. Rozwijają go Fundacja SpeakLeash i społeczność Bielika we współpracy z ACK Cyfronet AGH, a trening przeszedł na polskich superkomputerach Athena i Helios w ramach grantu PLGrid. Twórcą projektu jest m.in. Sebastian Kondracki, znany szerzej z polskiego zbioru instrukcji dla modeli językowych.
- Najważniejsze informacje
- Czym jest Bielik i kto za nim stoi
- Minitron 7B: jak przycięto 11 mld parametrów
- Co dokładnie trenowano: dane i metoda
- Nasz test: Minitron 7B na zwykłym procesorze
- Jak uruchomić Bielika lokalnie, krok po kroku
- Bielik bez instalacji: chat i Obywatel Bielik
- API i polska chmura
- Co mówią liczby o jakości
- Bielik a inne lokalne modele
- Co gdy nie działa
- Ściąga: Bielik w pięciu krokach
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Czym jest | rodzina polskich otwartych modeli AI (SpeakLeash, Apache 2.0) |
| Flagowy model | Bielik 11B v3.0 Instruct, 11,17 mld parametrów, kontekst 32K |
| Wariant kompaktowy | Bielik Minitron 7B v3.0: o 33% mniejszy, o 50% szybszy, ok. 90% jakości |
| Mniejsze warianty | 4.5B i 1.5B v3.0 Instruct (kontekst 8K) |
| Chat w przeglądarce | chat.bielik.ai, darmowy, wymaga konta SpeakLeash |
| Uruchomienie lokalne | Ollama, LM Studio, llama.cpp; GGUF Q4_K_M od 4,5 GB |
| Nasz test CPU | Minitron 7B Q4_K_M: 4,8 do 5,5 tok./s, płynna polszczyzna, jedna konfabulacja |
| API i chmura | Cyfronet, PSNC, Sherlock CloudFerro, Hugging Face, ARK Labs |
| Licencja | Apache 2.0, darmowa także do użytku komercyjnego |
Czym jest Bielik i kto za nim stoi
Bielik to polski model językowy rozwijany jako projekt społecznościowy z inicjatywy Fundacji SpeakLeash. Fundacja wymienia jako współtwórców Cyfronet, firmy Azurro i Enelpol oraz samą społeczność, a całość funkcjonuje jako przedsięwzięcie non-profit. Ma to praktyczny skutek dla ciebie: wagi modeli są publiczne, licencja Apache 2.0 pozwala używać ich komercyjnie bez opłat i bez pytania o zgodę, a pełna historia treningu jest opisana w dokumentacji.
Na rodziny modeli patrz przez pryzmat generacji. Aktualna linia to v3.0, z flagowym Bielikiem 11B o 11,17 miliarda parametrów oraz skompresowanym Minitronem 7B, o którym piszemy niżej. W rejestrach typu Ollama wciąż krążą starsze wersje v2.2 i v2.3, które łącznie pobrało więcej osób niż nowa linia, bo są na rynku dłużej; przy świeżej instalacji celuj w v3.0. Obok modeli rozmownych rodzina ma wyspecjalizowane odmiany: Bielik Guard w rozmiarach 0,1B i 0,5B to klasyfikatory bezpieczeństwa do filtrowania treści, a DFlash to maksymalnie odchudzone destylaty dla przemysłu.
Kwestia języka jest tu rdzeniem projektu, nie dodatkiem. Karty modeli mówią o treningu na korpusie obejmującym 32 języki europejskie z naciskiem na polszczyznę, a polskie dane były kuratorowane przez SpeakLeash, w tym instrukcje weryfikowane ręcznie. Większość popularnych modeli lokalnych uczy się głównie na angielskim i traktuje polski jako jeden z wielu języków świata. Bielik odwraca tę proporcję.
Minitron 7B: jak przycięto 11 mld parametrów
Najciekawszy model rodziny ma swoją premierę w nietypowym miejscu: na konferencji NVIDIA GTC w San Jose, 17 marca 2026, podczas sesji poświęconej suwerennej sztucznej inteligencji. Minitron 7B nie jest nowym trenowaniem od zera, tylko chirurgicznym zabiegiem na flagowym modelu: inżynierowie SpeakLeash i NVIDIA przetestowali ponad dziesięć konfiguracji przycinania i destylacji metodą Minitron na stosie NVIDIA NeMo, zanim wybrali architekturę, którą wewnętrznie nazywają złotym podziałem: 40 warstw z ograniczonym wymiarem pośrednim warstw feed-forward.
Liczby, którymi chwali się zespół: model o 33% mniejszy od 11B, wnioskowanie do 50% szybsze, około 90% jakości pierwowzoru. Karta techniczna podaje precyzyjniej: 7,35 miliarda parametrów wobec 11,04 miliarda u bazy, czyli redukcję o 33,4%. Do tego dochodzi akcent niezależności: wersja bazowa Minitrona uplasowała się na 6. miejscu wielojęzycznego zestawienia EuroEval wśród modeli podstawowych, jako pierwszy w tej dziesiątce model w pełni niezależny od wielkich amerykańskich koncernów.
Komu to potrzebne? Każdemu, komu brakuje pamięci na 11B. Minitron 7B w kwantyzacji Q4_K_M zajmuje 4,5 GB, mieści się w 16 GB ramu razem z systemem i wciąż obsługuje wywoływanie narzędzi w formacie JSON.
Co dokładnie trenowano: dane i metoda
Skoro mowa o jakości, zajrzyjmy do kuchni treningu opisanej w kartach modeli, bo to rzadkość, żeby projekt publikował takie szczegóły. Instrukcje do dostrajania flagowego 11B to ponad 20 milionów przykładów liczących łącznie ponad 17 miliardów tokenów, częściowo weryfikowanych ręcznie, a po dostrajaniu następowało dopasowanie preferencji DPO-Positive na ponad 114 tysiącach przykładów i uczenie ze wzmocnieniem GRPO na 143 tysiącach zadań z weryfikowalną nagrodą, od logiki przez matematykę po użycie narzędzi. Dla praktyka znaczy to jedno: Bielik v3.0 trenowano pod zadania, nie tylko pod pogaduszki, a obsługę narzędzi i ustrukturyzowanych odpowiedzi ma wpisaną w sam model, z gotowym szablonem konwersacji ChatML w Ollama. Druga strona medalu jest równie jawna: karty modeli ostrzegają, że model nie ma wbudowanej moderacji i odpowiedzi bywają nieprawdziwe, więc do zastosowań publicznych potrzebny jest filtr, na przykład właśnie Bielik Guard.
Nasz test: Minitron 7B na zwykłym procesorze
Deklaracje mają to do siebie, że są deklaracjami, więc postanowiliśmy sprawdzić najciekawszy wariant na własnej skórze. Pobraliśmy Minitrona 7B w kwantyzacji Q4_K_M, czyli 4,5 GB na dysku, i przepuściliśmy przez niego cztery polskie zadania na komputerze bez karty graficznej: sam procesor i 62 GB ramu, z czego w chwili testu wolne około 35 GB. Wersja Ollama 0.40.3; my uruchomiliśmy ją przenośnie, ale oficjalny instalator ze strony Ollama zachowa się identycznie.
Najpierw cyfry. Załadowanie wag do pamięci przy pierwszym pytaniu zajęło 6,8 sekundy, potem model trzymał się w ramie. Generowanie ruszyło w tempie od 4,8 do 5,5 tokena na sekundę przy odpowiedziach liczących od 250 do niecałych 300 tokenów, więc każda pełna odpowiedź rodziła się trochę ponad minutę. To tempo spokojnego czytania na głos: nie ma mowy o błyskawicy znanej z chmury, ale też nie ma czekania, które zabijałoby pracę przy dłuższej rozmowie.
Jakość rozjechała się w trzech kierunkach i to najciekawszy wniosek całego testu. Zadanie prozatorskie, trzy zdania o lokalnych modelach, wykonał spójnie i poprawną polszczyzną. Życzenia imieninowe dla cioci Halinki, czyli polski kontekst kulturowy, wypadły zaskakująco naturalnie, ze „Sto lat” i zdrobnieniami tam, gdzie ich trzeba; mało który zagraniczny model czuje ten rejestr. Ale na pytaniu technicznym o kwantyzację do formatu GGUF model skonfabulował z pełnym spokojem: wymyślił rozwinięcie „Generalized Gaussian Unitary Factor” i prawił wykład o stanach kwantowych, brzmiąc przy tym całkowicie autorytatywnie. Płynność języka maskuje błąd merytoryczny i to jest główna przestroga z naszego biurka: do tekstów, maili i pomysłów po polsku jak znalazł, każde twierdzenie specjalistyczne wymaga weryfikacji, zwłaszcza w skompresowanej wersji Q4.
Pełną instrukcję instalacji, którą przeszliśmy, znajdziesz w następnej sekcji, łącznie z pułapką, na którą trafiliśmy od razu i która nie jest nigdzie udokumentowana: polecenie pull bez jawnego tagu kończy się błędem.
Jak uruchomić Bielika lokalnie, krok po kroku
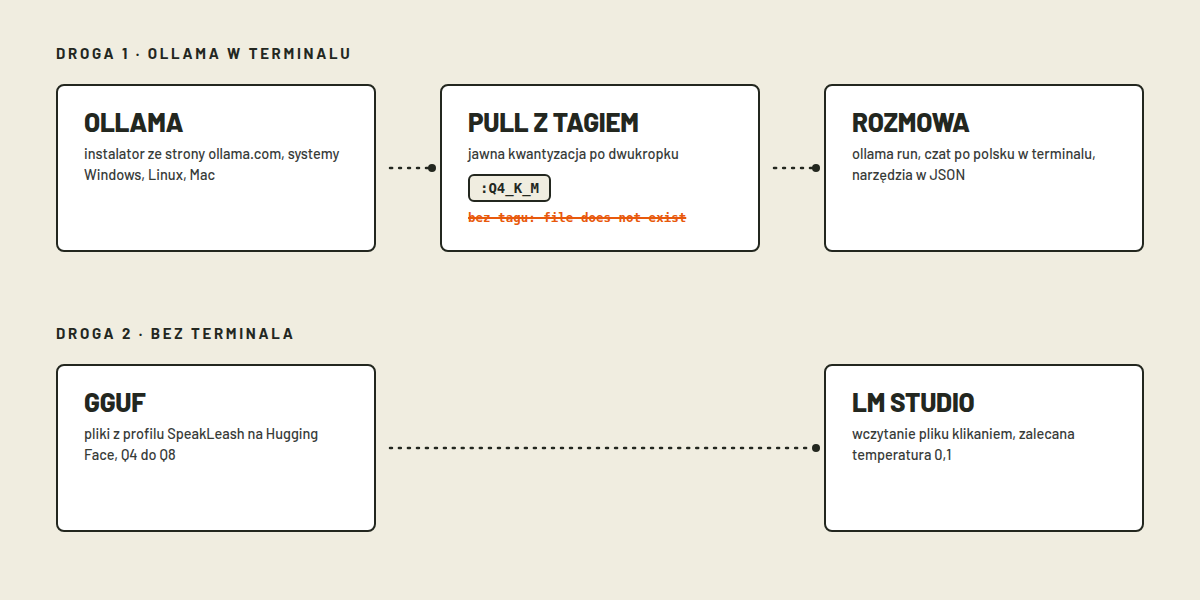
Ścieżka z Ollama jest najkrótsza i działa tak samo na Windows, Linuxie i Macu. Instalujesz Ollama ze strony ollama.com, a potem w terminalu wydajesz polecenie pobrania modelu. I tu pierwsza pułapka, znaleziona podczas naszego testu 13 października: SpeakLeash nie publikuje w rejestrze Ollama domyślnego tagu latest, więc `ollama pull speakleash/bielik-minitron-7B-v3.0-instruct` zwróci komunikat o braku pliku. Kwantyzację trzeba podać wprost, na przykład `ollama pull speakleash/bielik-11b-v3.0-instruct:Q4_K_M` dla flagowego modelu (6,7 GB) albo `ollama pull speakleash/bielik-minitron-7B-v3.0-instruct:Q4_K_M` dla kompaktowego (4,5 GB). Po pobraniu `ollama run` z tą samą nazwą otwiera rozmowę w terminalu.
Przy doborze wariantu kieruj się pamięcią, nie ambicją. Wersja 4,5B ma tagi Q8_0 (5,1 GB) i FP16 (9,5 GB) oraz kontekst skrócony do 8K tokenów, flagowy 11B w Q4_K_M zajmuje 6,7 GB i niesie kontekst 32K, a Minitron 7B ląduje pomiędzy. Na komputerze bez karty graficznej wszystkie trzy pobierają się do ramu, więc realny próg wejścia to 16 GB pamięci dla 7B i raczej 32 GB dla wygodnej pracy z 11B. Pełne wagi BF16, 22,3 GB dla 11B, mają sens tylko na serwerowych kartach graficznych, sięgaj po nie, gdy kwantyzacje przestaną wystarczać.
Alternatywa dla terminalofobów jest równie darmowa. Te same modele w formacie GGUF pobierzesz z profilu SpeakLeash na Hugging Face i wczytasz w LM Studio albo w llama.cpp, a karta GGUF Minitrona dorzuca gotowy szablon Modelfile z zaleceniem temperatury 0,1 dla niskich kwantyzacji. O tych narzędziach szeroko w naszym przewodniku po lokalnym AI na komputerze: Bielik jest tam obywatelem pierwszej klasy, bo jego pliki GGUF utrzymuje sam producent.
Bielik bez instalacji: chat i Obywatel Bielik
Jeśli lokalne uruchamianie brzmi jak przekroczenie twojego progu technicznego, startuj od czatu. Pod adresem chat.bielik.ai działa interfejs rozmowy utrzymywany przez SpeakLeash, darmowy, ale wymagający konta: bez zalogowania serwis przekierowuje na stronę logowania w domenie id.speakleash.org.pl. Na stronie projektu mowa o ponad 100 tysiącach użytkowników i 2 milionach zapytań, więc skala jest jak na polskie warunki spora.
Drugą ścieżką bez terminala jest Obywatel Bielik, wersja na smartfony zapowiadana w blogu fundacji jako gotowa do użycia. Nie instalowaliśmy jej, więc przed pobraniem sprawdź w oficjalnym sklepie, czy wydawcą jest faktycznie SpeakLeash: przy popularnych nazwach szybko wyrastają podróbki.
API i polska chmura
Zespół nie prowadzi jednego zbiorowego API z cennikiem w stylu OpenAI. Zamiast tego poradnik SpeakLeash odsyła do kilku niezależnych dostawców hostingu modelu: LLM Lab w Cyfronecie (ten sam ośrodek, który liczył trening), AI HUB w PSNC w Poznaniu, platformę Sherlock od CloudFerro, inference w ramach Hugging Face oraz ARK Labs. Do tego dochodzi wariant serverless typu RunPod dla osób, które chcą płacić za sekundy użycia. My nie korzystaliśmy z żadnego z tych API i nie mamy ich cenników, więc ich nie cytujemy: traktuj tę listę jako mapę punktów startowych do samodzielnej wyceny.
Jest w tym jedna myśl strategiczna: Bielik pozycjonuje się jako element suwerennej sztucznej inteligencji, więc instytucja, szpital czy urząd może trzymać model na własnym serwerze w Polsce, bez opłat licencyjnych i z pełną audytowalnością. Jeśli twoja firma zastanawia się, czy wysyłanie dokumentów klientów do zagranicznej chmury jest konieczne, lokalne uruchomienie Bielika jest jedną z odpowiedzi.
Co mówią liczby o jakości
Uczciwie o rozmiarze dowodów. Pozytywna strona: 6. miejsce EuroEval dla wersji bazowej Minitrona, opisane wyżej proporcje rozmiaru i szybkości, 20 milionów instrukcji w treningu i publiczny raport techniczny. Strona brakująca: karty modeli v3.0 nie zawierają tabeli wyników z polskiego zestawienia PLBench ani porównań punkt w punkt z GPT czy Gemini, a my takich benchmarków nie odtwarzaliśmy.
To, co możesz sprawdzić sam i tanio, to własne zadania. Model w wersji 7B pracuje na zwykłym laptopie, więc przez pół godziny przepuść przez niego swoje realne prompty: maila do klienta, streszczenie raportu, burzę pomysłów na nazwę. Nasz przewodnik po lokalnym AI opisuje, jak dobrać kwantyzację, żeby jakość nie ucierpiała bardziej niż to konieczne.
Bielik a inne lokalne modele
W naszej serii po lokalnej sztucznej inteligencji, zebranej na hubie lokalnego AI, Bielik wpada w konkretny kontekst. Strata i modele Qwen z wpisu o lokalnym AI na komputerze wygrywają surową mocą i świeżością wag, MicroLLM z wpisu o AI w przeglądarce błyszczy zerową instalacją, a ekstremum serii to eksperyment z modelem BitNet na mikrokontrolerze ESP32. Bielik ma własny, trudny do podrobienia atut: polski trening i polską tożsamość projektu. Wybór między nimi to dopasowanie, nie wyższość: najmocniejszy polski tekst i obsługa narzędzi to Bielik, najnowsze otwarte modele światowe to Qwen przez Strata, a nauka bez instalowania czegokolwiek to przeglądarka.
Co gdy nie działa
Trzy problemy pojawiają się najczęściej i wszystkie przeżyliśmy sami. Pierwszy: polecenie pull kończy się błędem o braku pliku mimo poprawnej nazwy modelu. Przyczyna to brak tagu latest w rejestrze SpeakLeash; lekarstwem jest jawne dopisanie kwantyzacji po dwukropku, a listę dostępnych tagów znajdziesz na stronie modelu w serwisie Ollama, w zakładce tags. Drugi: serwer Ollama nie odpowiada w ogóle, zwykle dlatego, że port 11434 zajęła inna usługa; zamknij poprzednią albo zmień port w zmiennych środowiskowych. Trzeci: model odpowiada po polsku, ale gubi fakty albo miesza styl. To opisane w dokumentacji ryzyko niskich kwantyzacji, którego sami doświadczyliśmy w teście z sekcji wyżej; karta GGUF zaleca przy okazji obniżenie temperatury do 0,1, a jeśli to nie pomaga, przeskocz o jeden poziom wyżej, z Q4_K_M na Q5_K_M, kosztem niecałego gigabajta.
Osobny przypadek to pełne wagi z Hugging Face: repozytoria safetensors są bramkowane, więc pliki zobaczysz dopiero po zalogowaniu i zaakceptowaniu licencji. Nic nie płacisz, ale kliknąć musisz. Wagi GGUF, te do Ollama i LM Studio, są dostępne bez tej formalności.
Ściąga: Bielik w pięciu krokach
| Cel | Ścieżka |
|---|---|
| Szybki start bez instalacji | chat.bielik.ai, darmowe konto SpeakLeash |
| Model na własnym komputerze | Ollama, pull z tagiem Q4_K_M, run |
| Wariant dla 16 GB ramu | bielik-minitron-7B-v3.0-instruct:Q4_K_M (4,5 GB) |
| Pełna moc, kontekst 32K | bielik-11b-v3.0-instruct:Q4_K_M (6,7 GB) |
| Klikane narzędzie zamiast terminala | GGUF z Hugging Face w LM Studio |
Po ostatniej aktualizacji sprawdzaj dwie rzeczy: numer wersji modelu w rejestrze i kontekst w jego zakładce tags, bo parametry wariantów potrafią się różnić w obrębie jednej rodziny, jak pokazuje skrócony do 8K kontekst wersji 4.5B.
Najczęstsze pytania
Bielik AI: co to jest?
Polski otwarty model językowy od Fundacji SpeakLeash i społeczności, trenowany z naciskiem na polszczyznę, na licencji Apache 2.0. Aktualna generacja to v3.0: flagowy 11B i skompresowany Minitron 7B. Możesz z niego korzystać przez darmowy chat w przeglądarce albo pobrać wagi i uruchomić model na własnym sprzęcie.
Bielik AI download: skąd pobrać?
Najprościej przez Ollama z jawnym tagiem kwantyzacji, bo brak tagu latest powoduje błąd pobierania. Alternatywa: pliki GGUF z profilu SpeakLeash na Hugging Face do LM Studio i llama.cpp albo pełne wagi po zalogowaniu i zaakceptowaniu licencji. Wszystkie ścieżki są darmowe.
Czy Bielik AI jest darmowy?
Tak, na dwóch poziomach. Licencja Apache 2.0 pozwala pobierać, używać i zarabiać na modelu bez opłat, a chat na chat.bielik.ai jest darmowy po założeniu konta. Płatne bywają dopiero usługi hostingu API u zewnętrznych dostawców, gdzie płacisz za ich infrastrukturę, nie za sam model.
Bielik AI a Ollama: jak to połączyć?
Instalujesz Ollama, pobierasz model z tagiem kwantyzacji dopasowanym do pamięci, na przykład speakleash/bielik-minitron-7B-v3.0-instruct:Q4_K_M, i otwierasz rozmowę poleceniem run z tą samą nazwą. Obsługa narzędzi działa z automatu dzięki szablonowi ChatML utrzymywanemu przez SpeakLeash w rejestrze.
Bielik AI opinie: co realnie wiadomo?
Zmierzone i opisane przez twórców: 6. miejsce EuroEval dla bazy Minitrona wśród modeli niezależnych od wielkich koncernów, jedną trzecią mniejszy rozmiar przy połowie kosztu obliczeniowego i około 90% jakości pełnego modelu. Nasz test na procesorze potwierdza użyteczność konwersacyjną w tempie odpowiednim do czytania i ostrzega przed konfabulacją na pytaniach specjalistycznych. Porównań punkt w punkt z zagranicznymi liderami brak, więc wszelkie „x razy lepszy” bierz jako opinię autora, nie pomiar.
Nota uczciwości
Ścieżki instalacji, liczby parametrów, rozmiary plików i deklaracje twórców pochodzą ze strony bielik.ai, kart modeli na Hugging Face i rejestru Ollama, pobranych 13 października 2026. Wyniki szybkości z sekcji o teście to nasze własne pomiary na jednym komputerze bez karty graficznej, więc traktuj je jako punkt odniesienia, nie benchmark. Nie zakładaliśmy konta w chacie SpeakLeash, nie testowaliśmy aplikacji mobilnej ani API zewnętrznych dostawców i nie odtwarzaliśmy wyników EuroEval. Ilustracje są stylizowanymi mapami ścieżek, nie zrzutami ekranu.
Źródła
- Bielik.ai, strona projektu, liczby pobrań i społeczności, licencja (pobrane 13.10.2026): https://bielik.ai
- Bielik.ai, „Premiera Bielik Minitron 7B na Konferencji NVIDIA GTC w San Jose”, 17.03.2026 (pobrane 13.10.2026): https://bielik.ai/premiera-minitron-nvidia-gt/
- Bielik.ai, „Jak korzystać z Bielika?”, ścieżki chat, API i chmury (pobrane 13.10.2026): https://bielik.ai/jak-korzystac-z-bielika/
- Hugging Face, karta speakleash/Bielik-Minitron-7B-v3.0-Instruct, metoda treningu i liczby (pobrane 13.10.2026): https://huggingface.co/speakleash/Bielik-Minitron-7B-v3.0-Instruct
- Hugging Face, karta speakleash/Bielik-Minitron-7B-v3.0-Instruct-GGUF, kwantyzacje i rozmiary (pobrane 13.10.2026): https://huggingface.co/speakleash/Bielik-Minitron-7B-v3.0-Instruct-GGUF
- Hugging Face, karta speakleash/Bielik-11B-v3.0-Instruct, dane treningowe (pobrane 13.10.2026): https://huggingface.co/speakleash/Bielik-11B-v3.0-Instruct
- Ollama, rejestr modeli SpeakLeash, tagi i rozmiary (pobrane 13.10.2026): https://ollama.com/speakleash/bielik-11b-v3.0-instruct