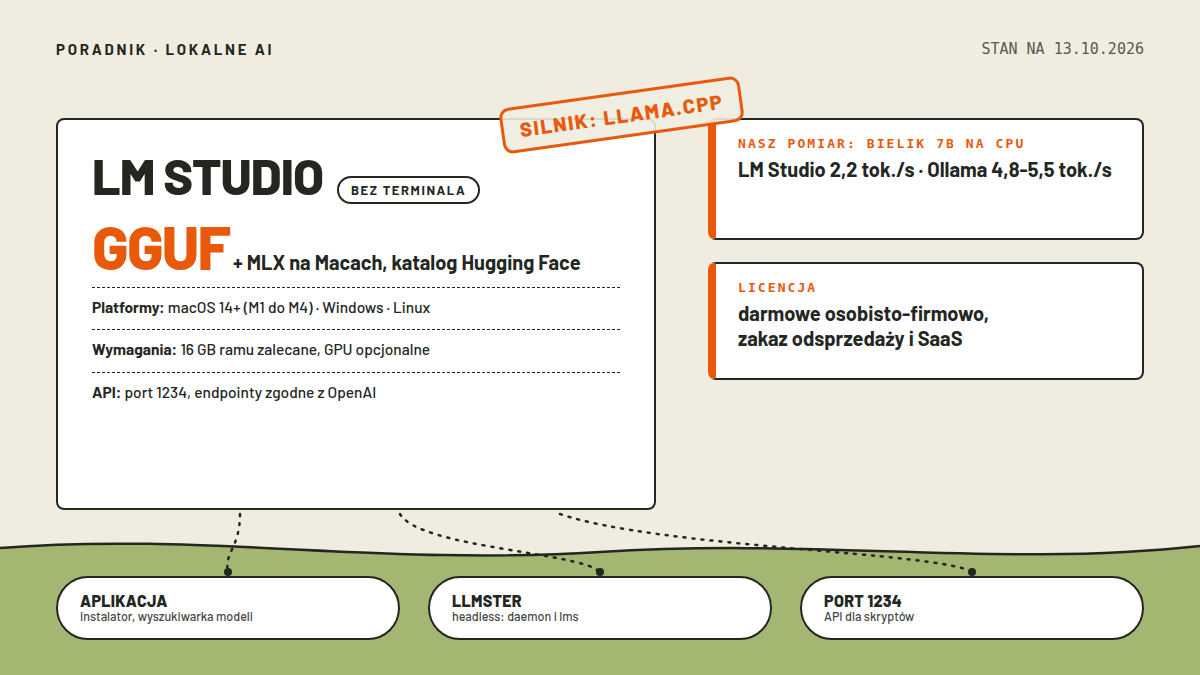
Pytanie „lm studio vs ollama” puka do wyszukiwarki tak często, że wchodzi w podpowiedzi po wpisaniu samej nazwy, i nie bez powodu. Oba narzędzia robią to samo z pozycji: ściągają otwarte modele na twój komputer i pozwalają z nimi rozmawiać. Różnica jest w drzwiach. Ollama otwiera je przez terminal, LM Studio przez okno z przyciskami, wyszukiwarkę modeli i suwaki. Jeśli instalowałeś kiedyś program, obsłużysz to bez czytania dokumentacji, a pod maską i tak siedzi ten sam silnik llama.cpp, więc nie płacisz wygodą za jakość. Ta strona prowadzi przez instalację, pobranie pierwszego modelu, nasz własny pomiar prędkości na polskim modelu Bielik i uczciwe porównanie z Ollamą, wszystkie fakty zweryfikowane 13 października 2026.
Jedna rzecz na start, bo wielu czytelników myli jedno z drugim: LM Studio to nie model, tylko program do uruchamiania modeli. Sam w sobie nie myśli; myśli model, który pobierzesz, na przykład Bielik, Qwen albo Llama w formacie GGUF. Dokumentacja dodaje, że na komputerach Mac z chipem M1 do M4 obsługuje też drugi silnik, MLX, zoptymalizowany pod Apple.
- Najważniejsze informacje
- Czym jest LM Studio i dla kogo
- Wymagania: co musi mieć twój komputer
- Nasz test: Bielik w wersji headless z pomiarem
- Instalacja i pierwszy model, krok po kroku
- LM Studio vs Ollama: co wybrać
- Bionic: młodszy brat do zadań agentsowych
- Licencja i pieniądze
- Co gdy nie działa
- Ściąga: LM Studio w pięciu krokach
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Czym jest | aplikacja do lokalnych modeli AI bez terminala |
| Platformy | macOS 14+ (tylko Apple Silicon), Windows x64/ARM, Linux AppImage |
| Wymagania | 16 GB ramu zalecane, GPU opcjonalne; Windows x64 wymaga AVX2 |
| Formaty modeli | GGUF (wszędzie), MLX (tylko Mac) |
| Skąd modele | katalog Hugging Face w aplikacji albo własny plik |
| Nasz test | llmster headless + Bielik 7B: 2,2 tok./s na CPU |
| Porównanie | Ollama na tym samym sprzęcie: 4,8 do 5,5 tok./s |
| Serwer lokalny | port 1234, API zgodne z OpenAI |
| Licencja | darmowe do użytku osobistego i wewnętrznego firmowego |
Czym jest LM Studio i dla kogo
Dokumentacja opisuje produkt krótko: pobieraj i uruchamiaj lokalne modele, czatuj w prostym interfejsie, serwuj modele na endpointach zgodnych z OpenAI, zarządzaj plikami i konfiguracjami. W praktyce to odpowiedź na jeden konkretny problem: chcesz lokalną sztuczną inteligencję, ale terminal przyprawia cię o dreszcze albo po prostu wolisz widzieć suwak kontekstu zamiast flagi wiersza poleceń. Aplikacja działa w całości offline, o ile wcześniej zdążysz pobrać pliki modeli, i pozwala podpiąć dokumenty do rozmowy, czyli to, co dokumentacja nazywa RAG.
Dla kogo to nie jest? Dla osoby, która chce „sztuczną inteligencję do wszystkiego” jednym kliknięciem: nadal musisz wiedzieć, że model 7B zmieści ci się w 16 GB ramu, a 70B już nie, i że kwantyzacja Q4 jest kompromisem między jakością a rozmiarem. Te decyzje LM Studio ułatwia (pokazuje, co się zmieści), ale nie podejmie ich za ciebie. Nasz przewodnik po lokalnym AI na komputerze rozkłada tę wiedzę na czynniki, całą serię zbieramy na hubie lokalnego AI, a jeśli wolisz poznać temat bez instalowania czegokolwiek, zajrzyj do wpisu o AI w przeglądarce.
Warto też wiedzieć, że rodzina rośnie. Obok klasycznej aplikacji istnieje Bionic, opisywany przez twórców jako agent do pracy z otwartymi modelami: kodowanie, dokumenty, projekty i sesje. To osobny program, a LM Studio pozostaje narzędziem do niższej warstwy, do precyzyjnej konfiguracji modeli.
Wymagania: co musi mieć twój komputer
Rozgraniczenie jest ostre i lepiej znać je przed pobieraniem instalatora. Na macOS aplikacja działa wyłącznie na Apple Silicon, czyli M1 do M4; starsze Maci z procesorami Intela są niewspierane, podobnie jak systemy starsze niż macOS 14. Na Windows obsłużone są komputery x64 z obsługą instrukcji AVX2 oraz nowsze maszyny ARM z Snapdragonem, z zaleceniem 16 GB ramu i, opcjonalnie, karty z co najmniej 4 GB własnej pamięci. Linux dostaje paczkę AppImage dla x64 i ARM64, z wymogiem Ubuntu 20.04 lub nowszego, przy czym sami twórcy zaznaczają, że dystrybucje powyżej 22.04 są słabiej przetestowane.
Karta graficzna jest wszędzie opcją, nie warunkiem. Na Macu silnik i tak korzysta z pamięci zunifikowanej, na PC model po prostu policzy się na procesorze, tylko wolniej. Nasz test z dolnych sekcji biegł dokładnie tak: sam procesor, żadnej karty, i odpowiedzi przychodziły w tempie spokojnego czytania.
Nasz test: Bielik w wersji headless z pomiarem
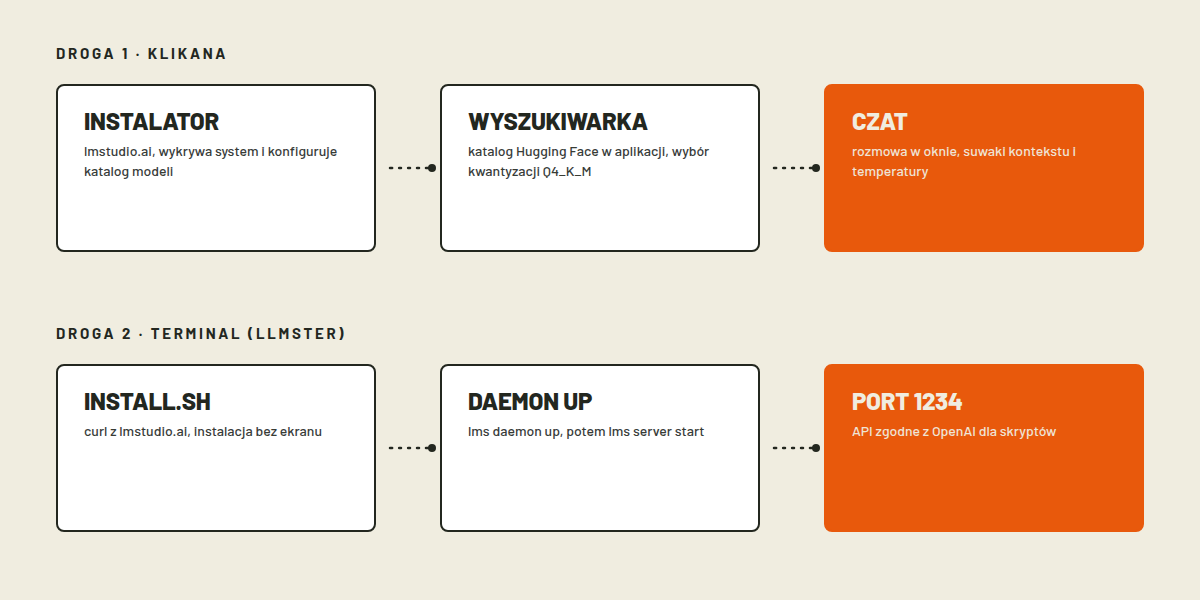
Nie każdy wie, że LM Studio ma drugą twarz. Obok aplikacji z oknem istnieje llmster, jej wersja bez interfejsu graficznego, instalowana jednym poleceniem z oficjalnej strony i polecana do serwerów oraz automatyzacji. Właśnie ją przetestowaliśmy, bo nasze środowisko nie ma ekranu, a silnik wnioskowania jest ten sam co w aplikacji. Instalacja: `curl -fsSL https://lmstudio.ai/install.sh | bash`, potem `lms daemon up` i `lms server start`, po czym na porcie 1234 wstaje serwer mówiący dialektem OpenAI.
Modelem testowym został Bielik Minitron 7B w kwantyzacji Q4_K_M, ten sam plik, który dzień wcześniej przeszedł przez nasz test Ollamy, więc porównanie jest uczciwe jedna do jednej. Plik GGUF zaimportowaliśmy do katalogu LM Studio poleceniem `lms import` i załadowaliśmy z jawną długością kontekstu 4096. Załadowanie 4,19 GB wag zajęło 4,96 sekundy, czyli szybciej niż w Ollamie, gdzie załadowanie trwało 6,8 sekundy.
Samo generowanie już nie błyszczy. Odpowiedź na polskie pytanie o zalety lokalnych modeli liczyła 348 tokenów i rodziła się 159 sekund, co daje 2,2 tokena na sekundę. Ta sama proza w Ollamie na tym samym komputerze i tym samym pliku modelu szła 4,8 do 5,5 tokena na sekundę, ponad dwukrotnie szybciej. Dla czystości dopowiadamy, że zmierzyliśmy też gołego llama.cpp, czyli silnik, po którym LM Studio dziedziczy: 2,2 do 2,9 tokena na sekundę w domyślnej konfiguracji. Wniosek praktyczny jest nieoczywisty i wart zapamiętania: między narzędziami na tym samym sprzęcie bywa dwukrotna różnica tempa, a LM Studio domyślnie nie stroi parametrów tak agresywnie jak Ollama. Jeśli liczysz się z każdą sekundą, otwórz ustawienia zaawansowane i zwiększ liczbę wątków, zanim uznasz, że twój komputer jest za słaby.
Instalacja i pierwszy model, krok po kroku
Droga klikana zaczyna się na lmstudio.ai, skąd pobierasz instalator dla swojego systemu. Po pierwszym uruchomieniu aplikacja zaproponuje konfigurację: katalog na modele i ewentualne pobranie silników pod swój sprzęt. Serce interfejsu to wyszukiwarka w prawym górnym rogu: wpisujesz nazwę modelu, na przykład bielik albo qwen, i dostajesz listę pozycji z Hugging Face wraz z rozmiarami plików dla różnych kwantyzacji. Wybierasz Q4_K_M jako rozsądny kompromis, klikasz pobierz, a po zakończeniu model pojawia się na górnym pasku gotowy do rozmowy.
Droga terminalowa, czyli llmster, ma trzy kroki opisane wyżej: instalator, daemon, serwer. Modele pobierasz poleceniem `lms get` z nazwą, a jeśli plik GGUF masz już na dysku, na przykład z poprzednich eksperymentów z Ollamą, polecenie `lms import` podpinie go bez pobierania drugi raz; flaga `–hard-link` robi to bez kopiowania gigabajtów. Wszystko steruje się potem z jednego polecenia `lms`, od `lms load` po `lms ps` pokazujące, co siedzi w pamięci.
Trzecia droga jest dla programistów: odpal serwer, a potem w dowolnym skrypcie zmień adres API z adresu OpenAI na lokalny port 1234. Dokumentacja obiecuje tryb JIT, w którym samo zapytanie ładuje potrzebny model bez ręcznego `lms load`, a nieużywane modele wyładowują się po czasie bezczynności.
LM Studio vs Ollama: co wybrać
Skoro oba narzędzia stoją na llama.cpp, wybór sprowadza się do tego, jak wolisz pracować, z jednym istotnym wyjątkiem, który właśnie zmierzyliśmy. LM Studio wygrywa interfejsem: wyszukiwarka modeli, podgląd parametrów, czat z historią, suwaki kontekstu i temperatury, wszystko widoczne. Ollama wygrywa prostotą instalacji w środowiskach bez ekranu i, w naszym pomiarze, domyślnym tempem generowania na CPU, ponad dwukrotnie wyższym bez ruszania żadnej opcji. Na komputerach z kartą graficzną różnica między narzędziami ma prawo zniknąć, bo wtedy oba korzystają z tego samego układu i pamięci wideo; nie mamy jak tego zmierzyć, więc trzymamy się tego, co policzyliśmy.
Praktyczny kompromis wygląda tak: zacznij od LM Studio, żeby zrozumieć, co się dzieje, przeskakuj modele i kwantyzacje bez strachu. Gdy zbudujesz sobie nawyk albo zechcesz oskryptować codzienne zadania, dorzuć Ollamę albo przejdź na llmster i steruj tym samym katalogiem modeli. W odwrotną stronę też działa: pliki GGUF są wspólne, a `lms import` nie pyta o pochodzenie.
Bionic: młodszy brat do zadań agentsowych
Na osobną wzmiankę zasługuje Bionic, nowa, odrębna aplikacja od twórców LM Studio, pozycjonowana jako agent do prawdziwej pracy z otwartymi modelami. Dokumentacja wymienia projekty z osobnymi sesjami dla zadań, kodowanie i pracę z dokumentami, sterowanie głosowe z lokalną transkrypcją oraz trzy drogi uruchamiania modeli: lokalnie, w chmurze producenta z deklarowaną zasadą zero retencji danych albo zdalnie przez LM Link. Jawnie wspierane modele to na przykład GLM 5.2, Kimi K3 i DeepSeek V4 Pro. Nie testowaliśmy Bionica, więc traktuj ten akapit jako mapę, nie recenzję; jeśli agent pracy cię interesuje, wróć do nas po aktualizacji.
Licencja i pieniądze
Sama aplikacja jest darmowa, a warunki użytkowania przyznają licencję do celów osobistych oraz wewnętrznego użytku firmowego, więc legalnie wdrożysz ją w firmie jako wewnętrzne narzędzie. Granica biegnie gdzie indziej: nie wolno odsprzedawać programu ani świadczyć nim usług na zewnątrz w modelu service bureau czy software-as-a-service. Dokument opisuje też funkcje płatne, rozliczane subskrypcyjnie albo kredytami użycia; to rozliczenia za usługi chmurowe, nie za samo uruchamianie modeli lokalnie, które pozostaje bezpłatne.
Co gdy nie działa
Z naszych przejść przez llmster płyną trzy konkretne rady. Pierwsza: polecenie `lms load` bez pełnej nazwy modelu wchodzi w interaktywną listę wyboru, która w niektórych terminalach potrafi zablokować skrypt; podawaj pełny identyfikator z `lms ls` i flagę `-y`. Druga: `lms import` domyślnie kopiuje plik modelu, co przy GGUF-ach ważących kilka gigabajtów trwa i podwaja zajętość dysku; flaga `–hard-link` podpina plik bez kopii. Trzecia: jeśli lokalny serwer nie odpowiada na porcie 1234, sprawdź najpierw `lms status`, bo daemon i serwer to dwie osobne usługi i daemon potrafi działać przy wyłączonym serwerze.
Na klasycznym froncie najczęstszy winowajca to pamięć. Model 7B w Q4 potrzebuje około 5 GB wolnego ramu, więc na maszynie z 8 GB zamknij przeglądarkę przed załadowaniem albo zejdź do mniejszego wariantu modelu. Na Windows upewnij się, że procesor ma AVX2, bo bez niego obecne buildy nie ruszą; na Macu liczy się Apple Silicon, Intel odpada niezależnie od wersji systemu.
Ściąga: LM Studio w pięciu krokach
| Cel | Ścieżka |
|---|---|
| Klikana aplikacja | instalator z lmstudio.ai, wyszukiwarka modeli w oknie |
| Wersja bez ekranu | install.sh, lms daemon up, lms server start |
| Model z Hugging Face | wyszukiwarka w aplikacji albo lms get |
| Własny plik GGUF | lms import, z –hard-link bez kopiowania |
| API dla skryptów | port 1234, endpointy zgodne z OpenAI |
Jedna uwaga na pożegnanie: numeracja silników i lista wspieranych modeli zmieniają się często, więc jeśli instalator chce pobrać nowy runtime, zgodź się, to normalna droga aktualizacji, a nie podejrzana prośba.
Najczęstsze pytania
LM Studio: co to jest?
Program do uruchamiania lokalnych modeli językowych bez terminala. Nie jest sam w sobie modelem: pobierasz nim modele w formacie GGUF (na Macach dodatkowo MLX) z katalogu Hugging Face i rozmawiasz z nimi w wbudowanym czacie albo przez lokalne API zgodne z OpenAI. Działa na macOS z Apple Silicon, Windows i Linuksie.
LM Studio download: skąd pobrać?
Wyłącznie z oficjalnej strony lmstudio.ai, gdzie instalator wykrywa system; wersja bez interfejsu, llmster, instaluje się poleceniem curl z tej samej domeny. Pobieranie z mirrorów traktuj jak podejrzane, bo przy plikach wykonywalnych to proszenie się o kłopoty.
LM Studio vs Ollama: które lepsze?
Do poznawania tematu i pracy z suwakami LM Studio, do skryptów i serwerów Ollama albo llmster. W naszym pomiarze na tym samym modelu i procesorze Ollama generowała ponad dwukrotnie szybciej w ustawieniach domyślnych, 4,8 do 5,5 tok./s wobec 2,2 tok./s; oba stoją na tym samym silniku llama.cpp, więc to kwestia strojenia, nie jakości odpowiedzi.
LM Studio na Windows: jakie wymagania?
System 64-bitowy z instrukcjami AVX2, najlepiej 16 GB ramu, karta graficzna opcjonalna (zalecana z co najmniej 4 GB VRAM). Obsługiwane są też komputery ARM z Snapdragonem X Elite. Mniejsze modele, do 4B parametrów, działają i na skromniejszych maszynach.
Czy LM Studio jest darmowe?
Tak, do użytku osobistego i wewnętrznego w firmie, zgodnie z warunkami na lmstudio.ai. Płatne bywają funkcje chmurowe rozliczane subskrypcją albo kredytami; uruchamianie modeli lokalnie nic nie kosztuje. Zakazane jest odsprzedawanie programu i świadczenie nim usług SaaS na zewnątrz.
Nota uczciwości
Fakty o platformach, wymaganiach, licencji, Bionicu i trybie headless pochodzą z oficjalnej strony i dokumentacji LM Studio pobranych 13 października 2026. Nasz test objął wersję headless llmster 0.0.25-1 z modelem Bielik Minitron 7B v3.0 Q4_K_M na procesorze bez karty graficznej, w kontekście 4096; aplikacji z interfejsem graficznym w środowisku bez ekranu nie uruchamialiśmy, więc wrażeń z okienek nie opisujemy. Pomiary to pojedyncze przebiegi na jednym komputerze, punkt odniesienia, nie benchmark. Bionica nie testowaliśmy. Ilustracje są stylizowanymi mapami ścieżek, nie zrzutami ekranu.
Źródła
- LM Studio, strona główna i opis aplikacji (pobrane 13.10.2026): https://lmstudio.ai
- LM Studio, dokumentacja aplikacji: platformy, funkcje, llmster (pobrane 13.10.2026): https://lmstudio.ai/docs/app
- LM Studio, wymagania systemowe per platforma (pobrane 13.10.2026): https://lmstudio.ai/docs/app/system-requirements
- LM Studio, warunki użytkowania i licencja (pobrane 13.10.2026): https://lmstudio.ai/terms
- LM Studio, dokumentacja Bionic (pobrane 13.10.2026): https://lmstudio.ai/docs/bionic
- LM Studio, tryb headless i instalacja llmster (pobrane 13.10.2026): https://lmstudio.ai/docs/developer/core/headless