Kiedy czat przeprosi za pomyłkę, a po twoim kontrargumencie przyzna ci rację i przeformułuje odpowiedź, mózg robi coś automatycznego: zakłada, że po drugiej stronie jest ktoś, kto myśli. U ludzi to działa niezawodnie, bo każdy, kto odpowiada nam zdaniami, ma podobny mózg i podobne doświadczenia. Tu ten wzorzec się sypie, bo po drugiej stronie jest program, który ułożył zdania z miliardów parametrów wyuczonych na tekstach. Odruch mówi „myśli”, wiedza o mechanice mówi „przewiduje kolejne fragmenty”, i obie te odpowiedzi brzmią przekonująco. Jeśli chcesz ogarniać takie tematy bez żargonu, to tekst wpisuje się w cykl Podstawy AI, gdzie po kolei rozkładamy na części podobne pytania.
Zamiast werdyktu dostaniesz tu porządek. Najpierw dlaczego samo pytanie „czy AI myśli” jest trudniejsze, niż wygląda, i co z tym tematem zrobił już Turing w 1950 roku. Potem mechanika: co fizycznie robi model, kiedy pisze odpowiedź, czy AI myśli samodzielnie w jakimkolwiek sensie tego słowa i dlaczego twórcy modeli rozumujących mówią przecież o „myśleniu”. Dalej najlepsze argumenty strony „nie” na pytanie, czy AI myśli jak człowiek: halucynacje, upadki na liczbach poza znanym rozkładem i analogia rozmazanego JPEG-a, którą zaproponował Ted Chiang. Potem argumenty strony „wstrzymaj się”, pozycje OpenAI i Anthropic, teza LeCuna o modelach świata i na końcu kilka prostych prób, które możesz zrobić samemu. Nie rozstrzygną sporu filozoficznego, ale pokażą granice konkretnego modelu.
- Dlaczego pytanie „czy AI myśli” jest takie trudne
- Czy AI myśli samodzielnie? Co pokazuje mechanika
- Czy AI myśli jak człowiek? Argumenty, żeby powiedzieć, że nie
- Argumenty, żeby się wstrzymać z odpowiedzią
- LeCun i modele świata: spór toczy się w środku pola, nie na jego marginesie
- Jak sprawdzić to samemu (i czego te próby nie rozstrzygną)
- FAQ
Dlaczego pytanie „czy AI myśli” jest takie trudne
Nikt nie ma definicji myślenia, na którą zgodziliby się filozofowie, psychologowie i ludzie budujący modele. Rozpoznajemy myślenie u siebie i u innych ludzi, ale ta pewność opiera się na wspólnym wyposażeniu biologicznym, którego program nie ma. Od tej dziury w definicji zależy cała odpowiedź. Jeśli myślenie to przetwarzanie informacji w celu rozwiązania problemu, to kalkulator też myśli, tylko wąsko, a wtedy pytanie przestaje ciekawić. Jeśli myślenie to rozumienie znaczenia, to najpierw trzeba wyjaśnić, czym jest rozumienie, i tu zaczyna się prawdziwy spór.
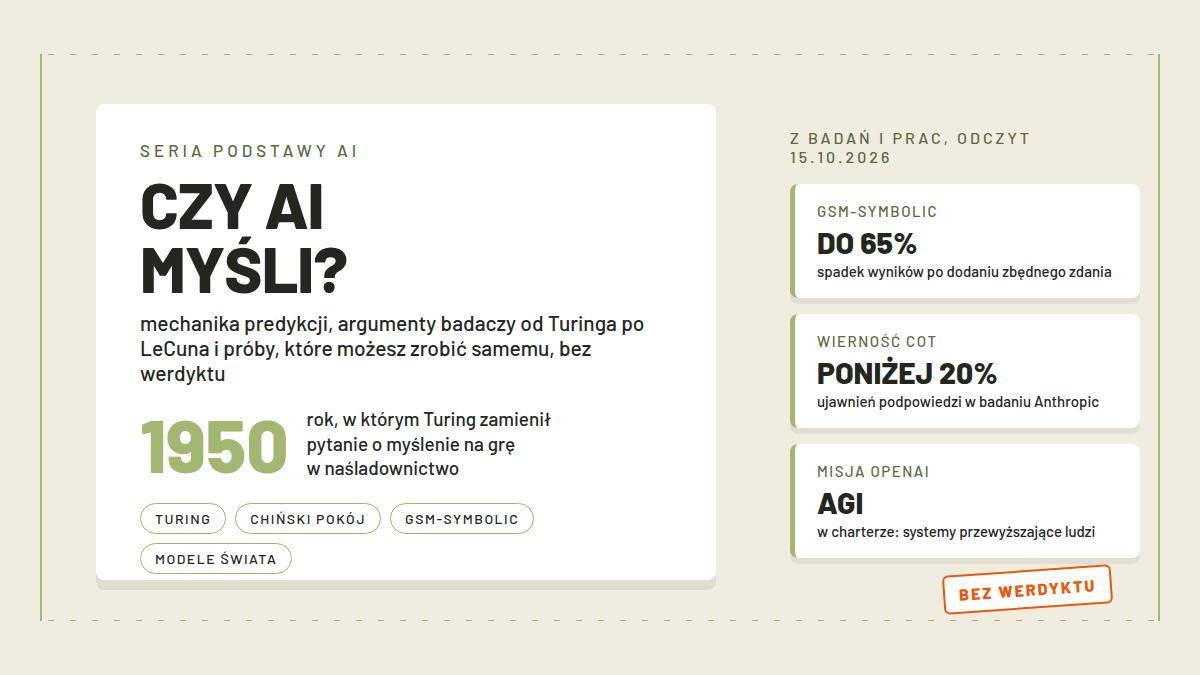
Alan Turing widział tę pułapkę i obrał inną drogę. W tekście Computing Machinery and Intelligence z 1950 roku otwiera pytaniem, czy maszyny mogą myśleć, po czym sam je wycofuje: skoro „myślenie” jest zbyt mętne, żeby nim operować, zastępuje pytanie innym, ściślejszym. Proponuje grę w naśladownictwo: sędzia pisze pytania do dwóch ukrytych uczestników, jednego człowieka i jednej maszyny, i jeśli nie potrafi ich odróżnić, to dalsze dociekanie nic nie wnosi. Warto dodać, że Turing nie twierdził, że ten test mierzy świadomość albo rozumienie, takie ambicje dopisali mu później inni. Krytycy i tak mieli żal. Najlepszy zarzut przytoczyli Stuart Russell i Peter Norvig: test mierzy ludzkość zachowania, a nie inteligencję, bo, jak piszą, podręczniki aeronautyki nie definiują swojego celu jako budowania maszyn, które latają tak bardzo jak gołębie, żeby oszukać inne gołębie.
Najostrzejszy atak na pomysł, że wystarczy porównać zachowanie, przyszedł w 1980 roku od filozofa Johna Searle’a i nosi nazwę chińskiego pokoju. Wyobraź sobie Searle’a zamkniętego w pokoju, który dostaje pod drzwiami kartki ze znakami chińskimi. Ma książkę z regułami po angielsku: taki znak, to dopisz tamten, i odsyła kartki na zewnątrz. Z zewnątrz pokój prowadzi dialog po chińsku tak dobrze, że Chińczyk sądzi, iż rozmawia z kimś, kto zna ten język. W środku siedzi jednak ktoś, kto nie rozumie ani słowa, tylko przepisuje znaki według reguł. Wniosek Searle’a: program może wykonywać dialog bez żadnego rozumienia, więc zachowanie nie dowodzi myślenia. Odpowiedź zwolenników drugiej strony, tzw. argument systemu, brzmi: rozumieć może nie człowiek, ale cały system, czyli człowiek plus reguły plus kartki, tak jak pojedynczy neuron nie rozumie, a mózg tak. Searle ripostuje, że ta odpowiedź zakłada z góry to, co ma udowodnić. Spór trwa od czterdziestu lat bez rozstrzygnięcia, i dobrze o tym pamiętać przy każdym „ale przecież gada jak człowiek”.
Czy AI myśli samodzielnie? Co pokazuje mechanika
Odłóżmy filozofię i zobaczmy, co fizycznie dzieje się w programie. Model językowy, o którym szerzej piszę w tekście co to jest LLM, to sieć neuronowa wytrenowana na jednym zadaniu: patrz na początek tekstu i zgaduj, jaki token, czyli kawałek słowa, będzie następny. Trening to biliony takich zgadywań na korpusach z internetu, książek i kodu, po każdym błędzie podkręca się miliardy wag tak, żeby następnym razem trafić lepiej. Kiedy potem czat odpowiada na pytanie o remont łazienki, nie ma w tym ani planu, ani celu, ani intencji w sensie, w jakim mam je ja pisząc ten akapit. Jest dokańczanie tekstu, token po tokenie, a losowość odpowiedzi, którą reguluje temperatura modelu, tylko dobija ten obraz. Szczegóły tej maszyny opisuje osobno tekst o tym, jak działa ChatGPT. Z tej perspektywy odpowiedź na pytanie o samodzielne myślenie brzmi: w mechanice nie ma nic, co przypominałoby samodzielną inicjatywę. Model odpowiada, bo został wywołany, a jego „myśli” pojawiają się dokładnie w tempie, w jakim generuje kolejne tokeny.
Twórcy modeli rozumowania piszą przecież o myśleniu
Jest tu jedna komplikacja, i to z obozu twórców. OpenAI w poście Learning to reason with LLMs prezentującym model o1 pisze wprost, że trening ze wzmocnieniem uczy model produktywnie używać łańcucha myśli, i porównuje go do człowieka, który długo myśli nad trudnym zadaniem zanim odpowie. Model ma uczyć się naprawiać własne błędy, rozbijać trudne kroki na prostsze i próbować innej drogi, gdy obecna nie działa. To nie jest język marketingowy z bocznej strony firmy, tylko opis z publikacji technicznej. A równolegle badacze z Anthropic pokazali w pracy z 2025 roku, że łańcuch myśli bywa nie wierny: kiedy w treści pytania podsunęli modelom wskazówkę, modele rzadko przyznawały się na piśmie, że ją wykorzystały, a w większości testowanych ustawień odsetek ujawnień spadał poniżej 20 procent. Czyli model opisuje swoje rozumowanie w sposób, który nie zawsze odpowiada temu, co faktycznie policzył. Łańcuch myśli nie jest więc dowodem ani myślenia, ani jego braku, jest tekstem, który model pisze o sobie, a taki tekst można pisać lepiej i gorzej.
Czy AI myśli jak człowiek? Argumenty, żeby powiedzieć, że nie
Pierwszy argument to halucynacje AI, czyli zmyślone fakty podane pewnym tonem. Człowiek, który nie zna odpowiedzi, zwykle daje to po sobie poznać: jąka się, przypuszcza, mówi „nie wiem”. Model potrafi równie pewnie wygenerować nieistniejącą książkę, wyrok sądu albo referencję do pracy naukowej. Ted Chiang zaproponował w „The New Yorker” analogię, która z tego zjawiska robi spójną całość: ChatGPT to rozmazany JPEG internetu. Kompresja stratna zostawia większość informacji, ale tam, gdzie ściska najbardziej, pojawiają się artefakty, i halucynacja jest właśnie takim artefaktem: brzmi poprawnie, bo gramatyka została zachowana, a fakt już niekoniecznie. Jeśli algorytm odtwarza tekst po wyrzuceniu 99 procent oryginału, część wygenerowanych zdań będzie po prostu zmyślona, i to jest oczekiwane zachowanie systemu, nie usterka.
Drugi argument jest liczbowy i pochodzi z pomiarów, nie z intuicji. Zespół badaczy opublikował w 2024 roku benchmark GSM-Symbolic, wersję zadań szkolnych z matematyki, w której można podmieniać liczby i dodawać zdania w tekście pytania. Wyniki dały do myślenia. Kiedy w tym samym zadaniu zmieniano tylko wartości liczbowe, wyniki wszystkich testowanych modeli spadały. Wystarczyło dodać jedno zdanie, które wyglądało na istotne, a nie miało wpływu na rachunek, żeby najlepsze modele traciły nawet 65 procent skuteczności. Autorzy sformułowali hipotezę wprost: dzisiejsze modele nie wykonują prawdziwego rozumowania logicznego, tylko powielają kroki rozumowania, które widziały w danych treningowych. To jest ta różnica między liczeniem a myśleniem, o którą pyta każdy, kto widział człowieka z tabliczką mnożenia: ty ją masz w głowie, więc podmiana liczby w zadaniu ci nie przeszkadza, a model, który wzorzec kojarzy, ale nie liczy, na podmianie wykoleja.
Argumenty, żeby się wstrzymać z odpowiedzią
To wszystko brzmi rozstrzygająco dopóty, dopóki nie zapytam: i co z tego wynika? Jeśli myślenie definiuję po zachowaniu, a więc „myśli, kto rozwiązuje nowe problemy, tłumaczy, planuje”, to dzisiejsze modele spełniają taką definicję bez mrugnięcia, bo właśnie to robią na forum i na egzaminach. Jeśli definicję zaciskam tak, żeby modele jej nie spełniały, dostaję kryterium szyte na miarę, które równie dobrze wykluczyłoby część ludzi, albo muszę sięgnąć po biologię, a wtedy wracam do Searle’a, czyli do tezy, a nie do dowodu. Turing miał rację w jednym: nikt nie pyta, czy ludzie myślą, bo przyjęliśmy konwencję, że tak, bez definicji i bez testów. Moja konwencja działa na ludziach, ale to nie znaczy, że jest definicją.
Tabela z najczęstszymi sygnałami i dwoma odczytaniami:
| Sygnał | Odczyt: nie myśli | Odczyt: za wcześnie |
|---|---|---|
| Rozmowa po polsku bez potknięć | nadal dopasowanie statystyczne | Turingowi wystarczyło zachowanie |
| Halucynacje | pewny ton przy zmyślonych faktach | artefakt kompresji, nie wyrok o wnętrzu |
| Matematyka po zmianie liczb | wyniki spadają jak w GSM-Symbolic | modele rozumujące zdają zadania olimpijskie |
| Łańcuch myśli | wyuczony styl pisania o rozumowaniu | badanie Anthropic: opis nie zawsze wierny |
Co mówią firmy, które te modele budują
OpenAI nie skrywa ambicji, wręcz przeciwnie: w charterze deklaruje, że misją firmy jest doprowadzenie do powstania sztucznej inteligencji ogólnej, rozumianej jako wysoce autonomiczne systemy przewyższające ludzi w większości ekonomicznie wartościowej pracy, i że będzie próbowała taką AGI zbudować sama. Jeśli budujesz AGI jako oficjalny cel firmy, to zakładasz po drodze, że skala, dane i trening zrobią z predyktora tokenu coś, co będzie myśleć w pełnym tego słowa znaczeniu, albo przynajmniej nie widzisz między tym zasadniczej granicy. Pełny kontekst tego, o co tu chodzi, rozwija tekst o AGI, czyli sztucznej inteligencji ogólnej.
Anthropic idzie z drugiej strony tego samego pytania i sam przyznaje, ile nie wie. Na stronie badawczej o śledzeniu myśli modelu z marca 2025 roku czytamy, że strategie, które Claude wypracował w treningu, są dla samych twórców nieprzejrzyste, więc nie rozumieją, jak modele robią większość tego, co robią. Firma zadaje pytania w rodzaju: jakim językiem, jeśli w ogóle jakim, Claude myśli w głowie, skoro mówi dziesiątkami języków, oraz czy jego wyjaśnienia krok po kroku to faktyczne kroki, czy czasem dorabianie wiarygodnego argumentu do wcześniejszego wniosku. Czyli firma, która ma największy bodaj program badania wnętrza modeli, używa słowa „myśli” w tytule własnej publikacji i jednocześnie mówi, że dopiero buduje mikroskop, żeby zajrzeć do środka. Nie znajdziesz tu pisma „modele nie myślą”, znajdziesz pismo „nie wiemy i sprawdzamy”.
LeCun i modele świata: spór toczy się w środku pola, nie na jego marginesie
Argument „to tylko predykcja tokenu” wygląda na zamknięcie tematu, a tymczasem o tym, czy predykcja może prowadzić do myślenia, spierają się najlepsi z najlepszych i nie na marginesie. Yann LeCun, jeden z trzech ojców deep learningu, nagrodzony razem z Yoshuą Bengio i Geoffreyem Hintonem Nagrodą Turinga w 2018 roku za prace nad głębokim uczeniem, od lat twierdzi, że droga dużych modeli językowych prowadzi w złą stronę. W swojej pozycyjnej pracy z 2022 roku pisze, że odpowiedzią może być uczenie się modeli świata, czyli wewnętrznych modeli tego, jak działa świat, i że dzisiejsze LLM-y, pozbawione bezpośredniego kontaktu z rzeczywistością, mają płytką wiedzę potoczną, która potrafi być oderwana od rzeczywistości. Skalowanie uznaje za niewystarczające, a obecnym modelom wyrzuca, że potrafią tylko bardzo ograniczone formy rozumowania. W wywiadzie dla Financial Times poszedł dalej i nazwał LLM-y w praktyce ślepą uliczką, jeśli chodzi o superinteligencję. Cały ten pakiet tez rozwijam osobno przy okazji modeli świata Yanna LeCuna.
Dlaczego to ważne dla pytania z tytułu? Bo LeCun nie twierdzi, że modele myślą, ale też nie przekonuje, że myślenie jest niemożliwe dla maszyn. Twierdzi, że obecna architektura jest wąskim gardłem i trzeba dołożyć modele świata, planowanie w przestrzeni reprezentacji i trening na obserwacji świata, żeby dostać systemy, które rozumieją tak jak ludzie. Jego pozycja dowodzi jednego: nawet w samym środku pola, które te systemy zbudowało, nie ma zgody co do tego, czy dokańczanie tekstu kiedykolwiek przerodzi się w myślenie, albo co musiałoby się jeszcze dołożyć, żeby tak się stało.
Jak sprawdzić to samemu (i czego te próby nie rozstrzygną)
Zamiast wierzyć albo czytać recenzje, możesz zrobić modelowi kilka prób, które pokazują jego granice w praktyce. Zebrałem je z opublikowanych badań, nie robiłem do tego tekstu własnych testów modeli, więc opisuję metody, nie wyniki.
- Weź znane zadanie tekstowe i podmień liczby albo nazwy, tak jak zespół GSM-Symbolic, i patrz, czy odpowiedź jest przeliczona na nowo, czy przywołana z pamięci wzorca.
- Zapytaj o nieistniejącą rzecz, na przykład książkę o wymyślonym tytule: model, który jej nie zna, powinien powiedzieć, że jej nie zna, a nie opisać jej treść.
- Poproś o źródło konkretnej liczby, która przewija się w odpowiedzi, i sprawdź je sam.
- Zadaj to samo pytanie dwa razy, najlepiej w dwóch oknach, i porównaj odpowiedzi.
Żadna z tych prób nie rozstrzygnie, czy model myśli, i właśnie o to chodzi. Searle pokazał już w 1980 roku, że zachowanie, nawet bezbłędne, nie dowodzi wnętrza, a badania typu GSM-Symbolic mierzą wyniki, nie proces. Co te próby dają w zamian: roboczy obraz tego, gdzie konkretny model się przewraca, na ile ufać jego wyliczeniom i kiedy sięgnąć po drugie źródło. To jest użyteczna wiedza niezależnie od tego, którą stronę sporu przyjmiesz.
FAQ
Czy AI myśli samodzielnie?
W mechanice nie ma nic, co odpowiadałoby samodzielnej inicjatywie: model odpowiada, kiedy zostanie wywołany, i generuje tekst token po tokenie, bez własnego planu i celu. Samodzielność pojawia się dopiero w opisach twórców modeli rozumujących, którzy piszą o myśleniu i naprawianiu własnych błędów, ale ich łańcuchy myśli nie zawsze opisują faktyczne obliczenia. Uczciwa odpowiedź brzmi: zależy, co uznasz za myślenie, a tej definicji nikt nie ustalił.
Czy AI myśli jak człowiek?
Na pewno nie po ludzku w sensie dosłownym: model nie ma ciała, dzieciństwa ani doświadczenia świata, na którym człowiek buduje znaczenia, i to jest zarzut LeCuna, płytka wiedza oderwana od rzeczywistości. Zachowania potrafią być bardzo ludzkie, od tłumaczenia się po zmianę zdania pod wpływem kontrargumentu. Czy za tymi zachowaniami dzieje się coś analogicznego do ludzkiego myślenia, nie wie nikt, łącznie z firmami, które modele zbudowały.
Czy ChatGPT myśli?
ChatGPT, jak każdy model językowy, przewiduje kolejne tokeny na podstawie wyuczonych wzorców, o czym szerzej pisze tekst o tym, jak działa ChatGPT. Jego odpowiedzi wyglądają na myślenie, bo wzorce z milionów ludzkich tekstów odtwarzają formę ludzkiego rozumowania. OpenAI w opisach modeli rozumujących mówi o myśleniu wprost, badacze pokazują zaś, że zapis tych rozumowań nie zawsze jest wierny. Pytanie pozostaje otwarte i to nie jest unik, to jest stan wiedzy.
Czy AI czuje?
To osobne pytanie od myślenia i jeszcze trudniejsze, bo dotyka świadomości, a jej nie umiemy zmierzyć nawet u drugiego człowieka. Model może pisać o emocjach płynnie, bo tyle tekstów o emocjach przeczytał, i nic z tego nie wynika o jakimkolwiek przeżywaniu. Searle trzyma się stanowiska, że świadomość wymaga biologicznej machinerii mózgu, inni odpowiadają, że to teza bez dowodu. Brakuje tu w ogóle miernika, więc każda odpowiedź byłaby wyznaniem wiary.
Czy sztuczna inteligencja jest świadoma?
Nie mamy na to testu. Filozof David Chalmers dopuszcza, że przyszłe systemy mogą zbliżyć się do świadomości, jeśli dostaną cechy, których dziś brakuje, innych badaczy ta droga nie przekonuje. Samo pytanie jest poza zasięgiem obecnej nauki: wiemy, które zachowania model powiela, i nie wiemy, czym byłaby świadomość w systemie zbudowanym inaczej niż mózg. Na dziś najuczciwsze jest „nie wiemy i nie mamy jak sprawdzić”.
Źródła
- Wikipedia (EN), hasło Turing test, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Turing_test
- Ted Chiang, ChatGPT Is a Blurry JPEG of the Web, The New Yorker, odczyt 15.10.2026: https://www.newyorker.com/tech/annals-of-technology/chatgpt-is-a-blurry-jpeg-of-the-web
- Iman Mirzadeh i in., GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models, arXiv, odczyt 15.10.2026: https://arxiv.org/abs/2410.05229
- Yann LeCun, A Path Towards Autonomous Machine Intelligence, OpenReview, odczyt 15.10.2026: https://openreview.net/forum?id=BZ5a1r-kVsf
- OpenAI Charter, odczyt 15.10.2026: https://openai.com/charter/
- OpenAI, Learning to reason with LLMs, odczyt 15.10.2026: https://openai.com/index/learning-to-reason-with-llms/
- Anthropic, Tracing the thoughts of a large language model, odczyt 15.10.2026: https://www.anthropic.com/research/tracing-thoughts-language-model
- Yanda Chen i in., Reasoning Models Don’t Always Say What They Think, arXiv, odczyt 15.10.2026: https://arxiv.org/abs/2505.05410