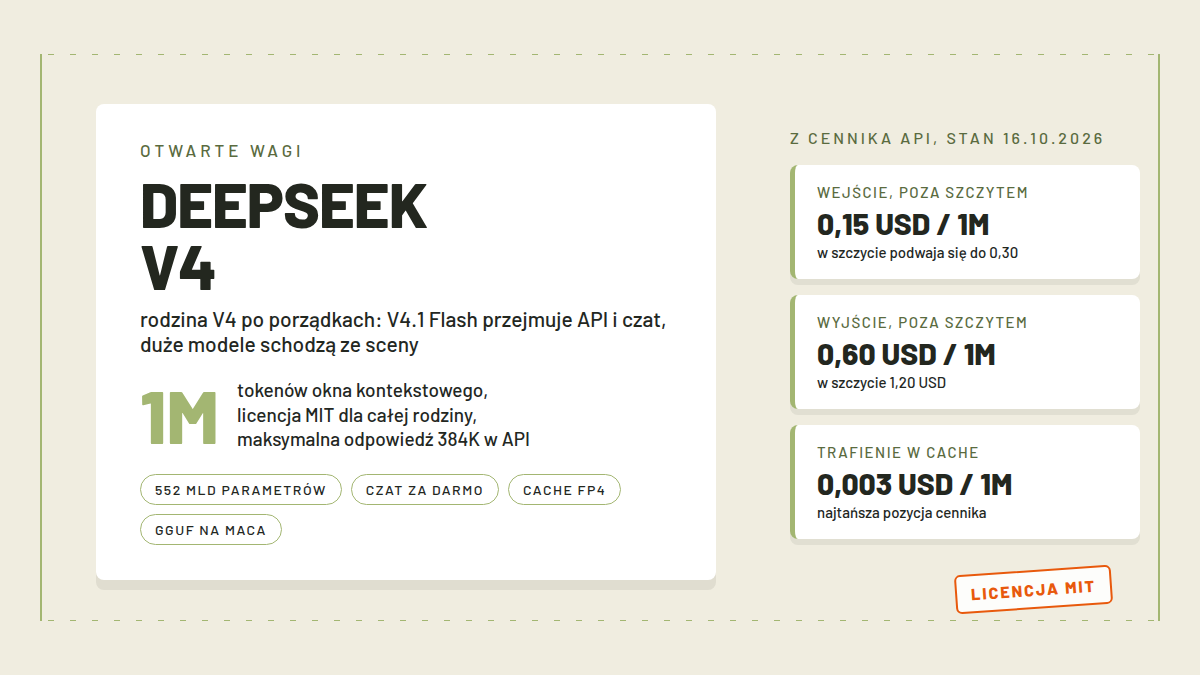
Karta DeepSeek-V4.1-Flash na Hugging Face dostała w połowie października dwie poprawki, drugą razem z nowymi wagami, i to dobry moment, żeby obejrzeć całą rodzinę V4 w spokoju. To obecnie najbardziej omawiany zestaw otwartych wag w niszy tanich modeli do pracy agentowej: licencja MIT, okno miliona tokenów i stawki API, przy których prompty liczone w setki tysięcy tokenów kosztują grosze. Jeśli szukasz modeli na własny sprzęt albo taniego zaplecza dla agentów kodowania, zajrzyj też do naszego przeglądu lokalnych modeli AI, bo rodzina V4 to jeden z najczęściej pobieranych kandydatów.
Poniższy tekst powstał w całości na dokumentacji i kartach modeli, bez własnych testów; każdy odczyt ma datę 16 albo 17 października 2026, a to ważne zastrzeżenie, bo ta rodzina przestawia się co kilka tygodni. Największa zmiana jest świeża: 10 września DeepSeek wydał V4.1 Flash, zdjął V4 Flash z API i zapowiedział wygaszanie V4 Pro, którego żądania od 14 września obsługiwane są przez młodszego modela. Poniżej masz mapę całości: co jeszcze działa, ile płacisz na czacie i w API oraz ile dysku i pamięci trzeba, żeby trzymać te wagi u siebie.
- Najważniejsze informacje
- DeepSeek V4: co to jest i jak wygląda cała rodzina
- DeepSeek V4.1 Flash: co umie najmłodszy model rodziny
- Ile kosztuje DeepSeek: cennik API na 16 października
- Czy DeepSeek jest darmowy: czat, API i wagi na Hugging Face
- Jak uruchomić DeepSeek lokalnie: GGUF, rozmiary, sprzęt
- Najczęstsze pytania
Najważniejsze informacje
| Co | Stan na 16 października 2026 |
|---|---|
| Najnowszy model | V4.1-Flash-1017, odświeżenie wag V4.1 Flash z 17 października 2026 |
| Licencja | MIT dla całej rodziny V4 |
| Okno kontekstowe | 1M tokenów, maksymalna odpowiedź 384K w API |
| Cena API za 1M | wejście od 0,15 USD, wyjście od 0,60 USD poza szczytem |
| Czat | działa bez opłat po założeniu konta, limity niepodane |
| Lokalnie | V4-Flash od pliku 80,8 GiB (komputer z 128 GB RAM), V4.1 Flash od 340,6 GiB (Mac 128 GB ze streamingiem z SSD) |
DeepSeek V4: co to jest i jak wygląda cała rodzina
DeepSeek to chińskie laboratorium AI, które od czasów R1 buduje modele o otwartych wagach i publikuje je na Hugging Face pod licencją MIT. Rodzina V4 wystartowała 24 kwietnia 2026 od dwóch wersji preview: V4-Pro z 1,6 blna parametrów, z czego 49 mld aktywnych, oraz V4-Flash z 284 mld parametrów, z których 13 mld aktywne. Oba modele dostały okno miliona tokenów, a producent zapowiedział wtedy wprost, że 1M kontekstu staje się standardem we wszystkich jego oficjalnych usługach. Na czacie rodzina pojawiła się w trybach Expert i Instant.
Dalej rodzina rosnąła łata po łacie. 27 czerwca na Hugging Face wylądowały warianty z modułem DSpark, czyli dekodowaniem spekulatywnym przyspieszającym generowanie odpowiedzi. 31 lipca wyszedł DeepSeek-V4-Flash-0731, oficjalne wydanie Flasha z mocnym naciskiem na pracę agentową, 13 sierpnia analogiczne DeepSeek-V4-Pro-0813, a 31 sierpnia doszedł eksperymentalny V4-Flash-Vision-Exp, pierwsze spojrzenie tej generacji na obrazy.
| Model | Premiera | Status na 16.10.2026 |
|---|---|---|
| V4-Flash (preview) | 24.04.2026 | wycofany z API, wagi zostają na HF |
| V4-Pro (preview) | 24.04.2026 | wygaszany, żądania API idą na V4.1 Flash |
| V4-Flash-0731 | 31.07.2026 | najczęściej pobierany model rodziny, z API zdjęty |
| V4-Pro-0813 | 13.08.2026 | wciąż na cenniku, w fazie wygaszania |
| V4-Flash-Vision-Exp | 31.08.2026 | eksperyment z wizją, z API zdjęty |
| V4.1-Flash | 10.09.2026 | główny model API i czatu |
| V4.1-Flash-1017 | 17.10.2026 | odświeżone wagi V4.1 Flash, licencja bez zmian |
Nie przeszło to bez echa. Wątek z kwietniową premierą zebrał na Hacker News ponad dwa tysiące punktów, wrześniowy o V4.1 Flash mieści się w okolicach tysiąca, a po polsku temat wraca w serwisach technologicznych co kilka dni, głównie przy okazji porównań z modelami zamkniętych labów.
Wrześniowy zwrot jest najciekawszy, bo V4.1 Flash nie jest dopieszczonym V4 Flash, tylko najmniejszym modelem zupełnie nowej architektury. Producent napisał w ogłoszeniu wprost, że testy niezależnych stron stawiają go przed V4 Pro pod względem wyników, kosztów i szybkości, i dlatego dużego modela schodzi ze sceny. Od 14 września o 04:00 UTC nazwa deepseek-v4-pro w API kieruje żądania do V4.1 Flash i rozlicza je po stawce Flasha, do czasu premiery V4.1 Pro. Ciekawostka na pograniczu marketingu i stanu faktycznego: na cenniku z odczytu 16 października V4-Pro-0813 wciąż ma własną kolumnę z pełną tabelą stawek.
DeepSeek V4.1 Flash: co umie najmłodszy model rodziny
Na papierze jest to MoE o 552 mld parametrów, z których przy przetwarzaniu wejścia aktywuje się 8 mld, a przy pisaniu odpowiedzi 16 mld. Zaskakuje architektura CED, czyli Causal Encoder-Decoder: dwadzieścia warstw enkodera, dwadzieścia dekodera, a pamięć podręczna dekodera powstaje ze stanów enkodera, nie z jego własnych warstw. Do tego dochodzi Engram, warunkowa pamięć o 196 mld parametrów, do której model sięga rzadko, token po tokenie. Trening pochłonął 45 bln tokenów, a widzenie obrazów jest natywne, bo enkoder DeepSeek ViT uczestniczy w nauce od początku.
Największy spryt siedzi w pamięci podręcznej. V4.1 Flash trzyma globalny cache KV w formacie FP4 i potrzebuje na token 890 bajtów, około czwartej tego, co V4 Flash; na dysku wystarcza mu jedna ósma poprzedniej pojemności. Producent tłumaczy, po co: opłaty za trafienia w cache robią sporą część rachunku za pracę agentów, więc kompresja cache przekłada się wprost na niższe ceny. Jest też suwak reasoning_effort od 1 do 100, którym przesuwasz granicę między kosztem a dokładnością odpowiedzi.
Wyniki producenta, a tylko takie tu są, bo własnych testów nie robiłem: 90,6 w Terminal-Bench 2.1, 74,2 procent rozwiązanego DeepSWE v1.1, 90,9 w GPQA Diamond, rating 3471 na Codeforces. W zadaniach wizyjnych 56,5 w MMMU-Pro i 95,6 w DocVQA. Dla skali: V4-Pro-0813 ma 87,9 w Terminal-Bench 2.1, więc mniejszy i nowszy model wyprzedza dużego. Liczby pochodzą z karty modelu przy maksymalnym wysiłku rozumowania.
Aktualizacja (17.10.2026): powyższy obraz przestał obowiązywać w ciągu jednego dnia. 17 października rano DeepSeek wydał na Hugging Face model DeepSeek-V4.1-Flash-1017, pierwsze odświeżenie wag V4.1 Flash od wrześniowej premiery. Karta mówi o drobnej aktualizacji, a tabela benchmarków pokazuje wyraźne skoki wobec wersji z 10 września: 42,3 wobec 31,2 w Terminal-Bench 4.0, 29,1 wobec 20,3 w ProgramBench, 42,6 wobec 36,8 w HLE bez narzędzi i 72,1 wobec 64,6 w Apex Bench. Do tego dochodzi krótszy czas wykonania zadań i zwięźlejsze odpowiedzi, czyli tańsze przejście agenta przez zadanie. Licencja zostaje MIT, a karta nie mówi wprost, kiedy model trafi do API i czatu. Wątek na Hacker News zebrał ponad 130 punktów przy odczycie 17.10. Historycznie wyglądało to tak: commit z 16 października poprawiał skrypty encoding, kolejność obrazów w narzędziach i obsługę myślenia w bieżącej turze rozmowy, 12 października naprawiono odtwarzanie cache indeksera przy niepełnych krokach kompresji, 1 października doszedł szablon czatu, a samych wag nikt nie ruszał.
Ile kosztuje DeepSeek: cennik API na 16 października
W API model kryje się pod nazwą deepseek-flash. Cennik jest dwuschodni: poza szczytem płacisz połowę stawki szczytowej, a szczyt to tylko dwa poranne okna czasu UTC w dni robocze, od 01:00 do 04:00 i od 06:00 do 10:00, z wyłączeniem chińskich świąt. Weekendy i nasze wieczory to niemal zawsze stawka niższa.
| Pozycja | deepseek-flash | deepseek-v4-pro |
|---|---|---|
| Wejście, trafienie w cache, poza szczytem | 0,003 USD | 0,022 USD |
| Wejście, trafienie w cache, szczyt | 0,006 USD | 0,044 USD |
| Wejście bez cache, poza szczytem | 0,15 USD | 0,66 USD |
| Wejście bez cache, szczyt | 0,30 USD | 1,32 USD |
| Wyjście, poza szczytem | 0,60 USD | 1,98 USD |
| Wyjście, szczyt | 1,20 USD | 3,96 USD |
Prosty rachunek na pełnym oknie: wlanie miliona tokenów dokumentacji bez cache w tańszym przedziale kosztuje 0,15 USD, a wygenerowanie miliona tokenów odpowiedzi 0,60 USD. Limit równoległości wynosi 2500 żądań dla Flasha i 500 dla V4 Pro. Stare nazwy deepseek-v4-flash i deepseek-v4-flash-vision-exp wciąż działają, ale wołają V4.1 Flash po cenie Flasha.
Praktyczny głos z rynku: autor bloga dgt.is opisał 7 października miesiąc intensywnej pracy z tym modelem w kilkunastu projektach, z sesjami, które rzadko przekraczały dolara. To relacja jednego użytkownika, nie benchmark, ale dobrze pokazuje pomysł tej architektury. Jeżeli rozważasz odpuślenie sobie subskrypcji zamkniętych modeli, ten sam problem oglądany z drugiej strony opisujemy w tekście czy warto płacić za ChatGPT.
Czy DeepSeek jest darmowy: czat, API i wagi na Hugging Face
Trzy odpowiedzi na jedno pytanie. Czat na chat.deepseek.com działa bez opłat po założeniu konta; w kwietniu rodzina V4 trafiła na niego w trybach Expert i Instant, a karta V4.1 Flash wskazuje czat jako miejsce, gdzie śmiga najnowszy model. Limitów darmowego planu producent nie publikuje, więc nie napiszę o dziennych przydziałach ani słowa. Nasz wcześniejszy test czatbotów za darmo zakończył się na DeepSeeku formularzem logowania i kontrolą „Abnormal usage environment”, więc sam dostęp bywa kapryśny.
Druga sprawa to prywatność. Polityka prywatności z odczytu 16 października nie podaje sztywnej liczby dni: dane przetwarzane na potrzeby usługi firma trzyma dopóty, dopóki istnieje Twoje konto, a historię czatów możesz kopiować i usuwać w ustawieniach. Część zachodnich producentów deklarujących krótkie, zamknięte okresy retencji wypada tu przewidywalniej. Obowiązuje stare zestawienie tego, czego nie wpisywać do AI: nie wklej tam, czego nie chciałbyś zobaczyć poza domem.
Trzecia odpowiedź jest najprostsza. Wagi na Hugging Face kosztują tyle, ile transfer, bo MIT pozwala na cokolwiek, łącznie z użyciem komercyjnym, bez raportowania i bez opłat licencyjnych. Skala zainteresowania jest widoczna w licznikach: V4-Flash-0731 ma ponad 4,4 mln pobrań, V4.1 Flash ponad 1,3 mln, a kwantyzacje od użytkownika antirez łącznie ponad 3 mln. Więcej o tym modelu dystrybucji piszemy w materiale o otwartych modelach AI: otwarte wagi nie znaczy darmowa infrastruktura, znaczy wolny wybór miejsca, gdzie ona stanie.
Jak uruchomić DeepSeek lokalnie: GGUF, rozmiary, sprzęt
Została trzecia droga i tu zaczynają się prawdziwe rozmiary. Po co w ogóle trzymać takiego kolosa u siebie, skoro API kosztuje grosze? Najczęściej o kontrolę nad danymi i pracę bez internetu, ale od strony technicznej jest jeden twardy fakt: oficjalnych kwantyzacji nie ma, a znane pliki GGUF przygotowuje użytkownik antirez pod własne silniki ds4 i DwarfStar, pisane na Metal, czyli pod Maci z Apple Silicon. Autor zastrzega, że pliki mogą, ale nie muszą ruszać w innych silnikach, więc traktuj to jako eksperyment, nie gwarancję.
Najmniejsza sensowna pozycja to V4-Flash-0731 w kwantyzacji IQ2: plik 80,8 GiB, według autora przeznaczony na maszynę z 128 GB RAM. Wersja Q4_K waży 153,3 GiB i celuje w komputery z co najmniej 256 GB pamięci. Do kompletu dołącza opcjonalny plik MTP o wadze 3,6 GiB do dekodowania spekulatywnego. To brzmi jak sprzęt z innej ligi, bo tak jest: mówimy o modelu 284 mld parametrów, nie o ośmiomiliardowych maluchach.
V4.1 Flash jest większy i tu pojawia się sprytny patent. Kwantyzacja ds41f-q2 waży 340,6 GiB, z czego 188,8 GiB to natywne tabele Engram w FP8, które silnik czyta wprost z dysku, wiersz po wierszu, więc nie muszą mieszkać w RAM. Cel wg autora: pojedynczy Mac z 128 GB pamięci i szybkim lokalnym SSD, z włączonym streamingiem. Wariant q4 to 483 GiB i tu celem docelowym jest dopiero Mac z 512 GB pamięci; osobny plik 0,9 GiB dodaje obsługę obrazów.
Dla porządku: V4-Pro-0813 w kwantyzacji IQ2 zaczyna się od pliku ponad 432 GiB, a wersja Q4 rozkłada się na dwie części i przekracza 838 GiB. W mieszkaniu to się nie zmieści, na biurku też.
Dodaj do tego koszty dopiero startujące: plik to początek, dochodzi miejsce na kontekst i bufory, o czym przypomina autor kwantyzacji. Przy stawce 0,15 USD za milion tokenów wejścia amortyzacja Maca ze 128 GB pamięci na samą oszczędność rozciąga się na lata, więc powód powinien leżeć gdzie indziej, w prywatności i niezależności. Jak takie uruchomienia wyglądają na sprzęcie z niższej półki, piszemy w poradniku o uruchamianiu lokalnych modeli.
Najczęstsze pytania
Czy DeepSeek jest darmowy?
Na trzy sposoby: czat działa bez opłat po założeniu konta, wagi na Hugging Face są darmowe na licencji MIT, a API płatne za tokeny, od 0,15 USD za milion wejścia poza szczytem. Limitów czatu producent nie publikuje. Droga lokalna kosztuje tyle, ile sprzęt: najmniejsze znane pliki zaczynają się od 80,8 GiB.
Ile kosztuje DeepSeek?
API rozlicza tokeny: deepseek-flash to 0,15 USD za milion tokenów wejścia bez cache i 0,60 USD za milion wyjścia poza szczytem, a szczyt podwaja stawki. V4-Pro-0813 kosztuje 0,66 USD i 1,98 USD w tych samych warunkach, choć jego wygaszanie trwa. Trafienia w cache tanią wejście do 0,003 USD za milion.
Czy DeepSeek mówi po polsku?
Producent nie publikuje listy języków przy kartach rodziny V4, więc twardej odpowiedzi nie ma. Model trenowano na 45 bln tokenach korpusu wielojęzycznego, ale składu językowego tego korpusu karta nie opisuje. Własnego testu po polsku nie robiłem, więc jakości ocenić nie mogę.
Czym jest DeepSeek V4.1 Flash?
Najmniejszym modelem nowej rodziny DeepSeek: MoE o 552 mld parametrów, z 8 mld aktywnych przy wejściu i 16 mld przy generowaniu, z natywnym widzeniem obrazów i oknem miliona tokenów. Od 10 września to główny model API i czatu, a od 14 września przyjmuje też żądania adresowane do V4 Pro.
Czy nazwa deepseek-v4-flash jeszcze działa w API?
Tak, dla kompatybilności stare nazwy deepseek-v4-flash i deepseek-v4-flash-vision-exp są wciąż przyjmowane, ale żądania obsługuje V4.1 Flash i rozlicza je po stawce Flasha. Samych modeli V4 Flash pod tymi nazwami już nie ma. Analogicznie deepseek-v4-pro trafia na V4.1 Flash do czasu premiery V4.1 Pro.
Co to jest DeepSeek V4 Flash 0731?
Oficjalne wydanie V4 Flash z 31 lipca 2026, z modułem dekodowania spekulatywnego DSpark i naciskiem na pracę agentową, stąd wynik 82,7 w Terminal-Bench 2.1. To wciąż najbardziej pobierany model rodziny: ponad 4,4 mln pobrań na Hugging Face. Z API zdjęto go 10 września, wagi zostały publiczne.
Źródła
- Karta modelu DeepSeek-V4.1-Flash (parametry, benchmarki, licencja), odczyt 2026-10-16: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- Historia zmian karty DeepSeek-V4.1-Flash (commity z 1, 12 i 16 października), odczyt 2026-10-16: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/commits/main
- Karta modelu DeepSeek-V4-Flash-0731, odczyt 2026-10-16: https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731
- Karta modelu DeepSeek-V4-Pro-0813, odczyt 2026-10-16: https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-0813
- Cennik API DeepSeek (stawki za 1M tokenów, godziny szczytu, limity równoległości), odczyt 2026-10-16: https://api-docs.deepseek.com/quick_start/pricing
- Ogłoszenie premiery DeepSeek-V4.1-Flash z 10 września 2026, odczyt 2026-10-16: https://api-docs.deepseek.com/news/news260910
- Ogłoszenie premiery rodziny DeepSeek-V4 z 24 kwietnia 2026, odczyt 2026-10-16: https://api-docs.deepseek.com/news/news260424
- Repozytorium kwantyzacji GGUF DeepSeek-V4.1-Flash (silnik DwarfStar), odczyt 2026-10-16: https://huggingface.co/antirez/deepseek-v4.1-flash-gguf
- Repozytorium kwantyzacji GGUF DeepSeek-V4-Flash (silnik ds4), odczyt 2026-10-16: https://huggingface.co/antirez/deepseek-v4-gguf
- Polityka prywatności DeepSeek (zasady retencji danych), odczyt 2026-10-16: https://cdn.deepseek.com/policies/en-US/deepseek-privacy-policy.html
- Analiza użytkownika dgt.is o codziennej pracy z V4.1 Flash z 7 października 2026, odczyt 2026-10-16: https://www.dgt.is/blog/2026-10-07-deepseek-freek-out/
- API Hugging Face (metadane safetensors, liczniki pobrań), odczyt 2026-10-16: https://huggingface.co/api/models/deepseek-ai/DeepSeek-V4.1-Flash
- Karta modelu DeepSeek-V4.1-Flash-1017 (benchmarki odświeżenia, licencja), odczyt 2026-10-17: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Wątek Hacker News o DeepSeek-V4.1-Flash-1017, odczyt 2026-10-17: https://news.ycombinator.com/item?id=50129045