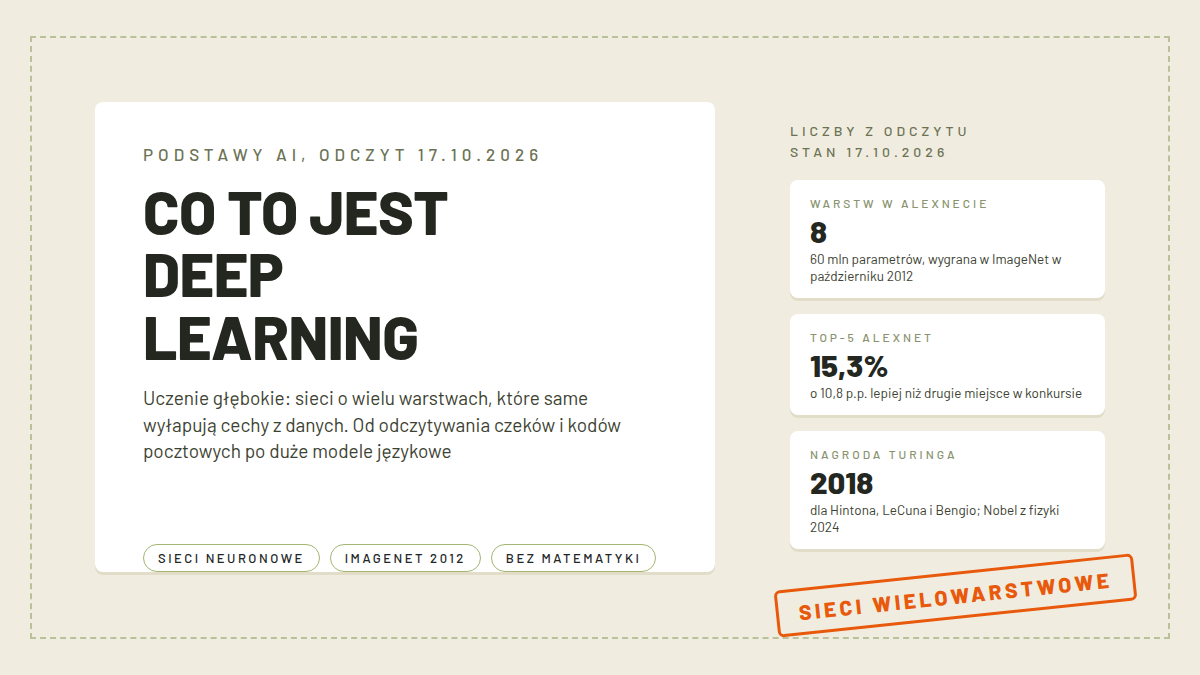
Deep learning, po polsku uczenie głębokie, to metoda uczenia maszynowego, w której model buduje sieć neuronową o wielu warstwach i sam wyłapuje cechy z danych, zamiast dostawać je na tacy od programisty. Słowo głębokie odnosi się do liczby tych warstw: angielska Wikipedia podaje zakres od trzech do kilkuset, a nawet tysięcy warstw (odczyt 17.10.2026), IBM pisze o co najmniej czterech. Brzmi jak drobnostka, a ta jedna zmiana, wiele warstw zamiast jednej albo dwóch, oddziela dzisiejsze rozpoznawanie twarzy w telefonie od programów, które dwadzieścia lat temu potrafiły co najwyżej odczytać cyfry z czeków.
W tym tekście rozkładam temat na części. Pokazuję, gdzie deep learning siedzi w rodzinie sztucznej inteligencji (to podzbiór uczenia maszynowego), co w praktyce znaczy głębokość warstw, co wyprowadziło tę technikę z wieloletniego marazmu: duże zbiory danych, karty graficzne i backpropagation, i gdzie pracuje na początku 2026 roku, od obrazów po duże modele językowe. Piszę wg źródeł z odczytem z 17 października 2026, bez pojedynczego wzoru. Szersze tło znajdziesz w przeglądzie podstaw AI, a tu zostajemy przy jednym: dlaczego sieci zaczęły być głębokie i co z tego wynikło.
- Najważniejsze informacje
- Co to jest deep learning
- Gdzie deep learning siedzi w rodzinie AI
- Skąd nazwa „głębokie”: hierarchia cech warstwa po warstwie
- Co napędziło deep learning
- Gdzie dziś pracuje deep learning
- Ograniczenia deep learning
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Co to jest | uczenie maszynowe sieciami neuronowymi o wielu warstwach |
| Ile warstw | od 3 do kilkuset, a nawet tysięcy (Wikipedia EN); IBM: co najmniej 4 |
| Gdzie siedzi | podzbiór uczenia maszynowego, które siedzi w sztucznej inteligencji |
| Przełom | AlexNet wygrywa konkurs ImageNet w październiku 2012, błąd top-5 15,3% |
| Docenienie | Nagroda Turinga 2018 dla Hintona, LeCuna i Bengio; Nobel z fizyki 2024 dla Hopfielda i Hintona |
| Co napędziło | duże datasety, GPU, backpropagation |
| Gdzie pracuje | obrazy, mowa, LLM-y (na transformerach od 2017), medycyna, rekomendacje |
| Słabe strony | głód danych i mocy, czarna skrzynka, overfitting |
Co to jest deep learning
Polska Wikipedia definiuje uczenie głębokie jako podkategorię uczenia maszynowego, która polega na uczeniu głębokich sieci neuronowych, czyli sieci z wieloma poziomami neuronów (odczyt 17.10.2026). Angielska wersja jest konkretniejsza: to wykorzystanie wielowarstwowych sieci neuronowych do zadań takich jak klasyfikacja, regresja i uczenie reprezentacji. Zwykły program, choćby najzgrabniejszy, dostaje od nas reguły: jeśli piksele ułożą się tak i tak, to na obrazie jest kot. Sieć głęboka działa odwrotnie. Dostaje tysiące zdjęć z etykietami i sama ustawia miliony parametrów tak, żeby odpowiedź wychodziła poprawnie, a po drodze buduje sobie własny opis tego, czym różni się kot od psa.
Goodfellow, Bengio i Courville w darmowym podręczniku Deep Learning piszą, że ta metoda osiąga siłę i elastyczność przez reprezentowanie świata jako zagnieżdżonej hierarchii pojęć, w której każde pojęcie jest zdefiniowane przez prostsze pojęcia (rozdział 1, odczyt 17.10.2026). Autorzy podkreślają, że głębia to nie jest jakaś mistyczna cecha, tylko dosłownie liczba warstw modelu. Recenzja z Nature z 2015 roku, którą pisali LeCun, Bengio i Hinton, formułuje to podobnie: deep learning pozwala modelom złożonym z wielu warstw przetwarzania uczyć się reprezentacji danych o wielu poziomach abstrakcji. W 2018 roku wszyscy trzej dostali Nagrodę Turinga, a Hinton dołożył w 2024 roku Nobla z fizyki.
Ciekawostka językowa, która dobrze kalibruje oczekiwania: nazwa jest starsza od rewolucji. Angielska Wikipedia podaje, że termin deep learning wprowadzono do społeczności uczenia maszynowego już w 1986 roku (Rina Dechter), a do sieci neuronowych w 2000 roku (Igor Aizenberg i współpracownicy), na długo zanim stał się hasłem marketingowym. Przez większość tego czasu głębokie sieci istniały głównie na papierze, bo nikt nie umiał ich skutecznie trenować.
Gdzie deep learning siedzi w rodzinie AI
Trzy pojęcia z tego tytułu (sztuczna inteligencja, uczenie maszynowe, deep learning) nachodzą na siebie jak matrioszki i warto je raz porozdzielać, bo w mediach bywają używane zamiennie. Sztuczna inteligencja to najszerszy worek: każdy program, który zachowuje się inteligentnie, choćby sztywno zaprogramowany. W środku siedzi uczenie maszynowe, czyli paradygmat, w którym program nie dostaje reguł, tylko uczy się z przykładów. A w uczeniu maszynowym siedzi deep learning, czyli ta część rodziny, która uczy głębokie, wielowarstwowe sieci.
Osobny przypadek to sieć neuronowa, bo o niej często myśli się, że to synonim deep learningu, a nie jest. Sieć neuronowa to pomysł i pojedyncza komórka obliczeniowa (neuron), plus sposób łączenia takich komórek w warstwy. Sieć z jedną warstwą albo z dwiema też jest siecią neuronową, tylko nikt nie nazwie jej głęboką. Deep learning zaczyna się tam, gdzie warstw robi się wiele i gdzie model uczy się reprezentacji warstwa po warstwie. IBM w swoim materiale o deep learningu zaznacza to rozróżnienie wprost: sieci neuronowe i deep learning nie są synonimami, o głębokim uczeniu mówi się przy treningu modeli z co najmniej czterema warstwami (odczyt 17.10.2026).
Skąd nazwa „głębokie”: hierarchia cech warstwa po warstwie
Najlepiej zrozumieć głębię na obrazach, bo tam hierarchia widać gołym okiem. Pierwsza warstwa patrzy na surowe piksele i uczy się wykrywać coś prostego: krawędzie, linie, łuki. Druga składa te krawędzie w prostsze kształty, rogi, kontury. Trzecia buduje z nich części obiektów, opisuje nos, oczy, koła samochodu. Czwarta zbiera części w całość i mówi: to jest twarz. Angielska Wikipedia podaje taki przykład rozkładu rozpoznawania twarzy na warstwy, a polska Wikipedia opisuje ten sam łańcuch od pikseli, przez kontrast i krawędzie, po wykrycie całego obiektu (odczyty 17.10.2026).
Sedno jest w tym, kto decyduje o tych poziomach. Przed erą deep learningu cechy pierwszej warstwy pisał człowiek: inżynier siadał i ręcznie projektował detektory krawędzi, tekstur i kształtów, a algorytm uczył się tylko klasyfikować gotowe cechy. Angielska Wikipedia nazywa to ręcznym inżynierowaniem cech i podkreśla, że proces deep learningowy sam uczy się, które cechy ustawić na którym poziomie. To jest ta różnica, która robi robotę w praktyce: sieć wytwarza sobie reprezentację danych dopasowaną do zadania, zamiast dostawać reprezentację wymyśloną z góry. Głębia zaś daje jej miejsce na wiele takich poziomów abstrakcji po drodze, od pikseli po pojęcia.
Co napędziło deep learning
Trzy rzeczy musiały zejść razem: algorytm, dane i sprzęt. Algorytmem jest backpropagation, czyli sprytna metoda rozliczania błędu z końcówki sieci wstecz, warstwa po warstwie, tak że wiadomo, jak poprawić każdy parametr. Historia jest dłuższa, niż podpowiada wyobraźnia: angielska Wikipedia wywodzi współczesną formę z prac Seppo Linnainmaa z 1970 roku, Paul Werbos zaaplikował ją do sieci neuronowych w 1982, a rozpowszechnił ją artykuł Rumelharta i współpracowników z 1986. Sama idea architektur głębokich też jest stara: neokognitron Kunihiko Fukushimy powstał w 1979, a Yann LeCun zbudował w 1989 sieć, która odczytywała kody pocztowe z kopert, trening zajmował wtedy trzy dni. Jego LeNet-5 z 1998 roku czytało u kilku banków odręczne cyfry z czeków, a według samego LeCuna na początku lat dwutysięcznych sieci konwolucyjne obsługiwały już szacunkowo 10-20% wszystkich czeków pisanych w USA.
Pomysłu więc nie brakowało. Paliwo pierwszy raz pojawiło się na masową skalę w konkursie ImageNet, gdzie w październiku 2012 roku Alex Krizhevsky, Ilya Sutskever i Geoffrey Hinton wygrali konkurs swoją siecią AlexNet z przewagą, której nikt nie przewidywał. Liczby z artykułu: błąd top-5 na poziomie 15,3%, ponad 10,8 punktu procentowego lepiej niż drugie miejsce, przy 60 milionach parametrów i 650 tysiącach neuronów w ośmiu warstwach. Autorzy artykułu podkreślali, że o wyniku zdecydowała głębokość modelu, a ta stała się wykonalna dzięki GPU, kartom graficznym, które liczyły tysiące operacji równolegle zamiast sekwencyjnie. Angielska Wikipedia opisuje dekadę 2010s jako rewolucję deep learningu napędzaną właśnie sprawnymi implementacjami sieci konwolucyjnych na GPU. Dalsze kroki to word2vec z 2013 roku, uczący się reprezentacji słów, i transformer z 2017 roku.
Kolejna fala uznania przyszła z zewnątrz dziedziny: w 2018 roku Hinton, LeCun i Bengio dostali Nagrodę Turinga, za przełomy koncepcyjne i inżynierskie, które uczyniły głębokie sieci neuronowe istotnym składnikiem informatyki (cytuję za angielską Wikipedią), a w 2024 roku Hinton i John Hopfield dostali Nobla z fizyki. Dla dziedziny, która pod koniec lat 80. i w latach 90. była zalewana zarzutami o ślepą uliczkę, to dość wymowna rehabilitacja.
Gdzie dziś pracuje deep learning
Najkrótsza odpowiedź brzmi: prawie wszędzie tam, gdzie komputer coś rozpoznaje albo generuje. Obrazy to od 2012 roku domena sieci konwolucyjnych i ich następców: rozpoznawanie obiektów na zdjęciach i w filmach, analiza obrazu medycznego, rekonstrukcja zdjęć złej jakości. Mowa przeszła na głębokie sieci przemysłowo około 2010 roku (angielska Wikipedia podaje tę datę przy rozpoznawaniu mowy), dziś asystenci głosowi słuchają nas przez modele głębokie. Polska Wikipedia wymienia w sumie przetwarzanie mowy, rozpoznawanie obrazów, przetwarzanie języka naturalnego, bioinformatykę i projektowanie leków, wykrywanie oszustw finansowych, systemy rekomendacji i samochody autonomiczne (odczyt 17.10.2026).
Najgłośniejsza gałąź to jednak język. W 2017 roku badacze Google opublikowali artykuł Attention Is All You Need, w którym zaproponowano architekturę transformer, opartą na mechanizmie uwagi zamiast przetwarzania tekstu słowo po słowie. Transformatory można trenować równolegle, co z GPU i dużymi korpusami zrobiło mieszankę wybuchową, i to na nich trenuje się dziś duże modele językowe. Czyli kiedy pytasz ChatGPT-a o cokolwiek, w tle pracuje deep learning w wariancie transformer; o samych LLM-ach napisałem osobno w tekście co to jest LLM, a o tym, jak modele językowe doglądają własnej wiedzy, w tekście o RAG. Warto też pamiętać o grach: sieci głębokie pokonały ludzi w go, a elementy tych samych technik siedzą w systemach rekomendacji, które dobierają ci film na wieczór.
Ograniczenia deep learning
Zacznę od tego, co najmocniej odczuwa każdy, kto próbował trenować coś samemu: apetyt. Głębokie sieci chcą mnóstwo danych treningowych, najlepiej z etykietami, a IBM zaznacza, że koszt zebrania dostatecznie dużych zbiorów opisanych przykładami bywa zaporowy; stąd zresztą wzięła się popularność uczenia samonadzorowanego (termin ukuł LeCun, zaznacza IBM). Do tego dochodzi moc obliczeniowa i koszty treningu dużych modeli, przez co poważne projekty deep learningowe przeprowadza się w chmurze albo na dedykowanych klastrach. Druga rzecz to czarna skrzynka: IBM pisze wprost, że poza surowym opisem matematycznym często nie ma intuicyjnego wyjaśnienia, dlaczego model podejmuje daną decyzję. Dla lekarza albo banku to nie jest akademicka ciekawostka, tylko realny problem zaufania.
Trzecia grupa ograniczeń jest techniczna. Sieci o wielu warstwach łatwo przeuczają się na danych treningowych (overfitting), bo dodatkowe poziomy abstrakcji pozwalają modelować rzadkie zależności, które w rzeczywistości są szumem; angielska Wikipedia wymienia to jako jeden z dwóch typowych problemów, obok czasu obliczeń. I na koniec przypomnienie, które powtarzam sobie samemu: sieci neuronowe były inspirowane mózgiem, ale współczesne modele nie próbują go symulować i jako opis mózgu wypadają słabo (tak piszą obie Wikipedie). Głębokie to nie znaczy myślące.
FAQ
Czym deep learning różni się od uczenia maszynowego?
Uczenie maszynowe to paradygmat: program uczy się z danych zamiast dostać gotowe reguły. Deep learning to jedna z jego gałęzi, ta, która realizuje naukę głębokimi sieciami neuronowymi o wielu warstwach. Model głęboki uczy się przy tym własnych cech danych, podczas gdy klasyczne metody uczenia maszynowego często dostają te cechy zaprojektowane przez człowieka.
Czy deep learning to to samo co sztuczna inteligencja?
Nie. Sztuczna inteligencja to najszersze pojęcie, obejmuje też systemy pisane sztywnymi regułami. Deep learning jest jej podzbiorem w trzecim pokoleniu: siedzi wewnątrz uczenia maszynowego, które siedzi wewnątrz AI. Zdanie „ten program ma w sobie AI” nie mówi więc nic o technologii, deep learning jest jedną z możliwości.
Deep learning to LLM?
Nie, ale są spokrewnione. LLM, czyli duży model językowy, to zastosowanie deep learningu: konkretne, bardzo duże sieci oparte na architekturze transformer z 2017 roku, trenowane na tekstach. Deep learning to szersza rodzina, w której mieszczą się też sieci do obrazów, mowy i medycyny. LLM jest jednym dzieckiem tej rodziny, nie jej definicją.
Jak działa deep learning w dużym skrócie?
Sieć dostaje dane na wejście i przepuszcza je przez warstwy, każda warstwa liczy swoje wyjście z wyjść warstwy poprzedniej. Na końcu model odpowiada, np. przypisuje obrazowi klasę, a my porównujemy odpowiedź z prawdą i liczymy błąd. Backpropagation rozlicza ten błąd wstecz przez warstwy i podpowiada, jak zmienić miliony parametrów, po czym całość powtarza się tysiące razy. Ta pętla: odpowiedź, błąd, korekta, powtórka, jest sercem całej metody.
Jakie są przykłady deep learningu?
Rozpoznawanie twarzy w telefonie, asystent głosowy zamieniający mowę na tekst, wykrywanie guzów w zdjęciach rentgenowskich, word2vec i transformatory w języku, systemy rekomendacji w serwisach streamingowych, AlphaGo w go. Lista z polskiej Wikipedii obejmuje poza tym deepfake’i, wykrywanie oszustw finansowych i samochody autonomiczne. Wszystkie te systemy łączy jedno: wielowarstwowa sieć, która uczy się reprezentacji z danych.
Źródła
- Wikipedia EN, hasło Deep learning (definicja, zakres warstw, historia terminu, backpropagation, ImageNet), odczyt 17.10.2026: https://en.wikipedia.org/wiki/Deep_learning
- Wikipedia PL, hasło Uczenie głębokie (definicja, łańcuch cech od pikseli, zastosowania, Nobel 2024), odczyt 17.10.2026: https://pl.wikipedia.org/wiki/Uczenie_g%C5%82%C4%99bokie
- IBM, materiał What is deep learning? (próg czterech warstw, czarna skrzynka, GPU, uczenie samonadzorowane), odczyt 17.10.2026: https://www.ibm.com/think/topics/deep-learning
- Goodfellow, Bengio, Courville, Deep Learning, rozdział 1 (zagnieżdżona hierarchia pojęć, popularizacja backpropagation), odczyt 17.10.2026: https://www.deeplearningbook.org/contents/intro.html
- LeCun, Bengio, Hinton, Deep learning, Nature 521 (2015), abstrakt (reprezentacje o wielu poziomach abstrakcji), odczyt 17.10.2026: https://www.nature.com/articles/nature14539
- Wikipedia EN, hasło AlexNet (15,3% top-5, 60 mln parametrów, 650 tys. neuronów, GPU), odczyt 17.10.2026: https://en.wikipedia.org/wiki/AlexNet
- Wikipedia EN, hasło Transformer (deep learning architecture) (2017, Attention Is All You Need, LLM-y), odczyt 17.10.2026: https://en.wikipedia.org/wiki/Transformer_(deep_learning_architecture)