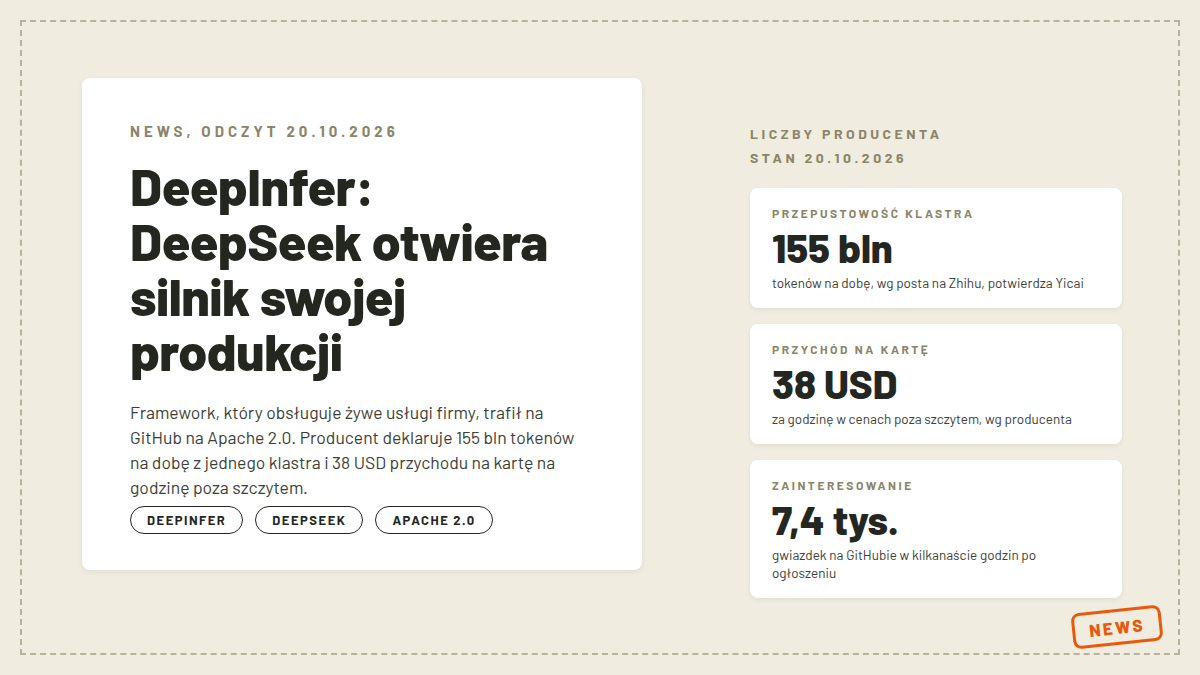
DeepSeek udostępnił na GitHubie DeepInfer, silnik inferencji, na którym firma obsługuje swoje modele w produkcji. Licencja to Apache 2.0, a metadane repozytorium pokazują datę utworzenia 16 października (odczyt API 20.10). Oficjalnym ogłoszeniem był krótki komunikat na X, „DeepInfer, our in-house inference framework, now open source”, bez wpisu na oficjalnej dokumentacji API. Chiński dziennik gospodarczy Yicai opisał otwarcie w materiale z 20 października czasu pekińskiego, a wątek na Hacker News pod tytułem „DeepSeek just open-sourced its inference engine” wystartował tego dnia o 09:08 UTC. Kilka godzin później repozytorium liczyło 7463 gwiazdek, a wątek 875 punktów i 271 komentarzy (odczyty 20.10 ok. 15:15 czasu polskiego).
Producent dorzucił do wydania deklarowane liczby z żywego serwisu: 155 bln tokenów na dobę przepustowości pojedynczego klastra i 38 USD przychodu na kartę na godzinę w cenach poza szczytem. O tym, ile kosztuje token, ostatecznie decyduje właśnie warstwa, którą firma teraz pokazała w całości.
- Najważniejsze informacje
- Co to jest silnik inferencji
- Co jest w środku
- Sprzęt: karty serwerowe i Huawei Ascend
- Liczby z produkcji: 155 bln tokenów i 38 USD
- Co to zmienia
- Co z tego dla kogo w Polsce
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Nazwa i producent | DeepInfer, DeepSeek (organizacja deepseek-ai na GitHubie) |
| Licencja | Apache 2.0 |
| Obsługiwany model | wyłącznie DeepSeek-V4.1-Flash, domyślnie checkpoint 1017 z 17 października |
| Sprzęt | karty NVIDIA SM100 oraz układy Huawei Ascend 950 |
| Wymagania budowy | Linux, GCC 13, Python 3.12, CUDA 13 albo CANN 9.2 |
| Zasięg wydania | inferencja wsadowa offline; do pełnej usługi online brakuje systemu KV cache, rozdzielenia prefill i decode oraz balansowania obciążenia |
| Liczby produkcji | 155 bln tokenów dziennie na klastrze, 38 USD na kartę na godzinę poza szczytem (deklaracja producenta z posta na Zhihu) |
| Zainteresowanie | 7463 gwiazdek na GitHubie, wątek HN z 875 punktami (odczyty 20.10 ok. 15:15) |
Co to jest silnik inferencji
Gdy piszesz do ChatGPT albo DeepSeek, między Tobą a modelem stoi warstwa, której nie widzisz. To ona skleja tysiące równoległych rozmów w partie wyliczeń, dzieli pamięć kart między żądania i decyduje, w jakiej kolejności powstają tokeny odpowiedzi. Samą inferencję, czyli moment, w którym wytrenowany model pracuje na Twoim zapytaniu, opisywaliśmy osobno w artykule co to jest inferencja.
Najpopularniejszym takim silnikiem w świecie otwartym jest vLLM, projekt na licencji Apache 2.0 z ponad 94 tys. gwiazdek na GitHubie (odczyt 20.10). Autorzy DeepInfer piszą w podziękowaniach wprost: ich framework powstał głównie na bazie vLLM, z inspiracjami z SGLang i TensorRT-LLM. To nie eksperyment laboratoryjny, tylko kod produkcyjny jednej z większych operacji inferencyjnych w branży, oddany z powrotem ekosystemowi.
Co jest w środku
Lista z README jest długa, więc przetłumaczę ją na znaczenie dla użytkownika. Pod spodem siedzą zoptymalizowane kernele: FlashMLA, DeepGEMM, DeepEP, TileKernels i DeepSelect, plus własne kernele pisane w TileLang. To biblioteki, którymi DeepSeek dzielił się już wcześniej, spięte teraz w jeden działający framework.
Najciekawsze mechanizmy dotyczą tempa generowania. Mechanizm o nazwie DSpark przyspiesza dekodowanie tokenami roboczymi: model zgaduje kilka kolejnych tokenów naraz, a silnik weryfikuje zgadywanki według oszacowania pewności. Funkcję włącza się zmienną DEEPINFER_ENABLE_MTP_VARLEN=1, a maksymalną długość zgadywania, domyślnie 5 tokenów, reguluje DEEPINFER_USE_NEXTN_DECODE. Do tego dochodzi mechanizm SWA bounded replay: przy generowaniu odpowiedzi silnik nie przetwarza całej historii rozmowy od zera, tylko odtwarza ograniczony ogon kontekstu. W domyślnych ustawieniach dla V4.1 to 140 tokenów, co pokrywa 128-tokenowe okno przesuwne modelu z małym zapasem; tryb pracy ustawia DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact, a długość bufora trzyma DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140.
Druga grupa dotyczy przewidywalności. Tryb batch-invariant, włączany przez DEEPINFER_BATCH_INVARIANT=1 (na razie tylko NVIDIA), daje identyczne wyniki niezależnie od tego, jakie inne żądania dzielą kartę w danej chwili. Po dodaniu stałego seeda próbkowania (seq_seed) i wyłączeniu tokenów roboczych ta sama rozmowa daje dokładnie tę samą odpowiedź za każdym razem. Dla kogoś, kto testuje modele albo buduje audytowalne procesy, to realna zmiana. Są też ustrukturyzowane wyjścia: silnik wymusza zgodność z wyrażeniem regularnym, schematem JSON albo gramatyką EBNF przez parametr so_args.
Skalowanie rozwiązano konfiguracją równoległą: attention DP, zbalansowany CP, ekspertowy EP dla warstw MoE z balanserem EPLB. Harmonogram zleceń jest asynchroniczny i domyślnie włączony, więc planowanie partii na CPU nachodzi na wyliczenia na kartach.
Sprzęt: karty serwerowe i Huawei Ascend
DeepInfer obsługuje dokładnie dwie rodziny sprzętu: karty NVIDIA z architekturą SM100, czyli serwerowe Blackwelle typu B200, oraz układy Ascend 950 firmy Huawei. Nie ma tu mowy o domowym komputerze ani karcie gamingowej, bo silnik projektowano pod klastry w centrach danych.
Wymagania budowy ze źródeł potwierdzają ten profil: Linux, kompilator GCC w wersji co najmniej 13, Python dokładnie 3.12, a po stronie sterowników CUDA 13 dla NVIDIA albo CANN 9.2 dla Ascend. Platformę wybiera się zmienną DEEPINFER_ACCELERATOR i skryptem ./build.sh. W repo jest też zestaw ewaluacyjny z liczbami referencyjnymi dla V4.1 (99,9% Pass@1 na AIME 2026, 93,4% na GPQA Diamond, 42,6% na HLE-Full), czyli punkt kontrolny, czy własne wdrożenie działa poprawnie. Benchmarki README mierzono na 4 kartach SM100 dla prefill i 64 dla decode.
Yicai cytuje wprost, że kompatybilność z chipami wielu producentów była celem od początku projektowania systemu inferencyjnego dla V4.1 Flash; obecność Ascenda to twardy fakt o dwóch backendach w jednym kodzie.
Liczby z produkcji: 155 bln tokenów i 38 USD
W poście na chińskim Zhihu producent napisał (tłumaczenie z komentarza na Hacker News; Zhihu zastawiło na nas CAPTCHA): „Na bazie tego frameworka zapewniliśmy usługi inferencji o wysokiej przepustowości i niskich opóźnieniach dla DeepSeek V4.1 Flash. Obecnie przepustowość usługi pojedynczego klastra wynosi 155 bln tokenów na dobę, a łączny przychód to 38 USD na kartę na godzinę (w cenach poza szczytem)”. Obie liczby potwierdza osobno Yicai, więc traktuję je jako realnie podane, choć wciąż to deklaracja bez audytu.
Wątek HN od razu zaczął je rozkładać na czynniki. Komentujący cloudbonsai uznał stawkę za zawyżoną: 38 USD przychodu na kartę na godzinę implikuje ponad 1000% zwrotu z pojedynczej karty, a Z.ai, chiński konkurent, operuje w pierwszej połowie 2026 roku na marży brutto 26%. Tu trzeba rozdzielić dwa pojęcia: liczba DeepSeek mówi o przychodzie, nie o zysku, a marża brutto już koszty uwzględnia. Ile zostaje z tej kwoty po rachunkach, nie wiadomo, bo kosztów DeepSeek nie podał. Komentujący abound odpowiadał, że amortyzowany koszt centrum danych pełnego kart jest daleko niższy niż 38 USD na kartę na godzinę, więc wielka marża nie jest niemożliwa.
Crypto Briefing podaje dodatkowo 96% trafień w cache wejścia, ok. 400 ms do pierwszego tokenu i 230 tokenów na sekundę generowania, do 300 przy kodzie. Tych liczb nie potwierdziłem u źródła i podaję je wyłącznie za tym serwisem.
Co to zmienia
Po pierwsze, to kolejne oddanie z powrotem ekosystemowi. DeepInfer powstał na vLLM, silniku Apache 2.0, i wraca do społeczności na tej samej licencji, razem z doświadczeniem ze skali trudno dostępnej dla zwykłych zespołów. Po drugie, README uczciwie wypisuje granice wydania: to inferencja wsadowa offline, a do pełnej usługi online brakuje systemu KV cache, rozdzielenia prefill i decode na osobne zasoby oraz balansera obciążenia między replikami. Producent pisze wprost, że większość funkcjonalności silnika jest już zaimplementowana, ale tych składowych repo nie zawiera.
Po trzecie, silnik obsługuje wyłącznie V4.1 Flash, żadnego większego modelu rodziny, więc o uniwersalnym serwerze do całej oferty DeepSeek mowy nie ma. Po czwarte, równoległe wsparcie NVIDIA i Huawei to sygnał o utrzymywaniu dwóch ekosystemów sprzętowych naraz; o rezygnacji z NVIDIA nie ma mowy, bo backend SM100 jest wymieniony jako pierwszy, a funkcje typu batch-invariant opisano jako dostępne wyłącznie na NVIDIA.
Co z tego dla kogo w Polsce
Zacznę od kolizy nazw, bo autocomplete podpowiada ją sam. DeepInfer to nie DeepInfra, amerykański dostawca API hostujący otwarte modele, o podobnej nazwie i zupełnie innym biznesie. Związek między nimi kończy się na podobnie brzmiącej nazwie.
Kto realnie skorzysta: operatorzy serwujący własne API na kartach SM100 albo Ascend, firmy z klastrem GPU rozważające hostowanie otwartych wag oraz badacze infrastruktury, którzy dostali do ręki działający kod z operacji tej wielkości. Zwykły użytkownik API DeepSeek nie zmienia w swojej praktyce niczego: model ten sam, cennik ten sam. Uruchomienie DeepInfer w domu odpada, wymagany jest sprzęt z klasy datacenter. Oficjalnego wpisu na api-docs.deepseek.com w chwili odczytu nie było (sondy 20.10), a Hugging Face 20 października niczego nowego nie dostał, więc źródłem pozostają GitHub, komunikat na X i post na Zhihu. O samym modelu i cenach pisaliśmy przy premierze edycji 1017, a szerzej o otwartych licencjach w tekście o otwartych modelach AI.
Najczęstsze pytania
deepinfer co to jest
To open source’owy silnik inferencji firmy DeepSeek, kod, który obsługuje produkcję ich usług modelowych. Licencja Apache 2.0, repozytorium na GitHubie, nagłośnienie 20 października 2026 przez Hacker News i chińskie serwisy. Obsługuje wyłącznie DeepSeek-V4.1-Flash na kartach NVIDIA SM100 i układach Huawei Ascend 950.
co to jest vllm
vLLM to popularny open source’owy silnik do serwowania dużych modeli językowych, z ponad 94 tys. gwiazdek na GitHubie (odczyt 20.10). Zajmuje się tym samym, co DeepInfer: skleja żądania w partie, zarządza pamięcią kart i generowaniem tokenów. Autorzy DeepInfer piszą, że ich framework zbudowali głównie na bazie vLLM.
jak uruchomić deepseek lokalnie
DeepInfer się do tego nie nadaje, bo wymaga serwerowych kart NVIDIA SM100 albo układów Huawei Ascend 950, a do budowy Linuksa z CUDA 13 lub CANN 9.2. Wagi DeepSeek-V4.1-Flash są na MIT i leżą na Hugging Face, ale to model klasy 763 mld parametrów w formacie fp8, więc realnie potrzebujesz serii kart datacenter. Realne drogi dla pojedynczej osoby to dostawcy hostujący otwarte wagi, agregatory typu OpenRouter albo oficjalne API.
ile kosztuje deepseek
Cennik first-party (odczyt 17 października): model deepseek-flash kosztuje poza szczytem 0,15 USD za milion tokenów wejścia bez cache i 0,60 USD za milion tokenów wyjścia, w szczycie podwójnie tyle. Odczyt z cache to 0,003 USD za milion. Publikacja DeepInfer na te stawki niczego nie zmienia.
licencja apache 2.0 co to
To permisyjna licencja open source: kod można używać komercyjnie, modyfikować i rozpowszechniać, w tym w produktach zamkniętych, zachowując notę licencyjną. Od MIT różni się m.in. jawnym udzieleniem licencji patentowej. Wagi modelu V4.1-Flash stoją zresztą na MIT, więc w praktyce obie te licencje należą do najłagodniejszych na rynku.
Źródła
- Repozytorium DeepInfer na GitHubie (metadane API: utworzenie 16.10, gwiazdki, licencja; odczyt 20.10): https://github.com/deepseek-ai/DeepInfer
- README DeepInfer (lista funkcji, wymagania, sprzęt, braki wydania; odczyt 20.10): https://github.com/deepseek-ai/DeepInfer/blob/main/README.md
- README ewaluacji w repo (liczby referencyjne AIME, GPQA, HLE; odczyt 20.10): https://github.com/deepseek-ai/DeepInfer/blob/main/eval/README.md
- Wątek Hacker News 50163277 (cytat z Zhihu od schneehertza, kontrargumenty cloudbonsai i abound; odczyt 20.10, 875 pkt): https://news.ycombinator.com/item?id=50163277
- Post DeepSeek na Zhihu (źródło liczb produkcyjnych; link z komentarza w wątku HN, sam post zasłonięty CAPTCHA): https://zhuanlan.zhihu.com/p/2095560295930508953
- Yicai, szanghajski dziennik gospodarczy (potwierdzenie liczb 155 bln i 38 USD, kontekst otwarcia; odczyt 20.10): https://www.yicai.com/news/103401110.html
- Karta modelu DeepSeek-V4.1-Flash-1017 na Hugging Face (MIT, fp8, kontekst 1M; odczyt 20.10): https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Repozytorium vLLM na GitHubie (licencja, skala projektu; odczyt 20.10): https://github.com/vllm-project/vllm
- Oficjalny komunikat DeepSeek na X (tytuł z wyszukiwarki HN Algolia; sam wpis za loginwallem): https://x.com/deepseek_ai/status/2112476496283775135
- Crypto Briefing (wczesny tekst EN, dodatkowe liczby serwisu; odczyt 20.10): https://cryptobriefing.com/deepseek-open-sources-deepinfer-inference-framework/
- Pasquale Pillitteri (drugi wczesny tekst EN, po włosku; odczytane metadane strony, pełna treść nieczytelna): https://pasqualepillitteri.it/deepinfer-motore-inferenza-open-source