15 października 2026 Mistral ogłosił Timestral, swoją pierwszą rodzinę fundamentowych modeli do prognozowania szeregów czasowych. Cztery modele o rozmiarach od 5M do 209M parametrów prognozują liczby, nie słowa: sprzedaż w kolejnych tygodniach, obciążenie serwerów, zużycie prądu, temperatury maszyn. Wg Mistrala największy z nich, model 209M, zajmuje pierwsze miejsce wśród modeli pretrenowanych i zero-shot na trzech głównych publicznych benchmarkach dziedziny: GIFT-Eval, TIME i fev-bench, wyprzedzając modele większe od siebie. To wejście firmy znanej z modeli językowych w dziedzinę dotąd uprawianą przez małe, wyspecjalizowane zespoły.
Ciekawe jest, kiedy świat o tym zagadał. Wątek na Hacker News pojawił się dopiero 19 października, cztery dni po publikacji: zgłosił go użytkownik groar o 09:59 czasu UTC, a przy odczytach 20 października miał ponad 600 punktów i 116 komentarzy. Odroczony start dyskusji to na HN typowy rytm dla premier spoza doliny krzemowej. Spór wyznaczył sobie jednak temat od razu: licencję wag, którą część forum uznaje za MIT-a z gwiazdką.
Po co osobny model do prognoz, skoro każdy ma chatbota? Bo prognoza sprzedaży to nie zadanie językowe: wchodzi kolumna liczb, wychodzi rozkład przyszłych wartości, a liczy się to na zwykłym procesorze, bez karty graficznej.
- Najważniejsze informacje
- Prognozowanie szeregów czasowych: po co to komu
- Co dokładnie ogłosił Mistral
- Wagi i licencja: czy uruchomisz to u siebie
- Mistral Forge: dostrajanie bez cennika
- Timestral a Chronos, TimesFM i t0-gamma
- Prognozowanie szeregów czasowych po polsku
- Najczęstsze pytania
Najważniejsze informacje
| Parametr | Stan wg źródeł (odczyt 20.10.2026) |
|---|---|
| Rozmiary | 5M, 28M, 123M i 209M parametrów, wspólna architektura |
| Wagi fp32 do pobrania | 21 MB (5M), 111 MB (28M), 490 MB (123M), 837 MB (209M) |
| Licencja wag | Modified MIT, komercyjne użycie gratis do 20 mln USD miesięcznego przychodu |
| Kod na GitHub | Apache 2.0, inferencja w PyTorch, Python 3.10+ i torch 2.4+ |
| Sprzęt | CPU albo GPU; wg Mistrala prognoza doby zajmuje 10-140 ms na 8 wątkach CPU |
| Kontekst i wyjście | do 32 768 kroków historii, prognoza z 21 kwantylami niepewności |
| Benchmarki | wg Mistrala 1. miejsce zero-shot na GIFT-Eval, TIME i fev-bench |
| Mistral Forge | fine-tuning i wdrożenia w izolowanych sieciach; cennika nie ogłoszono |
Prognozowanie szeregów czasowych: po co to komu
Jeśli prowadzisz w arkuszu wiersz na dzień i zapisujesz dzienną sprzedaż, temperaturę albo liczbę zamówień, to masz już szereg czasowy: pomiary ułożone w czasie. Prognozowanie szeregów czasowych to szacowanie dalszego ciągu takich danych na podstawie ich historii. Firmy potrzebują go przy zamawianiu towaru, planowaniu mocy serwerowni, bilansowaniu energii i serwisach maszyn. Klasycznie robiły to ARIMA i regresja liniowa, po jednym modelu na szereg, a sieci typu PatchTST, według bloga Mistrala, trenowano od zera na każdym zbiorze danych.
Modele fundamentowe przenoszą na liczby pomysł znany z językowych: najpierw trening na wielkim, różnorodnym korpusie, potem praca z danymi, których model nigdy nie widział. To jest prognozowanie zero-shot: bez dostrajania, od razu po instalacji. Samo użycie wytrenowanego modelu na nowych danych to inferencja, o której pisaliśmy osobno. Timestral zwraca 21 kwantyli dla każdego przyszłego kroku, czyli pełne widełki niepewności, pod które ustawia się progi alertów albo zapasy na scenariusz ostrożny.
Do tego dochodzą zmienne towarzyszące, po angielsku covariates. Sprzedaż lodów zależy od pogody, zużycie prądu od kalendarza świąt i dnia tygodnia, a maszyna od stanu: pracuje, stoi, jest w serwisie. Timestral przyjmuje zmienne znane tylko z przeszłości, zmienne znane z wyprzedzeniem, jak prognoza pogody czy plan przestojów, oraz kategoryczne, bez sztucznego numerowania. Wg Mistrala informacja płynie od nich wyłącznie do prognozy, więc model nie „podejrzy” przyszłości tego, co ma dopiero przewidzieć.
Co dokładnie ogłosił Mistral
Rodzinę czterech modeli o wspólnej architekturze i wspólnym przepisie treningowym. Każdy przyjmuje do 32 768 kroków historii i prognozuje do 1024 kroków w jednym przebiegu. Z ogłoszeniem wystartowało repozytorium GitHub z kodem i cztery repozytoria wag na Hugging Face. Pełny raport techniczny jest zapowiedziany, ale na dziś nieopublikowany.
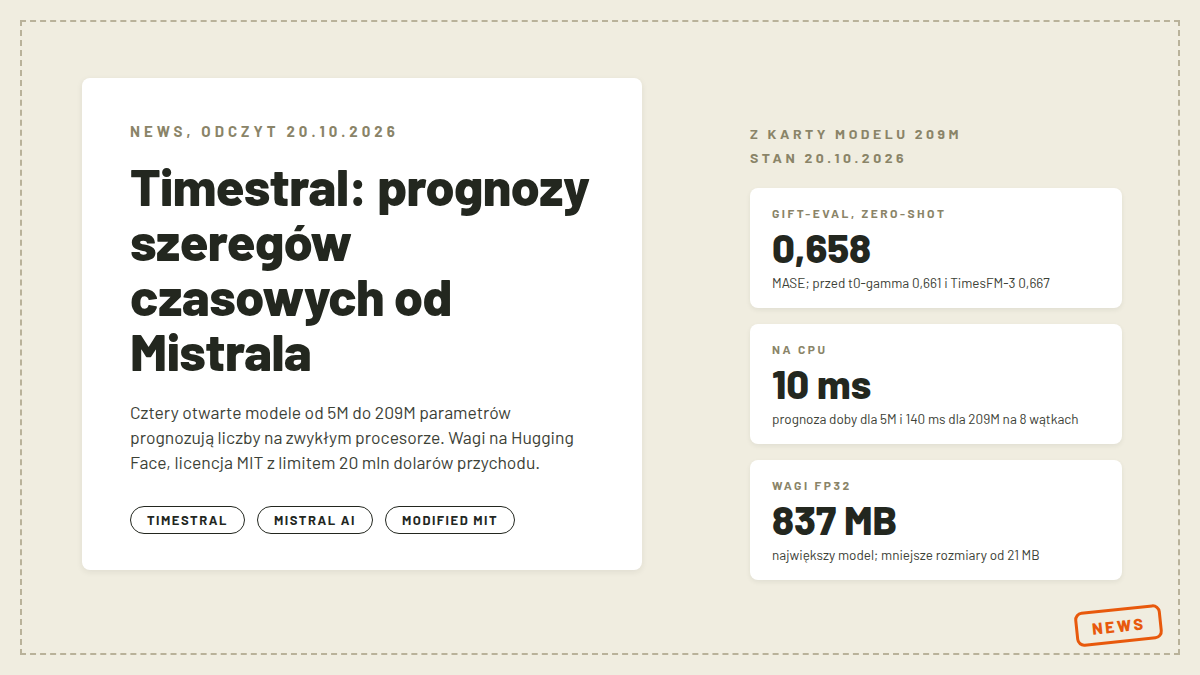
Najbardziej praktyczna liczba dotyczy sprzętu. Na serwerowym procesorze z ośmioma wątkami prognoza doby do przodu z trzech tygodni historii próbkowanej co 15 minut zajmuje, wg Mistrala, 10 ms dla modelu 5M i 140 ms dla 209M. Model 28M ma być pięć razy szybszy od największego, a 123M osiąga wynik w granicach 0,2% wyniku 209M przy trzech czwartych jego czasu odpowiedzi. Dlatego wątek „na CPU” ma znaczenie dla każdego, kto prognozuje tysiące szeregów naraz.
Liczby benchmarków pochodzą z karty modelu. Na GIFT-Eval model 209M osiąga MASE 0,658, gdzie niżej lepiej, wobec 0,661 dla lidera t0-gamma, 0,667 dla TimesFM-3 i 0,698 dla Chronos-2. Na fev-bench ma 50,39 punktu SQL skill score, gdzie wyżej lepiej, wobec 49,42 dla t0-gamma i 47,28 dla Chronos-2. Wykresy na blogu są z kolei obrazami; po pobraniu i odczytaniu pokazują tę samą kolejność: 50,4, 49,4, 49,0, 47,3. Wyniki pochodzą z jednego checkpointu, bez ensemblingu, i zostały wg Mistrala zgłoszone do leaderboardów GIFT-Eval oraz TIME.
Z technicznych składników: większość danych treningowych jest syntetyczna, prognozę piszą osobne tokeny predykcyjne przy pełnej historii w kontekście, a trening jest dwuetapowy: pre-training na syntetykach z kontekstem 8192 i dostrajanie na miksie danych realnych i syntetycznych z kontekstem czterokrotnie dłuższym.
Wagi i licencja: czy uruchomisz to u siebie
Wagi siedzą w czterech repozytoriach na Hugging Face: mistralai/Timestral-5M oraz mistralai/Timestral-28M, dalej mistralai/Timestral-123M i największy mistralai/Timestral-209M, w plikach fp32 od 21 do 837 MB. Kod w repozytorium GitHub jest na Apache 2.0, a sama inferencja wymaga tylko PyTorcha, NumPy, safetensors i huggingface_hub, na CPU albo GPU. Licznik pobrań pokazywał 20 października 4008 pobrań dla 209M i od 1,4 do 2,6 tys. dla pozostałych rozmiarów. To otwarty model w tym samym sensie, w jakim o otwartych wagach pisaliśmy w przeglądzie otwartych modeli.
Licencja wag, Modified MIT, mówi wprost: nie wolno korzystać z praw, jeśli globalny skonsolidowany miesięczny przychód firmy albo pracodawcy przekroczył w poprzednim miesiącu 20 mln USD. Powyżej progu zostaje zakup licencji komercyjnej od Mistrala albo praca przez jego usługi hostowane, plus notka atrybucyjna. Po kursie NBP z 20 października (3,8959 zł) próg to równowartość około 77,9 mln zł miesięcznie, ale to moje przeliczenie, nie deklaracja producenta. Komentarze na HN rozjechały się po tej linii: pquerna uznał nazywanie tego „zmodyfikowanym MIT” za mylące, keyle zacytował wprost pasaż licencji o limicie „$20 million”, a whiplash451 policzył, że przy progu miesięcznym da się na tych wagach zbudować firmę z obrotem 200 mln USD rocznie bez opłat.
Kontekst czyni spór mniej czarno-białym: Chronos-2 Amazona, Toto 2.0 Datadoga i t0-gamma od The Forecasting Company są na Apache 2.0, ale TimesFM 3.0 od Google wyszła na licencji niekomercyjnej, więc przy użyciu komercyjnym odpada w całości. Modified MIT z limitem przychodu plasuje Timestrala pośrodku: pozwala na biznes, dopóki nie jesteś dużym graczem.
Mistral Forge: dostrajanie bez cennika
Dla organizacji, które chcą dopasować model do własnych danych, Mistral oferuje Forge. Producent opisuje go jako „ten sam pipeline treningowy, którego używamy dla naszych modeli językowych”. Forge ma obsługiwać inferencję zero-shot od ręki, rozszerzenia architektury o domenowe zmienne towarzyszące, dostrajanie na danych własnych oraz kontrolę miksu treningowego, łącznie z wdrożeniami na sprzęcie klienta w sieciach odciętych od internetu. Tą samą drogą sprzedaje Mistral dostrajanie swoich modeli językowych, w tym Mistral Large 4 ogłoszony 6 października.
Cen nie podano: strony cenników Mistrala nie wymieniają ani Timestrala, ani Forge, a dokumentacja mówi tylko o statusie Public Preview. Kosztów fine-tuningu i inferencji przez API nie ogłoszono, terminu też.
Timestral a Chronos, TimesFM i t0-gamma
To nie jest puste pole. Chronos-2 Amazona ma na Hugging Face ponad 15,5 mln pobrań i licencję Apache 2.0, TimesFM 3.0 od Google blisko miliona, Datadog rozwija Toto 2.0, The Forecasting Company wystawiło lidera t0-gamma, a własnościowy TimeGPT od Nixtli wymieniano na HN jako płatną alternatywę. Wg bloga Mistrala model 28M bije czterokrotnie większego Chronos-2 na GIFT-Eval i TIME, a 209M wyprzedza TimesFM-3 i Falcon-2.0.
Część dyskusji na HN była zdecydowanie chłodna. Beernet uznał, że dane szeregów czasowych to „fundamentalnie co innego niż tekst”, a blog pokazuje wyimaginowanego klienta zamiast referencji. Saithound skwitował, że to „w gruncie rzeczy modele numerologiczne”, a nelaggy dopomniał, że poprawa o 0,03 w tabelce wygląda na grafach jak pięciokrotna przepaść. Z pola: dcl nie pobił Timestralem swoich baz AutoARIMA na zaszumionych danych, a jc4p przy projekcjach e-commerce najczęściej wygrywa u niego naiwna prognoza sezonowa.
Z drugiej strony odezwały się osoby prognozujące w skali. Logancbrown bronił tych modeli na przykładzie 10 tys. szeregów naraz, gdzie osobny model na szereg to złość, a jeden model fundamentowy to oszczędność pracy. Probablypower napisał wprost, że jako sprzedawca energii ma ponad 10 tys. szeregów, a niltecedu prognozuje 400 tys. co 30 minut, choć przyznaje, że xgboost na pojedynczy szereg „nigdy nie został u niego pobity”. Najbardziej wymowny był edot: pięć lat temu prognozę budował miesiącami, dziś deklaruje minuty.
Wniosek: zero-shot nie zastąpi dopracowanego modelu domenowego, ale zastąpi tydzień czytania o ARIMA tam, gdzie prognoza jest potrzebna po raz pierwszy.
Prognozowanie szeregów czasowych po polsku
Podpowiedzi Google dla polskich fraz pokazują pustkę. „Prognozowanie szeregów czasowych” ma jedną rozwiniętą podpowiedź („metodami ewolucyjnymi”), obok żyje fraza „ai prognozowanie popytu”, a hasło „timestral” nie ma żadnych podpowiedzi poza kojarzącym się „trimestral”. Nikt w Polsce nie szuka jeszcze po nazwie modelu: klasyczna sytuacja przed falą.
Wagi pobierzesz z Hugging Face bez regionalnych barier, dokumentacja jest po angielsku, po polsku nic nie zapowiedziano. Licencja liczy przychód całej grupy kapitałowej, nie pojedynczej spółki, więc w większych organizacjach decyzję i tak przejmie dział prawny, a Forge to kontakt handlowy, nie formularz z kartą płatniczą. Zawodowo prognozuje u nas sporo środowisk: e-commerce popyt per produkt, dystrybucja zapasy, energetyka obciążenie sieci, działy IT metryki serwerów.
Najczęstsze pytania
Czy Timestral jest darmowy?
Wagi są na Modified MIT: można je pobierać, modyfikować i używać komercyjnie, dopóki miesięczny przychód firmy nie przekracza 20 mln USD. Powyżej progu zostaje licencja komercyjna albo usługi hostowane Mistrala.
Czy Timestral potrzebuje GPU?
Wg Mistrala nie: inferencja działa na CPU i GPU, a prognoza doby z trzech tygodni historii zajmuje 10 ms dla modelu 5M i 140 ms dla 209M na procesorze z ośmioma wątkami. Wagi 209M zajmują 837 MB w precyzji fp32.
Czym jest prognozowanie szeregów czasowych?
To szacowanie przyszłych wartości ciągu pomiarów ułożonych w czasie, jak sprzedaży per dzień, zużycia prądu czy obciążenia serwera, na podstawie ich historii. Modele fundamentowe robią to po treningu na tysiącach obcych szeregów i prognozują nowe dane bez dostrajania. Wynikiem nie jest jedna liczba, a rozkład niepewności, u Timestrala 21 kwantyli.
Czy Timestral działa po polsku?
Model nie pracuje na języku, tylko na liczbach, więc kwestia języka dotyczy głównie dokumentacji, a ta jest po angielsku. Polskiej dokumentacji ani lokalnej wersji produktu nie ogłoszono.
Ile kosztuje fine-tuning w Mistral Forge?
Nie ogłoszono. Strony cenników Mistrala nie wymieniają Forge ani Timestrala, a dokumentacja opisuje model w statusie Public Preview. Twarde liczby pojawią się, gdy producent je opublikuje.
Źródła
- Ogłoszenie Mistrala „Introducing Timestral” z 15.10.2026 (rozmiary 5M-209M, benchmarki, czasy 10 i 140 ms na CPU, Forge, tabela specyfikacji, trening syntetyczny; odczyt 2026-10-20): https://mistral.ai/news/timestral/
- Karta modelu Timestral-209M na Hugging Face (tabele benchmarków: GIFT-Eval MASE 0,658, fev-bench 50,39, porównania z t0-gamma, TimesFM-3, Toto-2.0-2.5B, Chronos-2; kontekst 32 768 kroków, 21 kwantyli; odczyt 2026-10-20): https://huggingface.co/mistralai/Timestral-209M
- Plik LICENSE w repozytorium Timestral-209M (pełny tekst Modified MIT, próg 20 mln USD miesięcznego przychodu, nota atrybucyjna; odczyt 2026-10-20): https://huggingface.co/mistralai/Timestral-209M/blob/main/LICENSE
- Repozytorium GitHub mistralai/timestral (kod na Apache 2.0, wagi fp32 21/111/490/837 MB, Python 3.10+, torch 2.4+; odczyt 2026-10-20): https://github.com/mistralai/timestral
- API Hugging Face, wyszukiwanie „timestral” (nazwy czterech repozytoriów mistralai, liczniki pobrań 4008/2602/2511/1423, daty utworzenia 14.10; odczyt 2026-10-20): https://huggingface.co/api/models?search=timestral
- Wątek HN 50150434 (zgłoszony przez groar 19.10.2026 09:59 UTC; ponad 600 punktów i 116 komentarzy wg Algolii przy odczycie 2026-10-20; cytaty nicków po pełnych treściach komentarzy): https://news.ycombinator.com/item?id=50150434
- Karta Chronos-2 na Hugging Face (licencja Apache 2.0, ponad 15,5 mln pobrań; odczyt 2026-10-20): https://huggingface.co/amazon/chronos-2
- Karta google/timesfm-3.0-pytorch na Hugging Face (TimesFM Non-Commercial License v1.0; odczyt 2026-10-20): https://huggingface.co/google/timesfm-3.0-pytorch
- Karta t0-gamma od The Forecasting Company na Hugging Face (Apache 2.0; licencje Toto-2.0 Datadoga z API HF, też Apache 2.0; odczyt 2026-10-20): https://huggingface.co/theforecastingcompany/t0-gamma
- Dokumentacja Mistral „Timestral 1.0 209M” (status Public Preview, kontekst 32K, Modified MIT; odczyt 2026-10-20): https://docs.mistral.ai/models/timestral-1-0/
- Cennik Mistral (zero wzmianek o Timestral i Forge, czyli brak cennika; odczyt 2026-10-20): https://mistral.ai/pricing
- Kurs dolara amerykańskiego NBP, tabela 204/A/NBP/2026 z 2026-10-20 (średni 3,8959 zł; odczyt 2026-10-20): https://api.nbp.pl/api/exchangerates/rates/a/usd/?format=json
- Podpowiedzi Google PL dla fraz o prognozowaniu i „timestral” (zerowy popyt na nazwę modelu; odczyt 2026-10-20): https://suggestqueries.google.com/complete/search?client=firefox&hl=pl&gl=pl&q=prognozowanie+szereg%C3%B3w+czasowych