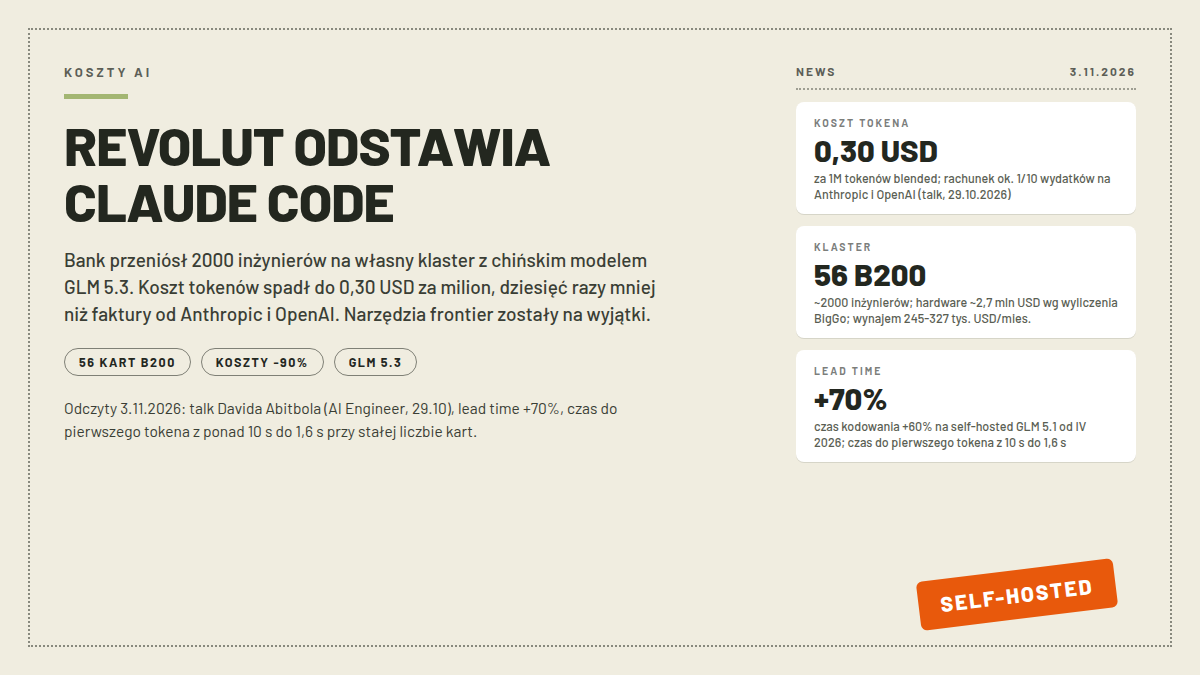
Revolut przeniósł około dwóch tysięcy inżynierów na własny klaster z chińskim, otwartym modelem GLM i skrócił rachunek za tokeny mniej więcej dziesięciokrotnie. Liczby podał David Abitbol, kierujący operacjami AI w tym banku, w nagraniu opublikowanym 29 października na kanale AI Engineer: koszt rozliczeniowy wyniósł 0,30 USD za milion tokenów, wobec faktur od Anthropic i OpenAI to według niego ułamek rzędu jednej dziesiątej. Claude Code, Codex i Gemini zostają w skrzynce z narzędziami, ale tylko jako zapas na najtrudniejsze zadania. W tym tekście rozkładamy tę zmianę na etapy: jak do niej doszło, ile kosztuje sprzęt, co dało strojenie konfiguracji i co z tej lekcji wynika dla firmy z Polski. Własnego pomiaru tu nie ma i być nie może, bo cały tekst to rozbiór publicznego nagrania i relacji prasowych, więc każda liczba dostaje źródło i datę.
- Najważniejsze informacje
- Jak Revolut doszedł do własnego klastra
- Ile kosztuje sprzęt i kiedy to się spina
- Strojenie zamiast dokupowania kart
- Bank z regulacją UE i wagi z Chin
- Co z tego dla Polski
- Czy to sygnał dla innych
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły (odczyty 3.11.2026) |
|---|---|
| Co się stało | Revolut uczynił własny hosting GLM domyślnym narzędziem do kodowania dla ~2000 inżynierów; Claude Code, Codex i Gemini przeniesione do wyjątków |
| Źródło liczb | talk Davida Abitbola (szef operacji AI Revolutu) na kanale AI Engineer, YouTube 29.10.2026, 11 min 47 s; relacja BigGo Finance; wątek HN 169 pkt |
| Koszt | blended 0,30 USD za 1M tokenów; „our invoice is one-tenth” wydatków na Anthropic i OpenAI (talk, 29.10.2026) |
| Sprzęt | ~56 kart Nvidia B200; serwer 8×B200 to ~390,7 tys. USD listowo, cały klaster ~2,7 mln USD bez zasilania i sieci (wyliczenie BigGo Finance) |
| Efekty | GLM 5.1 od kwietnia 2026: lead time +70%, czas kodowania +60%; czas do pierwszego tokena z ponad 10 s do ~1,6 s (IV-VIII 2026) bez dokupienia kart |
| Na inżyniera | wynajem 56 kart to ~245-327 tys. USD miesięcznie, czyli ~120-165 USD/osobę wobec 1000-10000 USD/osobę na API frontier (wyliczenia BigGo i HN) |
| Model | GLM 5.3, architektura MoE: ~750 mld parametrów łącznie, ~40 mld aktywnych na token (liczby z talku) |
Jak Revolut doszedł do własnego klastra
Droga zajęła około półtora roku i zaczęła się od modelu Google. Gemini wdrożone w styczniu 2025 dało 10 procent poprawy w lead time, czyli czasie od pomysłu do działającego kodu, i 20 procent w samym czasie pisania kodu. Claude Code weszło najpierw w pilotażu w lutym 2025, a na szeroką skalę w styczniu 2026, ale efektu pomiarowego prawie nie było, za to faktury tak: Abitbol mówił o wydatkach od 1000 do 10000 dolarów miesięcznie na inżyniera przy słabym zwrocie, więc wdrożenie poszło z twardymi limitami budżetowymi. Jak wygląda rozliczenie tych narzędzi od strony dostawcy, opisuje osobno nasz tekst o limitach ChatGPT i Codexa, bo OpenAI właśnie przerabia wspólne limity obu produktów.
Przełom przyszedł w kwietniu 2026 razem z przeniesieniem GLM 5.1 na własne karty. Poprawa czasu kodowania wyniosła 60 procent, a lead time aż 70 procent, przy czym ta druga liczba jest według Abitbola ważniejsza, bo pisanie kodu nigdy nie było wąskim gardłem. „What we find is the bottleneck for engineering is not necessarily coding. You can save a lot of time not having to dig through your inbox or messing with Jira and Confluence”, przytacza relacja BigGo Finance: dużo czasu ucieka na skrzynkę pocztową, Jirę i Confluence, nie na edytor. Do tego dochodzi efekt drugiego rzędu, którego nie widać w tabelach: gdy tokeny przestają być racjonowane, inżynierowie przestają oszczędzać je na najtrudniejsze zadanie kwartału i zaczynają używać modelu do wszystkiego.
| Okres | Narzędzie | Lead time | Czas kodowania |
|---|---|---|---|
| styczeń 2025 | Gemini (API) | +10% | +20% |
| od II 2025 do I 2026 | Claude Code (API) | minimalny przy starcie | minimalny przy starcie |
| od IV 2026 | self-hosted GLM 5.1 | +70% | +60% |
Ile kosztuje sprzęt i kiedy to się spina
Klaster, który obsługuje te dwa tysiące osób, to według liczb z talku około 56 kart Nvidia B200. Integrator wycenia skonfigurowany serwer z ośmioma takimi kartami na około 390,7 tysiąca dolarów listowo, więc 56 kart daje z grubsza 2,7 miliona dolarów sprzętu, jeszcze bez zasilania, sieci i chłodzenia; to wyliczenie BigGo Finance, nie deklaracja Revoluta. Bank nie ujawnił zresztą, czy karty kupił, czy wynajmuje. Gdyby wynajmował po 6-8 dolarów za godzinę karty, tyle w październiku kosztowały główne chmury, rachunek wychodzi 245-327 tysięcy dolarów miesięcznie, czyli 120-165 dolarów na inżyniera. Wobec 1000-10000 dolarów na osobę na API frontier to nadal spory dystans, nawet zanim doliczy się elektryczność i ludzi, którzy ten klaster utrzymują.
Skalę tej decyzji łatwiej ocenić na tle banku. Revolut obsługuje 80 milionów klientów w 45 rynkach, a drugi obieg akcji zamknięty w lipcu 2026 wycenił go na 115 miliardów dolarów. Wydatek rzędu trzech milionów to przy takiej skali koszt eksperymentu, nie decyzja o przetrwaniu; dokładnie tak też Abitbol o tym mówi.
Strojenie zamiast dokupowania kart
Najbardziej praktyczna część talku zaczyna się po liczbach sprzętowych. Revolut trzymał liczbę kart na sztywno od kwietnia do sierpnia 2026 i w tym czasie skrócił czas do pierwszego tokena, czyli chwilę, po której odpowiedź zaczyna się pojawiać, z ponad 10 sekund do około 1,6 sekundy. Liczba obsługiwanych żądań na sekundę wzrosła w tym samym oknie z około 3 do ponad 7. „We’ve had 88% improvement in performance for 76% increased demand”, podsumował Abitbol, dodając, że parametrów da się poprawić bardzo dużo, a dokupowanie sprzętu spokojnie poczeka.
Z listy konfiguracyjnej z talku kilka pozycji przydaje się w każdym klastrze. Cel brzmiał: czas do pierwszego tokena poniżej 3 sekund, bo po pięciu „skrzynka Slacka zaczyna wybuchać”; przepustowość 200 tokenów na sekundę wystarcza, skoro inżynierowie wysyłają zadania równolegle i wracają po wynik, a po godzinie 17, gdy karty mają luz, ten sam klaster daje 800 tokenów na sekundę. „Long context is a scam”, mówi Abitbol wprost: choć model obsłuży milion tokenów kontekstu, w praktyce wystarcza 256 tysięcy, a dłuższe okno to koszt bez zysku. Na kartach Blackwell podłogą precyzji okazał się FP4, czyli zapis liczb obcięty do czterech bitów: skok do FP8 kosztuje około 40 procent więcej mocy przy zerowej poprawie jakości. Do tego podział modelu między karty (GLM na TP4 ma za krótki cache KV, TP8 zależnie od obciążenia), wymóg trafień w cache powyżej 90 procent dla zadań kodowania, bo poniżej progu wpada i ekonomia, i latencja, i techniki typu spekulatywne dekodowanie albo rozdzielenie faz prefill i decode na osobne karty. Żadna z tych pozycji nie wymaga zakupów; to decyzje konfiguracyjne, które się składają.
Bank z regulacją UE i wagi z Chin
Chiński model w europejskim banku to sporo pracy dla prawników, ale rozwiązanie z talku opisał Abitbol krótko. Revolut pobrał tylko wagi modelu, hostuje je w infrastrukturze w USA, UE, Wielkiej Brytanii lub Izraelu i trzyma całość w sandboxie z człowiekiem w pętli; ruch inferencji nigdy nie opuszcza tej strefy i nie trafia do Chin. To istotna różnica względem wywoływania chińskiego API, gdzie każdy prompt leci do dostawcy: przy otwartych wagach dane zostają w banku, a model jest tylko plikiem na kartach. Dla polskich fintechów i banków rozważających modele otwarte ten układ jest szkieletem do dyskusji z audytorem, z zastrzeżeniem, że to opis jednego wdrożenia, nie porada prawna ani gwarancja, że własny regulator odpowiedziałby tak samo.
Co z tego dla Polski
Polscy klienci Revolutu nie zobaczą w aplikacji żadnej zmiany. To narzędzie dla inżynierów piszących kod banku, nie funkcja produktowa, a w materiale nie ma żadnych liczb per kraj, więc trzymamy się podanych: 80 milionów klientów, 45 rynków.
Częstszy w polskim autocomplecie jest drugi wątek, „glm hosting”: co trzeba mieć, żeby powtórzyć ten ruch. Odpowiedź liczbowa jest brutalna dla małych firm, bo klaster jak ten to 2,7 miliona dolarów sprzętu albo trzysta tysięcy miesięcznie najmu. Tańsza ścieżka prowadzi przez API: GLM-5.3 w cenniku z odczytu 28.10.2026 kosztuje 1,40 USD za milion tokenów wejścia i 4,40 USD za wyjście, a plany kodowania zaczynały od 18 dolarów miesięcznie, co rozpisuje nasz poradnik o GLM AI. Mniejsze modele otwarte da się uruchomić na jednej stacji roboczej, ten tor opisuje tekst o lokalnym AI; Revolut kupił sobie po prostu skrajnie duży komputer, nie nową kategorię technologii.
Trzecia obserwacja dotyczy wyboru modelu. Revolut nie sięgnął po najwyżej oceniany chiński model na wspólnej skali Artificial Analysis v5.0: GLM-5.3 ma tam 31,7 punktu z pomiarów 2.11.2026 wobec 46 punktów Kimi K3.1 Pro, ale w API kosztuje połowę (1,40/4,40 USD wobec 2/10 USD). Obserwację z wątku HN zapiszmy tak: model nie musi wygrywać rankingów, skoro załatwia zadania kodowania na poziomie wystarczającym przy ułamku ceny. Ten pojedynek z liczbami rozpisujemy w GLM vs Kimi, a całą czwórkę chińskich laboratoriów zbiera hub chińskie modele AI.
Czwarta rzecz dotyczy firm, które czytają ten tekst jako sygnał do działania. Zanim bank albo fintech przepisze playbook Revolutu do własnego wdrożenia, przechodzi decyzję z naszego klastra o AI w firmie: inwentaryzacja zadań, regulacje, budżet. Klaster na 56 kartach jest końcem tej drogi, nie jej początkiem.
Czy to sygnał dla innych
W wątku HN, który w momencie odczytu 3.11.2026 miał 169 punktów i 143 komentarze, obok dyskusji o samym Revolutcie pojawiły się trzy niezależne relacje z podobnych przejść: zespół używający self-hosted GLM 5.3 na co dzień, niemiecki klient średniej wielkości przenoszący obciążenia na własne maszyny i firma, która do otwartych modeli zepchnęła 90 procent swojej pracy. Trzy anegdoty to nie sondaż, ale też nie zero. Jeśli Revolut ujawni szczegóły umowy sprzętowej albo Z.ai opublikuje liczby o tej konfiguracji, dopiszemy aktualizację do tego wpisu.
Najczęstsze pytania
Czy Revolut przestał używać Claude Code?
Nie całkiem. Claude Code, Codex i Gemini zostają w zestawie narzędzi dla najtrudniejszych zadań, ale przestały być domyślnym wyborem; teraz wymaga się od nich uzasadnienia, dokładnie odwrotnie niż w styczniu 2026. Domyślnie działa self-hosted GLM 5.3.
Ile kosztuje hosting GLM we własnym zakresie?
W skali Revolutu: 56 kart Nvidia B200, czyli około 2,7 miliona dolarów sprzętu albo 245-327 tysięcy dolarów miesięcznie najmu (wyliczenia BigGo Finance, odczyt 3.11.2026), na obsługę około 2000 inżynierów. Revolut nie ujawnił, który wariant wybrał. Firma bez takiego budżetu ma tańszą drogę przez API GLM, od 1,40 USD za milion tokenów wejścia wg cennika z 28.10.2026, albo przez hostowanie mniejszych modeli na własnym sprzęcie.
Czy chińskie modele AI są bezpieczne dla firmy z UE?
Revolut pokazał, jak to zorganizować: pobierasz tylko wagi, hostujesz w USA, UE, Wielkiej Brytanii lub Izraelu, trzymasz wszystko w sandboxie z człowiekiem w pętli, a żadna inferencja nie leci do Chin. Czy ten układ jest bezpieczny dla konkretnej firmy, zależy od jej danych i regulatora; to opis jednego wdrożenia, nie porada prawna. Bezpieczeństwo samych wag i bezpieczeństwo infrastruktury, na której je uruchamiasz, to dwie osobne sprawy.
Czy klienci Revolutu w Polsce zauważą zmianę?
Nie. To narzędzie dla około 2000 inżynierów banku, nie funkcja produktowa, a w materiale z talku nie ma liczb dla Polski. Aplikacja, cennik i funkcje dla klientów zostają bez zmian.
Źródła
- How Revolut Cut AI Coding Costs 90% With Self-Hosted Open Models (AI Engineer, YouTube; mówca David Abitbol, Revolut) (HTTP 200, odczyt 3.11.2026: publikacja 29.10.2026, 11 min 47 s, ~78 tys. wyświetleń)
- Revolut’s David Abitbol Says Self-Hosted GLM Models Cut AI Coding Costs 90% for 2,000 Engineers (BigGo Finance) (HTTP 200, odczyt 3.11.2026: tabela timeline Gemini/Claude Code/GLM 5.1, matematyka hardware, playbook compliance, cytaty Abitbola)
- Revolut moves to self-hosted GLM, dyskusja Hacker News (HTTP 200, odczyt 3.11.2026: 169 pkt, 143 komentarze; niezależne relacje self-hostingu)
- HN Algolia API: wyszukiwanie „Revolut GLM” (HTTP 200, odczyt 3.11.2026: metadane wątku)
- Google News, zapytanie „revolut self-hosted GLM” (RSS) (HTTP 200, odczyt 3.11.2026: 37 wyników prasowych z 3.11, w tym Dealroom, tokenpost, Analytics India Magazine, StartupHub.ai)
- Zrzut z talku krążący w X, mirror nitter (link z wątku HN, odczyt mirroru 3.11.2026; oryginalny tweet za ścianą logowania)