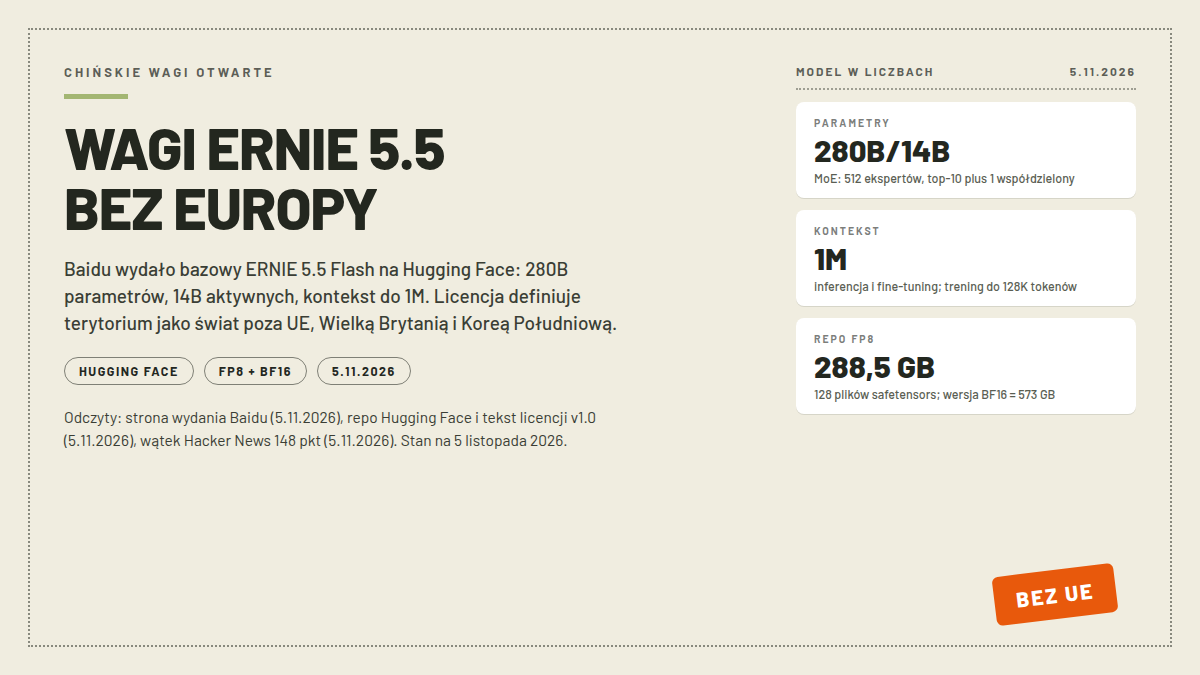
Baidu wydało 5 listopada 2026 wagi modelu ERNIE 5.5 Flash Base na Hugging Face, w dwóch wersjach: FP8 jako repozytorium główne i BF16 w osobnym repozytorium. To 280 mld parametrów w architekturze MoE, z czego 14 mld aktywnych na token, 512 ekspertów z routingiem top-10 plus jeden współdzielony, a kontekst inferencji i fine-tuningu sięga miliona tokenów. W benchmarkach opublikowanych przez Baidu model bazowy wygrywa z DeepSeek V4 Flash Base w większości zestawów, od MMLU-Pro (78,4 wobec 69,2) po HumanEval+ (82,3 wobec 69,5). Jest jeden detal, który dla polskiego czytelnika znaczy więcej niż cała tabela: licencja definiuje terytorium jako cały świat poza Unią Europejską, Wielką Brytanią i Koreą Południową, więc z punktu widzenia dokumentu użycie tych wag w Polsce nie jest upoważnione. Wątek na Hacker News zebrał w moim odczycie z wieczora 5 listopada 148 punktów, a liczba pobrań obu repozytoriów liczyła jeszcze kilkanaście sztuk, bo wydanie ma kilka godzin.
- Najważniejsze informacje
- Co znaczy base i po co Baidu to wydaje
- Liczby z tabeli i jedna pułapka porównania
- Ile sprzętu potrzebuje
- Licencja, która zamyka Europę
- ERNIE w polskim kontekście
- Dlaczego dopiero teraz i skąd ta nazwa
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Wydanie | 5.11.2026, wagi na Hugging Face: FP8 (repo główne) i BF16 (osobne repozytorium), licencja „ERNIE 5.5 Flash Base Model License Agreement v1.0″ |
| Rozmiar | 280B parametrów ogółem, 14B aktywnych na token (MoE) |
| Architektura | 512 ekspertów routowanych (top-10) + 1 współdzielony, 43 warstwy, hidden size 4096, 64 głowice uwagi, eksperci latent 2048-wym |
| Kontekst | trening do 128K tokenów, inferencja i fine-tuning do 1M |
| Rodzaj | model bazowy: koniec pre-treningu, przed mid- i post-trainingiem; wersja post-trained zapowiedziana |
| Benchmarki | MMLU 93,3; MMLU-Pro 78,4; GPQA 60,2; HumanEval+ 82,3; LiveCodeBench 40,1 (porównanie z DeepSeek V4 Flash Base, Hy3 preview i MiMo V2.5 Base) |
| Sprzęt | ok. 2×128 GB pamięci przy kwantyzacji ≥4 bitów (szacunek komentujących HN) |
| Licencja | użycie wyłącznie w terytorium, czyli poza UE, Wielką Brytanią i Koreą Południową; użycie poza terytorium „is not authorized” |
Co znaczy base i po co Baidu to wydaje
To nie jest model, z którego korzystasz jak z czatu. Wagi są checkpointem z końca pre-treningu, przed jakimkolwiek mid- albo post-trainingiem, co sama strona wydania mówi wprost: „The weights are the checkpoint at the end of pre-training, before any mid- or post-training”. Model taki nie odróżnia zadania od rozmowy, nie zna instrukcji i odpowiada jak kontynuacja tekstu, więc do agentów albo codziennej pracy nada się dopiero po dostrojaniu. Komentujący na HN podchwycili to od razu: bez instruction tuningu to materiał wyjściowy, nie produkt.
Po co więc publikować. Po pierwsze, firma i laboratoria dostają punkt startowy do własnych dostrojeń: adaptacja domenowa, własne style odpowiedzi, trening RL, a zapis o modelach pochodnych obejmuje przy tym i distylację, i trening na danych syntetycznych z tych wag. Po drugie, Baidu zapowiada kontynuację wprost: „The post-trained ERNIE 5.5 Flash will follow”, więc gotowa wersja do rozmów jeszcze przyjdzie. To konwencja, którą znają już wydawcy typu Google albo NVIDIA, i w dyskusji na HN pada argument, że dla podmiotów z zasobami do własnego treningu bazy są użyteczniejsze niż gotowce.
Praktyczna strona wygląda tak, że rozmowa z bazowym modelem przypomina dokańczanie dokumentu: wpisujesz pytanie, a on je kontynuuje, często dorzucając drugie pytanie z odpowiedzią albo rozwinięcie tekstu, zamiast czekać na kolejną turę. Dopiero tuning na przykładach dialogów uczy go roli asystenta. Właśnie dlatego w wątku HN pierwsza odpowiedź na pytanie „czy warto” brzmiała: nie do kodowania i agentów, tak do trenowania własnych wariantów. Dla kogoś, kto prowadzi badania albo buduje produkt w wąskiej domenie, to różnica między surowcem a gotowcem, i trzeba tu wiedzieć, po której stronie stoi się samemu.
Liczby z tabeli i jedna pułapka porównania
Baidu zestawiło model z trzema bazami tej samej klasy rozmiaru: DeepSeek V4 Flash Base (284B, 13B aktywnych), Hy3 preview Base (295B, 21B) i MiMo V2.5 Base (310B, 15B). ERNIE wychodzi nad nimi w większości wierszy: MMLU 93,3 wobec 89,4 u DeepSeek, MMLU-Pro 78,4 wobec 69,2, GPQA 60,2, BBH w trybie bez CoT 77,1, HumanEval+ 82,3 wobec 69,5, LiveCodeBench 40,1 wobec 31,9. Po wielojęzycznej stronie różnica się zaciera: INCLUDE-lite zostaje za DeepSeekiem (79,5 wobec 79,8), a MMMLU-lite 81,0 to prowadzenie o 2,5 punktu.
Jest jednak pułapka, którą wątek HN wyłapał szybciej niż portale. Baidu porównuje się z DeepSeek V4 Flash, a nie z V4.1 w aktualizacji 1017, czyli wersjami w tyle za aktualnym stanem rywala. Wiersze tabeli są zgodne z prawdą, ale okno porównania jest starsze, niż mogłoby być. Dla kogoś wybierającego model do własnego treningu tabela mówi zatem tyle, że ERNIE jest mocny w tej klasie rozmiaru, nie tyle, że bije najnowszego DeepSeeka.
Architektura jest współczesna i zbliżona do konwencji z tej ligi: 43 warstwy transformera, hidden size 4096, 64 głowice uwagi, eksperci w reprezentacji latent o wymiarze 2048 i routing bez pomocniczej straty balansującej. Trening przeszedł kontekst rozszerzany stopniowo do 128K, a w inferencji i fine-tuningu dokumentacja obiecuje milion tokenów, co stawia ERNIE w grupie modeli z najdłuższym oknem wśród otwartych wag.
Ile sprzętu potrzebuje
14B aktywnych nie oznacza małego modelu: wszystkie 280B wag muszą siedzieć w pamięci, bo router może sięgnąć po dowolnego eksperta. Arytmetyka z odczytów repozytoriów 5 listopada jest taka: wersja FP8 zajmuje 288,5 GB w 128 plikach safetensors, wersja BF16, czyli pełna precyzja treningowa, 573 GB w osobnym repozytorium. Dla porównania 280B parametrów zapisanych w kwantyzacji 4-bitowej to ok. 140-160 GB, skąd szacunek z dyskusji HN o dwóch serwerach po 128 GB pamięci: sprzęt klasy serwerowej, nie konsumenckiej, i to bez liczby pamięci na kontekst o długości miliona tokenów. Kto planował własne dostrojenie, musi do tego doliczyć pamięć na optymalizator i gradienty, więc realny tor treningowy zaczyna się od klastra, nie od jednej karty.
Liczby pobrań (kilkanaście w odczycie z wieczora 5.11) potwierdzają tylko, że wydanie jest świeże, i będą rosły; dla skali: 30-dniowy licznik Kimi K3 sięgnął w odczycie 4 listopada 780 tysięcy pobrań, a ten model ma podobny podział na twardy rozmiar i aktywną część. Cennika API ERNIE w tym wydaniu nie ma, bo to nie produkt sieciowy, tylko wagi do własnego hostingu; usług chmurowych Baidu nie odczytywałem 5 listopada i nie podaję ich z pamięci.
Licencja, która zamyka Europę
Największe znaczenie dla polskiego odbiorcy ma licencja. Umowa definiuje pojęcie terytorium zdaniem: „Territory” means all geographical areas worldwide other than the European Union, the United Kingdom and South Korea. Udzielenie licencji brzmi „solely within the Territory”, a paragraf 5.3 dopowiada, że materiałów objętych licencją, modeli pochodnych i ich wyników nie wolno używać, zwielokrotniać, modyfikować, rozpowszechniać ani eksponować poza tym terytorium, bo takie działania „fall beyond the rights granted here and are not authorized”. Polska leży w Unii, więc formalnie nie masz licencji na te wagi, niezależnie od tego, że pliki są do pobrania bez logowania.
Skąd taki zapis. W dyskusji na HN najczęstsze wyjaśnienie brzmi: odsunięcie w bok reżimów regulacyjnych UE i UK wśród których AI Act jest najbardziej rozbudowany, z przerzuceniem odpowiedzialności za przestrzeganie na operatora, który musi zapewnić, że jego pochodnych nie użyje nikt z wykluczonych krajów. Część komentujących ocenia klauzulę jako nieegzekwowalną, część wskazuje, że rolą dokumentu jest zmyć ręce z ryzyka prawnego, podobnie jak w pierwszych latach GDPR niektóre serwisy blokowały Europę całkowicie. Niezależnie od interpretacji sam tekst jest czytelny i dla podmiotu komercyjnego blokada działa, bo mało kto podejmie ryzyko regulacyjne dla modelu, który ma masę zamienników.
ERNIE w polskim kontekście
Nazwa ma już u nas sporą rozpoznawalność w postaci aplikacji konsumenckiej Ernie Bot, ale to wydanie jest zupełnie innym produktem: wagi dla deweloperów i badań, bez interfejsu czatu. Polski nie jest wymieniony na liście języków ani w dokumentacji wydania, a wielojęzyczne benchmarki (INCLUDE, MMMLU-lite, MultiLoKo) nie deklarują wprost jakości po polsku, więc stan na 5 listopada brzmi: niepotwierdzone, do rewizji po testach społeczności. W rodzinie chińskich wydawców to kolejny duży ruch w kilka dni: Tencent Hy4 wyszedł jako flagowiec cenowy wczoraj, Kimi pokazała wagi K3.1 Pro 4 listopada, a pełną mapę rynku trzyma hub chińskich modeli. Uruchamianie otwartych wag na własnym sprzęcie opisujemy osobno w hubie lokalnego AI.
Dlaczego dopiero teraz i skąd ta nazwa
Baidu dosyć długo trzymało ERNIE za płotem, podczas gdy DeepSeek, Kimi, GLM i Qwen budowały na otwartych wagach całą międzynarodową reputację, więc to wydanie czyta się jako wejście do gry, którą reszta rynku chińskiego już rozkręciła. Komentarz z HN oddaje to z perspektywy użytkownika: ERNIE 4 „got straight to the point”, czyli odpowiadał bez owijania, ale akurat wtedy, gdy odjechały DeepSeek v3 i GLM. Teraz Baidu przychodzi z bazą o rozmiarze ligi czołowej i zapowiedzią wersji dostrojonej.
Nazwa to skrót od „Enhanced Representation through kNowledge IntEgration” i hołd dla BERT-a, przełomowego encoderu Google z 2018 roku, od którego ta rodzina się zaczęła. Dla brytyjskiego czytelnika ERNIE znaczy co innego: maszynę losującą numery obligacji oszczędnościowych, działającą od lat 50. XX wieku. Obie konotacje są starsze niż dzisiejszy spór o wagi i obie żyją w wątku HN obok tabel z MMLU.
Najczęstsze pytania
Co to jest ERNIE AI?
ERNIE to rodzina modeli językowych Baidu, rozwijana od lat jako odpowiednik ChatGPT w ekosystemie tej firmy (aplikacja Ernie Bot). ERNIE 5.5 Flash Base z 5 listopada 2026 to pierwsze otwarte wagi tej generacji: model bazowy 280B parametrów (14B aktywnych) do własnego dostrojenia, nie czat dla konsumenta.
Czy ERNIE 5.5 Flash mówi po polsku?
Niepotwierdzone. Wydanie nie wymienia polskiego na liście języków, a wielojęzyczne benchmarki (INCLUDE-lite, MMMLU-lite) pokazują ogólną wielojęzyczność bez deklaracji o polskim. Model bazowy i tak wymaga dostrojenia, więc o jakości języka zdecyduje wersja post-trained i testy społeczności.
Czy można uruchomić ERNIE 5.5 Flash lokalnie?
Technicznie tak, sprzętowo to klasa serwerowa: szacunek z dyskusji HN mówi o 2×128 GB pamięci przy kwantyzacji od 4 bitów. Formalnie jest druga przeszkoda: licencja nie obejmuje Unii Europejskiej, więc w Polsce użycie tych wag nie jest upoważnione przez dokument, nawet jeśli pliki pobierzesz bez logowania.
Czy ERNIE 5.5 Flash jest darmowe?
Pliki wag są do pobrania za 0 zł, ale to nie licencja typu MIT czy Apache: umowa v1.0 nakłada zakazy terytorialne i odpowiedzialność za modele pochodne, a wykorzystanie poza terytorium jest poza udzielonymi prawami. To wydanie nie dotyczy cen usług Baidu w chmurze, bo chodzi o wagi do własnego hostingu.
Źródła
- Strona wydania ERNIE 5.5 Flash Base, Baidu (odczyt 5.11.2026)
- Repozytorium baidu/ERNIE-5.5-Flash-Base na Hugging Face (odczyt 5.11.2026)
- Tekst licencji ERNIE 5.5 Flash Base Model License Agreement v1.0 (odczyt 5.11.2026)
- Dyskusja na Hacker News (148 punktów, odczyt 5.11.2026)
- Repozytorium baidu/ERNIE-5.5-Flash-Base-BF16 na Hugging Face (odczyt 5.11.2026)