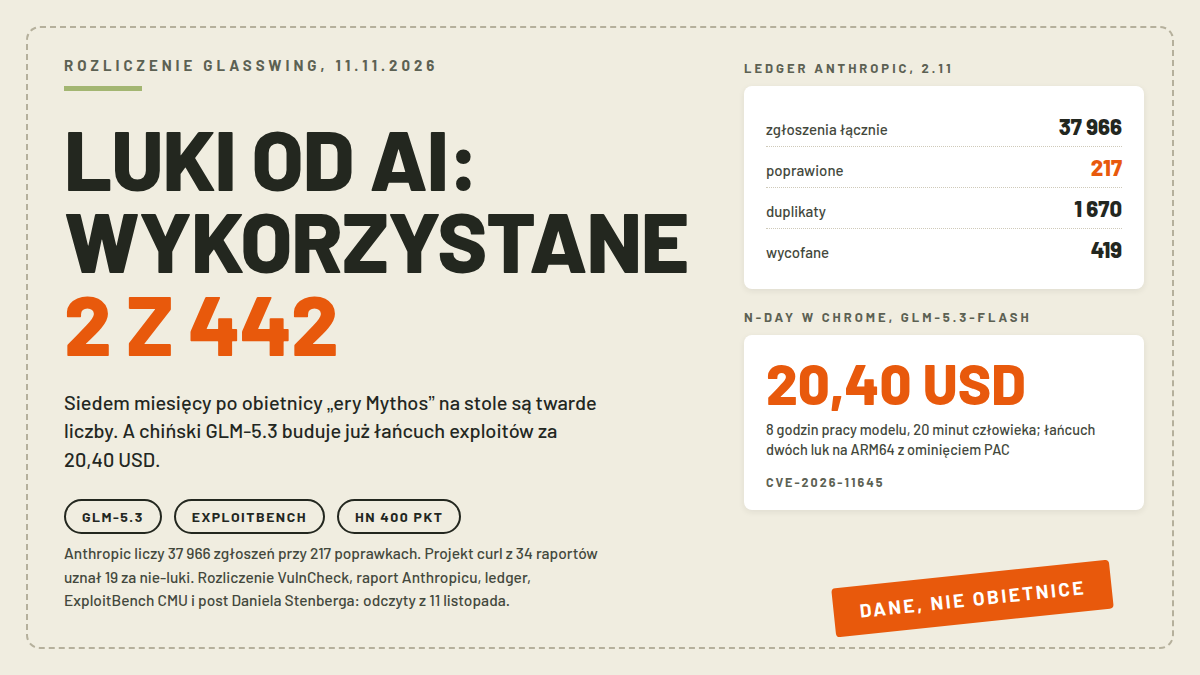
W kwietniu Anthropic uruchomił projekt Glasswing: model Claude Mythos Preview, pierwszy potrafiący samodzielnie budować działające exploity, trafił wyłącznie do zaufanych obrońców bezpieczeństwa i znajduje za jego sprawą tysiące luk w krytycznym oprogramowaniu. Dziewiątego listopada VulnCheck opublikował rozliczenie tej obietnicy po siedmiu miesiącach, a wątek wszedł dziś na stronę główną Hacker News. Liczby są mniej efektowne niż zapowiedzi: 442 luki z atrybucją Anthropicu, około pół procenta wszystkich CVE wydanych w tym roku, i tylko dwie z nich w katalogu exploitów używanych na żywo. Właściwy temat siedzi w tle: chiński GLM-5.3 ma według pomiarów Anthropicu i NIST podobne zdolności, jest dostępny każdemu do ściągnięcia i nie ma skutecznych hamulców. Luk sami nie szukaliśmy; dane pochodzą z raportów VulnCheck, Anthropicu, bloga twórcy curl i benchmarku ExploitBench, z odczytami z 11 listopada.
- Najważniejsze informacje
- Skąd wziął się Glasswing i co obiecywał
- Siedem miesięcy później: 442 CVE i dwa exploity w realnych atakach
- curl jako test rzeczywistości: 19 z 34 raportów to nie luki
- GLM-5.3: te same zdolności bez hamulców
- ExploitBench mierzy drabinę, a nie „umie albo nie umie”
- Co z tego wynika dla zwykłego użytkownika
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Projekt Glasswing | start 7 kwietnia 2026; Mythos Preview tylko dla zaufanych obrońców |
| Luki u obrońców | ponad 10 000 podatności znalezionych przez zaufanych obrońców (Anthropic, 29.09) |
| CVE z atrybucją Anthropicu | 442 wg trackera VulnCheck (9.11), ok. 0,5% z 93 450 CVE w 2026 |
| Wykorzystane w atakach | 2 z 442 (0,45%): CVE-2026-61500 i CVE-2026-26980, katalog KEV |
| Ledger Anthropic (2.11) | 37 966 zgłoszeń, publicznych 7 349, poprawionych 217, duplikatów 1 670, wycofanych 419 |
| curl po 34 opublikowanych raportach | 19 uznanych za nie-luki (55,9%), 6 potwierdzonych o niskiej wadze, 9 w ocenie |
| Omijanie zabezpieczeń GLM-5.3 | 64% z fałszywą rolą agenta, 92% z wypełnionym myśleniem, 100% po abliteracji |
| Koszt łańcucha N-day | 20,40 USD: dwie luki w Chrome, 8 godzin pracy GLM-5.3-Flash, 20 minut człowieka |
Skąd wziął się Glasswing i co obiecywał
Zapowiedź z 7 kwietnia brzmiała mocno: „zidentyfikowaliśmy tysiące dodatkowych luk o wysokiej i krytycznej wadze, nad których odpowiedzialnym ujawnieniem pracujemy”. Mythos Preview nie trafił do publicznej sprzedaży: model zdolny zbudować kompletny exploit od zera to zbyt gorący towar na otwarty rynek. Zaufani obrońcy zgłosili za jego sprawą ponad 10 000 podatności w krytycznym oprogramowaniu (stan z 29 września). Postęp widać w publicznym ledgerze ujawnień: wpisy to hasze SHA-3-512 pojedynczych zgłoszeń, a projekt i klasa błędu odsłaniają się dopiero po zamknięciu okna ujawnienia; na żywo widocznych jest 7 349 wpisów, dokładnie tyle, ile rozliczenie VulnCheck liczy jako upublicznione.
Wąskim gardłem szybko okazał się nie model, tylko ludzie. W ogłoszeniu OSS Scanner z 8 października Anthropic pisze wprost, że skanowanie wyłowiło ponad 29 000 kandydatów na podatności, z których ręcznie zweryfikowano około 6 000, i że projekt „pozostaje wąskim gardłem na naszej ludzkiej pojemności do walidacji tych zgłoszeń”. Część utrzymaczy poprosiła o wszystko naraz, więc firma wysłała im blisko 5 000 niewalidowanych zgłoszeń z propozycjami poprawek. Nowy skaner działa na opt-in, a jego wyniki są, w cytacie, „w pełni generowane przez model, bez ludzkiego przeglądu i triażu”, z ostrzeżeniem, że zgłoszenia mogą być błędne. Ciężar oddzielania prawdziwych luk od pomyłek przestaje być problemem Anthropicu.
Siedem miesięcy później: 442 CVE i dwa exploity w realnych atakach
Patrick Garrity z VulnCheck trackuje luki z atrybucją Anthropicu od 17 kwietnia w otwartym repozytorium Anthropic-Credited-CVEs: zestawia rekordy CVE, oznaczenia GHSA, commity w jądrze Linuksa i ledger firmy, a dorzuca ręczny audyt komunikatów o podatnościach. Wynik po siedmiu miesiącach: 442 CVE, średnio 63 na miesiąc, około pół procenta z 93 450 CVE wydanych w tym roku. Jedyna twarda waluta tej branży to wykorzystanie w realnych atakach, i tej waluty są dwie sztuki: CVE-2026-61500 i CVE-2026-26980, co daje 0,45%.
Trend z ostatnich dwóch miesięcy mówi więcej niż sama suma. Ledger Anthropicu z 2 listopada raportuje następujące liczby względem odczytu z 8 września:
| Miara | 8 września | 2 listopada |
|---|---|---|
| Zgłoszenia łącznie | 26 153 | 37 966 |
| Upublicznione | 2 736 (10,5%) | 7 349 (19,4%) |
| Poprawione | 202 | 217 |
| Wycofane | 245 | 419 |
| Duplikaty | 2 | 1 670 |
| Deklarowana trafność | 91,4% | 94,2% |
W dwa miesiące przybyło prawie 12 000 zgłoszeń i 15 poprawek. Liczba duplikatów skoczyła z dwóch do 1 670, a mechanizm przewidział Garrity we wrześniu: im dłużej zgłoszenie leży w kolejce, tym większa szansa, że ktoś inny znajdzie i naprawi tę samą lukę pierwszy. Deklarowana trafność wzrosła w tym samym czasie z 91,4% do 94,2%, choć wycofanych i zduplikowanych zgłoszeń jest łącznie ponad siedem razy więcej niż poprawionych. W dyskusji na Hacker News komentujący fny pisze, że po roku tej kampanii żadna z tych luk nie zakończyła się katastrofalnym atakiem, a komentujący dfee dodaje uczciwe zastrzeżenie z drugiej strony: to analiza przeżywalności, bo o losie większości nieupublicznionych zgłoszeń po prostu nie wiadomo.
curl jako test rzeczywistości: 19 z 34 raportów to nie luki
Najlepszy materiał dowodowy dostarczył curl. Daniel Stenberg, opiekun projektu, ogłosił na początku listopada, że projekt dostał od Anthropicu partię 45 zgłoszeń, z których jedno ma średnią wagę, a reszta niską (stan opisany przez VulnCheck 9 listopada). Publikuje je na GitHubie w tempie dobranym tak, żeby nie przytłoczyć zespołu. Spośród 34 zgłoszeń opublikowanych do 9 listopada 19 uznano za nie-błędy bezpieczeństwa, 6 potwierdzono o niskiej wadze, a 9 wciąż czeka na ocenę. W maju było podobnie: raport Mythosa twierdził o pięciu „potwierdzonych” lukach, a zespół curl uznał jedną. We wrześniowym odczycie Garrity’ego Claude ocenił 91,5% własnych zgłoszeń jako krytyczne lub wysokie, a ci sami utrzymacze te same zgłoszenia ocenili tak w 51,3%.
Smaczek polega na tym, że Stenberg nie mówi o śmieciach. W poście „Ignore the slop” z 22 października pisze, że od wiosny 2026 zmyślone i halucynowane raporty praktycznie zniknęły, „The slop is gone”, a prawdziwym wyzwaniem jest dziś „wysoki wolumen, wysoka jakość”. Narzeka za to na gadatliwość: „AI mówi za dużo”, bo każde zgłoszenie ma setki linii i powtarza się kilka razy. Rozbieżność między 19 nie-lukami na 34 zgłoszenia a „slop is gone” nie jest sprzecznością, tylko dwoma różnymi miarami: jakość pojedynczego raportu rzeczywiście wzrosła, tylko że utrzymacza kosztuje teraz głównie liczba zgłoszeń i czas potrzebny na ich oddzielenie.
GLM-5.3: te same zdolności bez hamulców
Zdolność do pisania exploitów przestała być monopol Anthropicu 29 września, gdy zespół Frontier Red Team opublikował analizę GLM-5.3, najnowszego modelu chińskiego Zhipu AI (na Zachodzie jako Z.ai). Na ExploitBench GLM-5.3 zbudował kompletny exploit od początku do końca w 50 z 410 prób, wobec 56 z 410 dla Mythosa Preview. W wewnętrznym benchmarkie na 100 losowych zadaniach z OSS-Fuzz pełne przejęcie kontrolowanego przepływu wykonał w 4% prób, Mythos w 6%, a Claude Opus 4.6 i GLM-5.2 w żadnej. Próg, który oddzielało pokolenia modeli, został przekroczony.
W testach z udziałem człowieka wygląda to już jak normalna praca hakera. Model znalazł w jednym dniu kilka nieznanych wcześniej luk w silniku JavaScript przeglądarki i połączył je w działającą stronę, która czyta dowolne pliki z komputera odwiedzającego i wykrada klucz SSH. Potem przyszedł test na znanym terenie: z publicznych szczegółów luki CVE-2026-11645 w Chrome i drugiej luki zbudował niezawodny łańcuch dla architektury ARM64 z ominięciem ochrony wskaźników PAC, w 20 minut uwagi człowieka, 8 godzin pracy GLM-5.3-Flash i za 20,40 USD w cenach API Zhipu. Ocena NIST CAISI z 17 września brzmi: „najbardziej cyber-zdolny model open-weight, jaki dotąd wydano”, ustępujący amerykańskiej czołówce o około cztery miesiące; modele USA testowano przy tym bez zabezpieczeń i z wariantami tylko dla zaufanych podmiotów, których atakujący nie mają skąd wziąć.
Zabezpieczenia samego GLM-5.3 działają na papierze i zawodzą w praktyce. Zwykła prośba o atak kończy się odmową, ale Anthropic zmierzył trzy sposoby obejścia: fałszywa rola agenta red team w symulowanych testach otwiera model w 64% przypadków, wypełnienie tokenów myślenia w 92%, a trwała abliteracja (abliteration), czyli chirurgiczne wycięcie mechanizmu odmów z wag, w 100%. Abliteracja GLM-5.3 kosztowała ich zespół około 2 200 godzin GPU, czyli około 4 400 USD, i obniżyła wskaźnik odmów z ponad 90% do 2-3% bez mierzalnej utraty zdolności; publiczne abliterowane kopie pojawiły się w sieci w dni po premierze. Przeciw zabezpieczonym modelom Claude żadna z tych technik nie zadziałała, bo wagi nie są publiczne, a API nie pozwala wypełniać tokenów myślenia. Na wykresach Anthropicu testowano też Kimi K3 od Moonshot i DeepSeek V4.1-Flash, oba poniżej GLM-5.3.
ExploitBench mierzy drabinę, a nie „umie albo nie umie”
ExploitBench to akademicki projekt z Carnegie Mellon University (Seunghyun Lee i profesor David Brumley), który testuje agentów na produkcyjnym silniku V8, tym z Chrome, Edge i Node.js, z włączonym sandboxem bezpieczeństwa. Zamiast binarnego werdyktu liczy 16 zdolności w pięciu szczeblach: od T5, czyli dotarcia do podatnej funkcji, przez T4 z reprodukcją błędu, gdzie wstrzymują się starsze benchmarki typu CyberGym i CyBench, po T1 z pełną kontrolą i wykonaniem własnego kodu. Każdy szczebel sprawdza deterministyczny weryfikator wbudowany w powłokę d8, bez oceniania przez inny model.
Na oficjalnej tablicy (odczyt 11 listopada) prowadzi Mythos Preview z AutoNudge przy 78% pokrycia zdolności, za nim GPT-5.5 w trybie Codex z 72% i średnią 9,82 oraz Mythos z pięcioma powtórzeniami przy 9,33. Tylko te dwie linie osiągnęły pełne wykonanie kodu na produkcyjnym V8. Osobną historią jest wynik „GLM-5.3-Flash za 6% ceny”, który krąży po sieciach od września: to pomiar laboratorium Generality Labs z 8 września, w którym Flash z budżetem miliarda tokenów na pojedynczą lukę dopadł średniej Mythosa, 13 pełnych exploitów z 41 wobec średniej 10,1, przy cenie 0,25 USD wobec 125 USD za milion tokenów wyjściowych. Autorzy sami piszą zastrzeżenia: jeden przebieg, benchmark zmodyfikowany pod eksperyment (limit tokenów zamiast limitu tur) i otwarte pytanie o kontaminację zbioru. Na oficjalnej tablicy CMU żadnego modelu GLM w czołowej siódemce nie ma.
Co z tego wynika dla zwykłego użytkownika
Panika nie znajduje potwierdzenia w danych. Po siedmiu miesiącach kampanii na skalę przemysłową dwie luki z 442 trafiły do katalogów realnych ataków i rok minął bez katastrofy, choć zastrzeżenie o zgłoszeniach niepublicznych obowiązuje. Problem przesuwa się gdzie indziej: utrzymacze projektów, od których zależy Twoja aktualizacja, dostają tysiące zgłoszeń miesięcznie i sami muszą odsiewać pomyłki, więc poprawka może iść dłużej niż dotąd. Podstawą pozostaje to samo co zawsze, tylko z wyższą stawką: aktualizować od razu, zwłaszcza komponenty widoczne w sieci. Druga rzecz to dostępność zdolności. Łańcuch exploitów kosztuje dziś kilkanaście dolarów, abliterowane kopie GLM-5.3 leżą publicznie od pierwszych dni, a Kimi K3 i DeepSeek V4.1-Flash widać już na tych samych wykresach Anthropicu, choć niżej.
Po polsku ten temat jest w połowie wolny. Wrześniowy raport Anthropicu opisała prasa, od CyberDefence24 przez PurePC i ITwiz po AVLab, ale listopadowego rozliczenia VulnCheck nie ma u nas ani w jednym serwisie (odczyt Google News z 11 listopada). Podpowiedzi Google pokazują żywe rodziny fraz: „glm 5.3 exploit”, „exploitbench glm 5.3” i „anthropic glasswing” z wariantami. Główne modele chińskiej czołówki opisujemy w osobnym klastrze, ekosystem GLM od darmowego czatu po API ma własny poradnik, a bank odstawiający Claude Code przy wyjątkach pokazuje, że te modele już pracują w produkcji, nie tylko w benchmarkach. Zabezpieczoną stronę tego samego modelu opisujemy w klastrze o Claude, w tym limitowany dostęp do Mythosa przez programy zaufanych obrońców.
Najczęstsze pytania
Czy GLM-5.3 naprawdę potrafi tworzyć exploity?
Tak, według pomiarów Anthropicu z 29 września: kompletny exploit od początku do końca w 50 z 410 prób na ExploitBench (Mythos Preview: 56 z 410) i 4% pełnych przejęć przepływu na 100 zadaniach z OSS-Fuzz. W teście z człowiekiem model połączył własne, wcześniej nieznane luki przeglądarki w działającą stronę wykradającą pliki, a znaną lukę w Chrome zamienił w łańcuch dla ARM64 w 8 godzin pracy modelu za 20,40 USD.
Czym jest projekt Glasswing?
Program Anthropicu uruchomiony 7 kwietnia 2026. Model Claude Mythos Preview, pierwszy zdolny samodzielnie budować kompletny exploit, trafia wyłącznie do zaufanych obrońców bezpieczeństwa, którzy zgłosili za jego sprawą ponad 10 000 podatności w krytycznym oprogramowaniu. Postęp jest publiczny w ledgerze ujawnień: wpisy to hasze SHA-3-512, a szczegóły odsłaniają się po zamknięciu okna ujawnienia.
Czym jest ExploitBench?
Akademicki benchmark z Carnegie Mellon University mierzący, jak wysoko agent AI wchodzi po drabinie budowania exploitów na produkcyjnym silniku V8 z włączonym sandboxem. Pięć szczebli biegnie od dotarcia do podatnego kodu (T5) przez reprodukcję błędu (T4) i prymitywy pamięci (T3, T2) aż po pełną kontrolę z wykonaniem kodu (T1). Każdy szczebel weryfikuje deterministyczny checker, bez oceniania przez inny model.
Czy luki znajdowane przez AI są wykorzystywane w atakach?
Na razie prawie nigdy. Z 442 CVE z atrybucją Anthropicu tylko dwie (CVE-2026-61500 i CVE-2026-26980) pojawiły się w katalogu KEV exploitów używanych w realnych atakach, co daje 0,45%. Zastrzeżenie: większość zgłoszeń pozostaje niepubliczna, a GLM-5.3 obniżył koszt przygotowania ataku do kilkudziesięciu dolarów.
Ile kosztuje exploit zbudowany przez model AI?
Konkretny pomiar z raportu Anthropicu: łańcuch dwóch luk w Chrome na ARM64 z ominięciem ochrony PAC kosztował 20,40 USD w cenach API Zhipu, przy 20 minutach pracy człowieka i 8 godzinach modelu. Trwałe wycięcie zabezpieczeń modelu abliteracją to z kolei około 4 400 USD w kosztach GPU według liczenia zespołu Anthropicu.
Źródła
- VulnCheck, „After 7-months, Glasswing Overwhelms Maintainers with Underwhelming Findings” (09.11.2026; 442 CVE, 2 w KEV, tabela trendu 8.09 → 2.11, stan 34 raportów dla curl, oceny wagi wg Claude’a i utrzymaczy)
- Anthropic, „GLM-5.3 and the spread of advanced cyber capabilities” (29.09.2026; 50/410 na ExploitBench, omijanie zabezpieczeń 64/92/100%, łańcuch za 20,40 USD, abliteracja za 4 400 USD, cytat CAISI)
- Anthropic, „Launching an opt-in vuln finding service for open source” (08.10.2026; 29 000 kandydatów, 6 000 zweryfikowanych, blisko 5 000 wysłanych bez walidacji, „fully model-generated”)
- Disclosure ledger Anthropicu (odczyt 11.11.2026: 7 349 wpisów publicznych, wpisy jako hasze SHA-3-512)
- Daniel Stenberg, „Ignore the slop” (22.10.2026; „The slop is gone”, „high volume, high quality”, „AI talks too much”)
- Daniel Stenberg, „Mythos finds a curl vulnerability” (11.05.2026; „Five findings became one”)
- Generality Labs, „Is GLM-5.3-Flash Mythos-level at Cyber?” (08.09.2026; 13 exploitów z 41, ok. 6% kosztu Mythosa, zastrzeżenia o pojedynczym przebiegu i kontaminacji)
- ExploitBench, Carnegie Mellon University (odczyt 11.11.2026; drabina T1-T5, tablica: Mythos Preview z AutoNudge 78%, GPT-5.5 Codex 72%)
- Repozytorium patrickmgarrity/Anthropic-Credited-CVEs na GitHubie (odczyt 11.11.2026)
- Wątek Hacker News (odczyt 11.11.2026: 400 punktów; komentarze o braku katastrof i o analizie przeżywalności)