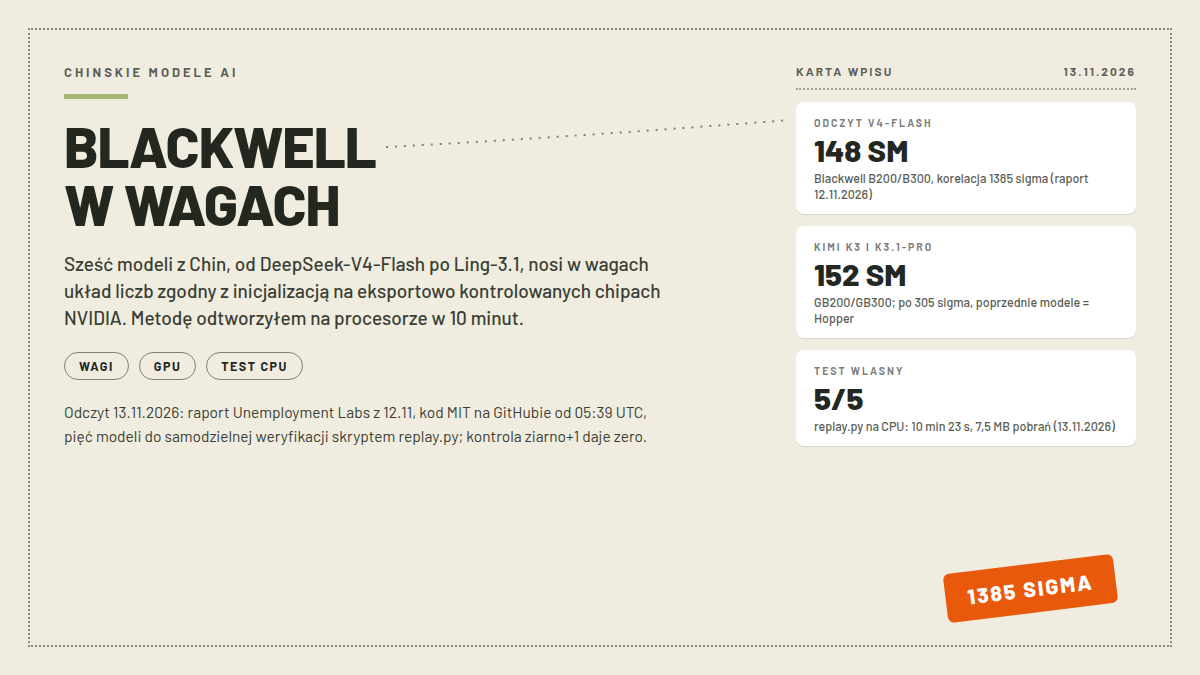
12 listopada na stronie Unemployment Labs wyszedł raport „Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs”. Autor, Will DePue, czyta z publicznie opublikowanych wag sześciu modeli czterech chińskich laboratoriów układ liczb, który powstaje tylko przy inicjalizacji wag na chipach NVIDIA z generacji Blackwell. To układy B200, B300, GB200 i GB300, których eksport do Chin wymaga licencji Departamentu Handlu USA. Najmocniejszy odczyt dotyczy DeepSeek-V4-Flash: korelacja na poziomie 1385 sigma, przy progu przypadkowego trafienia rzędu 8 sigma.
Metoda jest na tyle tania, że weryfikacja mieści się na zwykłym komputerze: odtworzyłem ją na procesorze biurkowym w 10 minut i 23 sekundy, pobierając 7,5 MB danych. W tym tekście pokazuję, jak odcisk palca GPU działa, jak wygląda pełny łańcuch dowodu i gdzie się kończy. Raport wykrywa inicjalizację, nie trening, i wprost zaznacza, że nie rozstrzyga, czy jakiekolwiek prawo zostało złamane. Cztery laboratoria opisujemy w hubie chińskich modeli AI, a ta sprawa dokłada do ich opisu warstwę sprzętową.
- Najważniejsze informacje
- Jak z wag modelu można odczytać sprzęt
- Dowód: replikacja na trzech GPU i kontrola ujemna
- Skala: około 12 tysięcy Blackwellów
- Odtworzyłem metodę na własnym komputerze
- Czego ten dowód nie mówi
- Co z tego dla Polski
- Najczęstsze pytania
Najważniejsze informacje
| Model | Premiera | Odczytany chip (siła dowodu) |
|---|---|---|
| DeepSeek-V4-Flash | kwiecień 2026 | Blackwell B200/B300 (1385 sigma) |
| DeepSeek-V4-Pro | kwiecień 2026 | Blackwell GB200/GB300 (49 sigma) |
| Kimi K3 | lipiec 2026 | Blackwell GB200/GB300 (305 sigma) |
| Kimi K3.1-Pro | listopad 2026 | Blackwell GB200/GB300 (305 sigma) |
| MiniMax-M3 | czerwiec 2026 | Blackwell B200/B300 (323 sigma) |
| Ling-3.1-flash | październik 2026 | Blackwell GB200/GB300 (244 sigma) |
Poprzednie modele tych samych firm czytają się jako starszy Hopper. DeepSeek-V3 z grudnia 2024 i Kimi K2.5 ze stycznia 2026 mają układ 132 jednostek SM, czyli H100, H200 albo H800, i obie firmy deklarowały H800 w kartach modeli. MiniMax-M2.7 z kwietnia 2026 i Ling-3.0-flash z sierpnia 2026 też czytają się jako Hopper. Przełączenie na układ 148 albo 152 jednostki następuje między kolejnymi wydaniami: u DeepSeeka między grudniem 2024 a kwietniem 2026, u Moonshot między styczniem a lipcem 2026, u MiniMaxa między kwietniem a czerwcem 2026, u Ant Group między sierpniem a październikiem 2026.
Jak z wag modelu można odczytać sprzęt
PyTorch przy tworzeniu macierzy wag na GPU losuje wartości generatorem Philox i uruchamia 2048 wątków na każdą jednostkę SM. Wątek t dostaje swój ciąg liczb, a element o numerze i trafia do wątku „i modulo G”, gdzie G to 2048 razy liczba jednostek SM. To samo ziarno losowości daje dokładnie te same liczby na każdym GPU NVIDII, ale rozkłada je po macierzy inaczej, zależnie od liczby jednostek. H100, H200 i H800 mają 132 SM, czyli 270 336 wątków; B200 i B300 mają 148 SM, czyli 303 104 wątki; GB200 i GB300 mają 152 SM, czyli 311 296 wątków. Przy złym założeniu o sprzęcie dostajemy, jak pisze autor raportu, „the right numbers in the wrong positions”: właściwe liczby w niewłaściwych pozycjach.
Drugi element układanki to wiersze macierzy embeddingu dla tokenów, które nigdy nie pojawiają się w danych treningowych. Nie dostają gradientu, więc zachowują pierwotne wartości z inicjalizacji. Autor przeszukał wszystkie 4,29 mld możliwych ziaren (pełna przestrzeń 32-bitowa) i dla każdego z sześciu modeli znalazł to właściwe, po czym przeliczył korelację dla układów od 16 do 256 jednostek SM. Trafienie daje korelację powyżej 0,9999.
Na marginesie: znalezione ziarna wyglądają na wybierane przez ludzi, nie losowo. DeepSeek użył tego samego ziarna w V3 z grudnia 2024 i w V4-Flash z kwietnia 2026 (953049583), Kimi ma 20256586, a MiniMax i Ling kilkucyfrowe 2760 i 3952.
Dowód: replikacja na trzech GPU i kontrola ujemna
Najmocniejszy element raportu to replikacja fizyczna. Na H100 niezmodyfikowany PyTorch odtworzył wszystkie 57 344 zachowane wartości startowe DeepSeek-V3, bit po bicie, a przy V4-Flash dał 0 z 469 wybranych wierszy. B300 zachowuje się lustrzanie: 461 z 469 wierszy V4-Flash, z tego 445 całych wierszy zgodnych co do bitu, i 0 z 8 przy V3. Na wynajętym GB200 PyTorch odtworzył 13 z 13 wierszy Kimi K3. Podniesienie ziarna o jeden kasuje wszystkie dopasowania.
Metoda zgadza się też z 24 przypadkami, w których deweloperzy sami ogłosili sprzęt, na którym powstał model (Llama 3.1 czyta się jako H100, Pythia jako A100). AMD dało się wykluczyć dla najsilniejszego odczytu: MI300X skonfigurowany na 148 albo 152 jednostki mógłby teoretycznie dać podobny układ, ale spośród 377 rozbieżnych wartości w V4-Flash 363 zgadza się z wyjściem NVIDII i żadna z AMD.
Najsłabszy pojedynczy test w całym zestawie ma 20 sigma. Dla skali: przy 5 sigma przypadkowe trafienie zdarza się mniej więcej raz na 3,5 mln porównań, a autor przyjął 8 sigma jako próg uznania odczytu.
Ciekawy przypadek graniczny to Kimi K2.7-Code, opublikowany sześć tygodni przed K3. Model zbudowano na wagach z ery Hoppera, ale zawiera niewielki fragment zgodny z B200 albo B300: 254 wiersze, 246 sigma po odjęciu części Hopper. Wygląda to na ślad migracji klastra w trakcie pracy.
Skala: około 12 tysięcy Blackwellów
Z liczby operacji treningowych i wydajności jednego chipa raport szacuje rozmiary klastrów. Największe przebiegi to Kimi K3 na około 4 500 Blackwellów i DeepSeek-V4-Pro na około 3 000, co daje równowartość około 11 500 i 7 500 kart H100. Wszystkie pięć odczytanych przebiegów razem to około 12 000 chipów, przy przedziale niepewności od 7 000 do 22 000. Najdłuższy przebieg, Ling-3.1-flash, trwał około 100 dni.
Cenę autor wyprowadza z raportu Wall Street Journal, cytowanego przez Reutersa, o instalacji 36 tys. chipów Blackwell w Malezji na użytek ByteDance za ponad 2,5 mld USD: wychodzi około 70 tys. USD za sztukę. Największy z opisanych klastrów to zatem 200-300 mln USD, a pięć razem ponad pół miliarda. To wyłącznie finalne przebiegi treningowe; łączne wydatki tych firm na kontrolowane chipy autor ocenia jako prawdopodobnie wielomiliardowe.
Wersja raportu z rana 12 listopada podawała niższe liczby (2 000-3 000 GPU i 150-200 mln USD); jeszcze tego samego dnia autor je podniósł, tłumacząc, że pierwotne założenia były zbyt optymistyczne co do efektywności chipów.
Odtworzyłem metodę na własnym komputerze
Kod przeszedł z raportem z jednym dniem opóźnienia: repozytorium checkpoint-forensics na GitHubie (licencja MIT) powstało 13 listopada o 05:39 UTC. Skrypt replay.py działa na samym procesorze. Ściąga tylko wybrane, nieprzetrenowane wiersze embeddingu prosto z Hugging Face przez range requesty, sprawdza ich sumę sha256, generuje te wiersze od zera z ziarna dla każdego układu SM od 16 do 256 i wypisuje trafienie.
Wymagania to Python z numpy i scipy, nic więcej. U mnie (12 rdzeni, bez żadnego GPU) pełny przebieg dla pięciu modeli zajął 10 minut i 23 sekundy, pobrał około 7,5 MB i zużył w szczycie 335 MB RAM.
| Model | Układ SM | Dopasowanie (mediana korelacji) |
|---|---|---|
| DeepSeek-V3-Base | 132 | 8 z 8 wierszy (0,999999) |
| DeepSeek-V4-Flash | 148 | 461 z 469 wierszy (0,999999) |
| Kimi K3 | 152 | 13 z 13 wierszy (0,999996) |
| MiniMax-M3 | 148 | 17 z 17 wierszy (0,999990) |
| Ling-3.1-flash-base | 152 | 384 z 384 wierszy (0,983436) |
Kontrola ujemna wychodzi czysto: ziarno zwiększone o jeden daje korelacje bliskie zeru (najwyższa 0,0042), a drugi najlepszy układ SM nie przekracza 0,025. Wszystkie liczby pokrywają się z README repozytorium do ostatniego miejsca po przecinku. Osiem wierszy z wybranych w V4-Flash zostało częściowo przetrenowanych, stąd 461 zamiast pełnej setki. Dla porównania: wagi samego K3.1 Pro, o których pisaliśmy przy premierze wag Kimi, ważą 1,56 TB, a do odczytu fingerprintu wystarczyło kilkanaście wierszy embeddingu.
Czego ten dowód nie mówi
Raport sam rozdziela fakty od wniosku. „The fingerprint identifies how the weights were created and supports, without proving, the inference that Blackwell also performed the training”: odcisk palca identyfikuje, jak powstały wagi, i wspiera bez dowodzenia wniosek, że trening też szedł na Blackwellach. Wagi nie mówią, gdzie chipy leżały, kto był ich właścicielem ani jak zdobyto dostęp. Flagi w tabeli opisują klasę sprzętu według amerykańskich reguł eksportowych, a jak przypomina autor, „they are not a finding that any law was broken”.
Chip mógł po prostu stać poza Chinami. Chińskie firmy wynajmują moce w Singapurze i Malezji, i taki trening jest legalny; skalę tego ruchu widać po cytowanym w raporcie przypadku ByteDance i Malezji. Komentujący na Hacker News wskazywali tę możliwość jako pierwszą interpretację, zanim padnie słowo o przemycie.
Jest i wątek zaprzeczenia. 12 czerwca 2025 inżynier DeepSeeka napisał w pull requeście projektu DeepGEMM (nr 112): „we don’t have SM100 GPUs” (SM100 to właśnie Blackwell). Fingerprint V4-Flash, inicjalizowanego w kwietniu 2026, stoi z tym zdaniem w sprzeczności. Z drugiej strony, jak podkreśla w dyskusji użytkownik nullc, DeepSeek opublikował niedawno własny silnik inferencji z kernelami wyłącznie dla SM100 i Huawei Ascend 950, więc korzystanie z Blackwellów nie jest po stronie firmy żadną tajemnicą. Inicjalizacja z kwietnia 2026 uzupełnia ten obraz, nie obala go.
W dyskusji na Hacker News padł też zarzut angażu politycznego wobec autora, który wcześniej pracował w OpenAI; inni komentujący odpierali, że raport publikuje metodykę i kod do samodzielnej weryfikacji. Osobne zastrzeżenie techniczne: cała metoda stoi na zachowaniu PyTorcha i jego generatora CUDA, co w wątku wskazywał użytkownik liuliu. Ramy działania są wąskie: metoda nie zadziała na wagach zamkniętych, na PaddlePaddle (ziarno ERNIE-5.5 udało się znaleźć, sprzęt już nie), na inicjalizacji na CPU (Qwen3-235B, Qwen3-32B i Qwen3.5-9B) i po prostu nie wykryła sygnatury mimo wyczerpującego przeszukania dla DeepSeek-V4.1-Flash, Qwen3.5-122B, Qwen3.8-Flash-Next, Qwen3-0.6B i 1.7B, gpt-oss-120b oraz Grok-1. LongCat-2.0 Meituana deklaruje w karcie modelu trening „entirely on AI ASIC superpods” i też nie ma sygnatury NVIDII.
Co z tego dla Polski
Google News po frazach łączących Blackwella i fingerprint nie ma dziś ani jednej polskiej notki (odczyt 13 listopada), a podpowiedzi Google dla rodziny „deepseek blackwell” żyją w formie głównie angielskiej. Embargo to instrument prawa USA (wymóg licencji przy eksporcie do Chin, cytowany w raporcie paragraf 15 CFR 742.6) i polskich firm bezpośrednio nie wiąże. Dotyka za to rynku, z którego korzystamy na co dzień: od sprzętu, na którym trenuje się DeepSeek i Kimi, zależą możliwości i ceny ich API, a oba łapiemy w omówieniu rodziny DeepSeek V4 i wymaganiach sprzętowych K3. Publicznej odpowiedzi żadnego z czterech laboratoriów nie znam; gdy się pojawi, dopiszę ją tutaj.
Najczęstsze pytania
Czy DeepSeek trenował na chipach NVIDIA Blackwell?
Raport tego nie dowodzi. Wykrywa inicjalizację wag na Blackwellach (1385 sigma dla DeepSeek-V4-Flash), co wspiera wniosek o treningu na tym samym sprzęcie, ale wagi nie zapisują, gdzie chipy leżały ani co po inicjalizacji. DeepSeek nie opublikował stanowiska w sprawie raportu (stan na 13 listopada).
Które chińskie modele mają w wagach ślad Blackwella?
Sześć modeli z czterech firm: DeepSeek-V4-Flash (B200/B300), DeepSeek-V4-Pro (GB200/GB300), Kimi K3 i Kimi K3.1-Pro (GB200/GB300), MiniMax-M3 (B200/B300) oraz Ling-3.1-flash (GB200/GB300). Poprzednie wydania tych samych rodzin czytają się jako starszy Hopper.
Czy chińskie firmy łamią embargo na chipy?
Nie wiadomo. Eksport chipów Blackwell do Chin wymaga licencji USA, ale raport nie stwierdza naruszenia: nie ustala lokalizacji chipów, właściciela ani sposobu dostępu. Trening na chipach wynajętych w Singapurze albo Malezji jest legalny.
Jak sprawdzić fingerprint modelu na własnym komputerze?
Skrypt replay.py z repozytorium checkpoint-forensics na GitHubie. Potrzebny Python z numpy i scipy, GPU nie jest wymagany: pięć modeli sprawdziłem na procesorze w 10 minut przy 7,5 MB pobrań. Metoda działa tylko dla opublikowanych wag i modeli trenowanych w PyTorchu na sprzęcie NVIDIA.
Źródła
- Raport „Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs” (Will DePue, Unemployment Labs, 12.11.2026, rewizja tego samego dnia)
- Kod checkpoint-forensics na GitHubie (licencja MIT, utworzony 13.11.2026 o 05:39 UTC)
- DeepGEMM, pull request nr 112 (komentarz inżyniera DeepSeeka, 12.06.2025)
- cuLA, BENCHMARK_GB300.md (Ant Group, wyniki z GB300 z 31.03.2026)
- Hugging Face: deepseek-ai/DeepSeek-V4-Flash (rewizja 60d8d70, wiersze embeddingu pobrane w teście 13.11.2026)
- Dyskusja na Hacker News (319 punktów, 120 komentarzy, odczyt 13.11.2026)
- Google News RSS PL (odczyt 13.11.2026: frazy „deepseek blackwell”, „blackwell chiny” bez polskich notek)