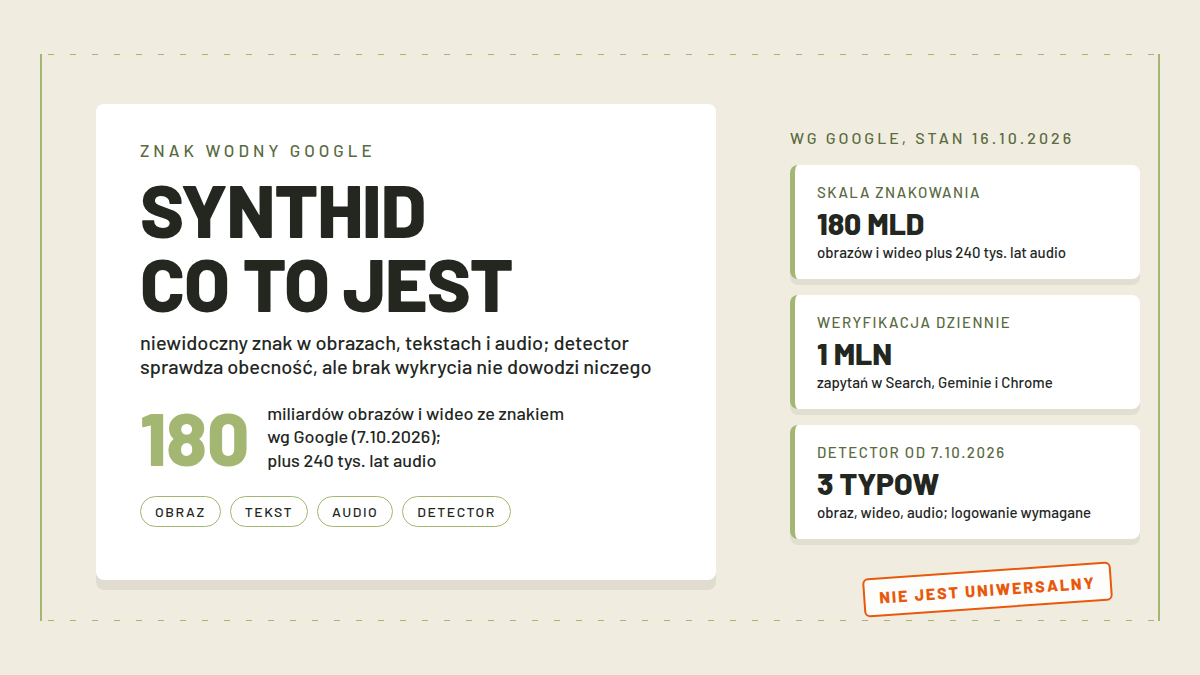
Znak wodny kojarzy się z napisem w rogu zdjęcia albo półprzezroczystym logo nałożonym na wideo. SynthID działa inaczej. To niewidoczna warstwa, którą modele Google doklejają do treści w momencie jej powstawania: do pikseli obrazu i wideo, do częstotliwości dźwięku, do doboru słów w tekście. Znaku nie widać, nie słychać go i nie obniża jakości, a mimo to można go później sprawdzić. Według danych Google z 7 października 2026 technologia oznaczyła do tego dnia ponad 180 miliardów obrazów i wideo oraz 240 tysięcy lat materiału audio.
Ten sam dzień przyniósł coś praktycznego. SynthID Detector, portal pod adresem synthid.com, dotąd zarezerwowany dla dziennikarzy i profesjonalistów mediowych, otwarto dla wszystkich, globalnie po angielsku. Wgrywasz plik, dostajesz odpowiedź, czy znak jest. Brzmi jak gotowy wykrywacz deepfake’ów, a nim nie jest. Detector obsługuje wyłącznie treści z modeli Google i firm, które przyjęły SynthID, nie czyta tekstów i wymaga logowania. Poniżej rozpisałem, jak SynthID działa w obrazach, tekście, wideo i audio, kto go przyjął i w których miejscach detekcja zawodzi, bo w tych miejscach zawodzi nieźle.
- Czym jest SynthID i jak działa
- Co potrafi SynthID Detector, a czego nie
- Kto przyjął znak wodny
- Kiedy SynthID zawodzi
- Co to znaczy w Polsce
- Najczęstsze pytania
| Najważniejsze informacje | Stan na 16.10.2026 |
|---|---|
| Co to jest | Niewidoczny znak wodny doklejany przez modele w chwili tworzenia treści (obraz, wideo, audio, tekst) |
| Skala | Ponad 180 mld obrazów i wideo oraz 240 tys. lat audio (dane Google z 7.10.2026) |
| SynthID Detector | Portal synthid.com, dla wszystkich od 7.10.2026, obsługuje obraz, wideo i audio, wymaga logowania |
| Partnerzy | Google, OpenAI, NVIDIA, Kakao, zapowiadane Apple |
| Główny limit | Wykrywa tylko treści z modeli, które przyjęły SynthID; brak wykrycia nie dowodzi, że treść nie jest z AI |
| Słabości | Edycja, parafraza, tłumaczenie i agresywne przekształcenia osłabiają albo zbijają sygnał |
Czym jest SynthID i jak działa
Zamiast zapisywać informację o pochodzeniu w metadanych pliku, które giną przy pierwszym lepszym uploadzie i przekonwertowaniu, Google wsuwa sygnał w samą treść. W obrazach robi to sieć neuronowa, która przy generacji dodaje do pikseli wzorzec niewidoczny dla oka. Producent deklaruje, że znak nie psuje jakości i że jest nanoszony w chwili tworzenia obrazu, więc obejmuje też darmową generację w Gemini, w tym modele z rodziny opisywanej jako Nano Banana. Znak ma przetrwać kadrowanie, filtry, zmianę kolorów i zapis z kompresją stratną, czyli to wszystko, co robi z plikiem komunikator albo sieć społecznościowa.
Wideo znakowane jest segmentowo, a detector potrafi wskazać, które fragmenty nagrania niosą sygnał. Audio działa na częstotliwościach: znak ma wytrzymać kompresję MP3, dołożenie szumu i zmianę tempa, a nanoszą go muzyczny model Lyria i funkcja generowania podcastów w NotebookLM. W praktyce oznacza to, że utwór wygenerowany w narzędziach Google nosi sygnał niezależnie od tego, ile razy ktoś go później przekonwertuje, choć granica tej niezależności jest węższa, niż brzmi obietnica.
Tekst to osobna technika i osobna historia. Model językowy dobiera kolejne słowa na podstawie rozkładu prawdopodobieństwa, a SynthID Text delikatnie kształtuje ten rozkład w trakcie generacji. DeepMind tłumaczy to na przykładzie zdania o ulubionych owocach: po „mango i” słowo „banany” ma wyższe prawdopodobieństwo niż „samoloty”, a znak powstaje właśnie z takich przechyleń, pojedynczo niezauważalnych. Metoda nie wymaga dostrajania modelu i nie zmienia jego wyników na benchmarkach, co potwierdził eksperyment na prawie 20 mln odpowiedzi Geminy opisany w czasopiśmie Nature w października 2024. To pierwsze produkcyjne wdrożenie generatywnego znakowania tekstu w modelu językowym, a Google udostępnił potem technologię open source: implementacja siedzi w bibliotece Hugging Face Transformers od wersji 4.46.0, więc każdy operator modelu może nanosić własny znak tej samej rodziny.
SynthID Text znakuje odpowiedzi aplikacji i wersji przeglądarkowej Geminy. Przy treściach mieszanych, gdzie obraz, dźwięk i tekst powstają w jednym modelu, znaki trafiają do każdej modalności z osobna, o czym szerzej pisałem przy okazji tekstu o modelach multimodalnych. Weryfikacja nie zawsze wymaga portalu: obraz albo wideo można wgrać do czatu z Geminą i zapytać, czy powstało w narzędziach Google. Podobne sprawdzenie ma wbudowane Search i Chrome, a te trzy drogi obsługują według Google regularnie ponad milion zapytań dziennie.
Co potrafi SynthID Detector, a czego nie
Portal ogłoszono 20 maja 2025 na konferencji I/O, wtedy jeszcze z listą oczekujących dla dziennikarzy i badaczy. Pełne otwarcie przyszło 7 października 2026. Detector przyjmuje trzy typy treści: obrazy, wideo i audio, w formatach od JPG i PNG przez WEBP i AVIF po MP4, MOV, WEBM, WAV, MP3, FLAC i AAC. W zapowiedzi z 2025 mowa była też o skanowaniu tekstu, ale aktualny portal, odczytany 16.10.2026, obsługuje trzy typy i tekstu nie dotyczy. Wynik jest dwustanowy: „znak wykryty” albo „znak niewykryty”, z podświetleniem segmentów wideo i audio najbardziej prawdopodobnych z sygnałem.
Trzy rzeczy trzeba wiedzieć, zanim z niego skorzystasz. Po pierwsze, wymaga zalogowania; użytkownicy w dniu premiery opisywali logowanie kontem Google, Apple albo ChatGPT, a regulamin usługi mówi wprost o dziennych limitach użycia powiązanych z kontem. Po drugie, regulamin zakazuje atakowania detektora, automatycznego wysyłania zapytań i obchodzenia limitów, więc to narzędzie do pojedynczych kontroli, nie do masowych audytów. Po trzecie, wgrywane pliki są przetwarzane na bieżąco i natychmiast kasowane po zwróceniu wyniku; na 24 godziny zostaje cyfrowy podpis pliku powiązany z kontem, służący do pilnowania limitów.
Sam producent ostrzega przed nadinterpretacją wyniku. „This is not a general AI detector. We can only detect media from the above companies, who have adopted SynthID technology”, czytamy na portalu: to nie jest uniwersalny wykrywacz, tylko sprawdzacz obecności znaku Google i partnerów. Wynik „nie wykryto” nie przesądza, że treść jest ludzka, a Google prosi o wgrywanie plików w najwyższej dostępnej jakości, bo kompresja i edycja zjadają sygnał. Zastrzeżenie przydaje się uczciwie obie strony: w bardzo rzadkich przypadkach detektor może też fałszywie wskazać znak na treści go nieposiadającej. Zaznaczę na swoim miejscu: detectora nie testowałem na własnych plikach, bo wymaga logowania i wgrywania materiałów, więc opisuję go wyłącznie z dokumentacji i relacji z premiery.
Osobną ścieżkę ma OpenAI, które prowadzi własny portal weryfikacji pod adresem openai.com/research/verify, opisany jako narzędzie publiczne i na start ograniczone do treści z narzędzi OpenAI. Ten sprawdza obrazy i audio wygenerowane w ChatGPT, Codexie i przez API, więc przy sprawdzeniu pojedynczego obrazu z ChatGPT bywa najprostszą drogą. Detektory są jednak rozłączne: portal OpenAI szuka sygnałów OpenAI, portal Google szuka SynthID.
Kto przyjął znak wodny
Partnerzy na portalu to Google, NVIDIA, OpenAI i Kakao, a post z października 2026 zapowiada dołączenie Apple. Najgłośniejsza adopcja to OpenAI, firma, która w 2024 zbudowała własny znak dla ChatGPT i nie wdrożyła go z obaw o fałszywe trafienia u osób piszących po angielsku jako w drugim języku oraz o odpływ użytkowników do konkurencji. W maju 2026 kurs się odwrócił: OpenAI przyjęło SynthID dla obrazów generowanych w ChatGPT, Codexie i przez API, w tej samej akcji deklarując zgodność z C2PA, standardem podpisów pochodzenia treści, i udostępniając publiczny podgląd narzędzia weryfikacji. 31 lipca 2026 znak rozszerzono na wspierane audio z ChatGPT i API, a portal weryfikacji zaczął je także przyjmować.
Warstwowa logika jest tu ciekawsza niż sam fakt podpisu. C2PA zapisuje w metadanych, skąd plik przyszło i co mu robiono, a metadane potrafią zniknąć przy uploadzie czy zrzucie ekranu. SynthID ma przetrwać tam, gdzie metadane nie przetrwały. Google dokłada do ekosystemu partnerów od dłuższego czasu: w 2025 znakowanie wideo w serwisach NVIDIA na build.nvidia.com oraz partnerstwo z firmą GetReal Security, weryfikującą media na większą skalę. Anthropic poszedł własną drogą: w sierpniu 2026 zapowiedział znakowanie wszystkich odpowiedzi Claude i API detekcji, które we wrześniu trafiło w podglądzie prywatnym do regulatorów i organów ścigania. Ekosystem rozjeżdża się na osobne systemy znaków, co ma konsekwencję praktyczną: każdy detektor czyta tylko swoje.
Kiedy SynthID zawodzi
Pierwsza kategoria porażek nie jest nawet awarią. Treści z modeli, które nie przyjęły SynthID, z natury nie mają znaku: lokalnie uruchomione modele z otwartymi wagami, jak opisywany ostatnio Muse Spark, przechodzą obok infrastruktury Google i OpenAI, więc ich wyniki nie noszą żadnego sygnału. Do tego dochodzi starsza generacja modeli sprzed adopcji i zwykła fotografia. Wynik „znak niewykryty” mówi więc tylko tyle, że detektor nie znalazł sygnału, i nic ponad to.
Druga kategoria to edycja. Przy tekście dokumentacja Google przyznaje wprost, że pewność detektora mocno spada po gruntownym przepisaniu albo przetłumaczeniu na inny język, a paper z Nature odnotowuje, że znaki generatywne osłabia edycja tekstu, w tym parafraza z użyciem modelu. Najbardziej miarodajne liczby podał OpenAI przy okazji wprowadzania własnego znaku tekstowego textGrain: przy pasmach 400 tokenów zamiana 10 procent słów na synonimy obniżała skuteczność detekcji z około 92 do 66 procent, a zamiana jednego słowa na cztery, czyli 25 procent, zbiła ją do 17 procent. Do tego teksty krótkie i tematy sztywne, jak matematyka, detektor łapie wyraźnie gorzej niż swobodne wywody. Wniosek dla praktyka: sprawdzacz tekstu po deklaracji „napisane przez AI?” oparty wyłącznie na znaku jest zawodny już na poziomie lekkiej redakcji.
Obrazy bronią się lepiej, ale i tu badacze pokazali pęknięcia. Projekt reverse-SynthID, opublikowany na GitHubie i przedyskutowany na Hacker News w kwietniu 2026, zrekonstruował znak obrazowy Geminy samą analizą widmową, bez dostępu do kodu Google. Autor raportuje własny detektor znaku o skuteczności 90 procent, zależność położenia nośnych od rozdzielczości obrazu i wieloetapowy zestaw przekształceń, który po jego deklaracji zdejmuje detekcję w aplikacji Gemini dla obrazów z dwóch modeli. To praca jednego badacza, nie recenzowana publikacja, więc traktuję liczby ostrożnie, ale kierunek potwierdza sam Google: pomoc aplikacji Gemini wymienia kolaże, nakładki i bogate tekstury jako sytuacje, w których detektor może mieć kłopot z wyodrębnieniem sygnatury, a każda generatywna edycja fragmentu kadru, jaką robią narzędzia pokroju Krea 3, to kolejne przekształcenie, z którym sygnał musi się zmierzyć. Fraza „synthid remover” z podpowiedzi wyszukiwarki opisuje więc realne zjawisko: agresywne przetworzenie pliku potrafi zbić detekcję. Nie ma jednak powodu wierzyć na słowo narzędziom, które obiecują „usunięcie znaku” w jednym kliknięciu, a ponadto brak wykrycia po przeróbce nie czyni z pliku dowodu autentyczności, wręcz przeciwnie.
Trzecia kategoria to chwiejność narzędzi w praktyce. Redakcja The Intercept sprawdzała w styczniu 2026 zdjęcie opublikowane przez konto Białego Domu, na którym przerobiono wygląd zatrzymanej aktywistki. Trzy kolejne zapytania do Geminy o ten sam plik dały trzy sprzeczne odpowiedzi: najpierw detekcja manipulacji narzędziami Google, potem ocena „autentyczne zdjęcie”, wreszcie „nie wykonano w Google AI”. Google nie odtworzyło pierwszego wyniku. Dobry uczynek z tej historii jest jeden: wynik detektora to jeden punkt danych, nie wyrok, i dokładnie tak zaleca go traktować strona portalu.
Co to znaczy w Polsce
Regulacyjnie robi się to obowiązkowe. „The EU AI Act requires generative AI providers to make generated text identifiable in a machine-readable way”, pisze OpenAI przy okazji uruchamiania znakowania tekstu dla UE 5 października 2026: ustawa o AI wymaga od dostawców modeli generatywnych, by treści tekstowe dało się zidentyfikować w sposób czytelny dla maszyny. W praktyce teksty z ChatGPT i Codexa w Unii dostaną niewidoczny znak w kolejnych tygodniach od tej daty, klienci API mogą znakowanie włączyć na całym świecie, a detektor tekstu OpenAI na start dostaną tylko zatwierdzeni badacze. Odpowiedzi z Geminy znakowane są już dziś, bo SynthID Text działa tam globalnie.
Dla zwykłego użytkownika z Polski spis praktyki jest krótki. Pojedyncze zdjęcie z narzędzi Google sprawdzisz, wgrywając je do czatu z Geminą i pytając wprost, albo przez portal synthid.com, jeśli masz konto i plik w dobrej jakości. Pojedynczy obraz z ChatGPT sprawdzi portal openai.com/research/verify. Przy ocenie obcego materiału, na przykład viralowego zdjęcia, znak to jedno ze źródeł obok metadanych, C2PA, odwrotnego wyszukiwania i zwykłego sprawdzenia kontekstu; pełny zestaw takich metod rozpisałem w tekście o sprawdzaniu, czy zdjęcie jest z AI, tu celowo zostaję przy samej warstwie znaku wodnego. I ostatnia rzecz, którą podpowiada cała powyższa lista porażek: brak wykrytego znaku nigdy nie jest dowodem, że treść jest ludzka, a wykryty znak nie mówi, ile człowieka siedzi w finalnej wersji.
Najczęstsze pytania
Czy SynthID Detector sprawdza też teksty?
Nie. Portal od otwarcia w październiku 2026 obsługuje obrazy, wideo i audio, a zapowiadane w 2025 skanowanie tekstu w praktyce nie wystartowało. Publicznego sposobu na sprawdzenie znaku w tekście na ten moment nie ma: detektor znaku tekstowego OpenAI jest na start dostępny tylko zatwierdzonym badaczom, a Google nie udostępnia otwartego sprawdzania SynthID Text.
Czy brak wykrytego znaku dowodzi, że treść nie jest z AI?
Nie dowodzi. Znaku nie mają treści z modeli bez SynthID, w tym lokalnie uruchomionych modeli z otwartymi wagami, treści sprzed adopcji i zwykłe zdjęcia, a mocna kompresja albo edycja potrafi zgasić sygnał. W drugą stronę też bywa: w rzadkich przypadkach detektor wskazuje znak na treści go nieposiadającej.
Czy da się usunąć znak SynthID, o którym piszą narzędzia typu synthid remover?
Badania pokazują, że sygnał da się osłabić i w skrajnych przypadach zdjąć detekcję, i sam Google przyznaje, że żaden znak nie jest w pełni odporny. Nie testuję i nie opisuję konkretnych narzędzi do tego, a rozsądny wniosek jest inny: plik po przeróbce pod kątem omijania detekcji traci status dowodu, nie zyskuje.
Jak najszybciej sprawdzić pojedyncze zdjęcie z Geminy?
Wgraj je do czatu z Geminą i zapytaj, czy powstało albo było edytowane w narzędziach Google. To ścieżka wskazywana w dokumentacji DeepMind i nie wymaga osobnego portalu. Portal synthid.com daje dodatkowo podświetlenie obszarów najbardziej prawdopodobnych z znakiem.
Czy SynthID jest obowiązkowy z mocy prawa?
Nie sam znak, ale oznaczanie treści generowanych przez AI jest obowiązkiem z EU AI Act po stronie dostawców modeli, i SynthID jest jedną z dróg jego spełnienia. OpenAI wdraża znakowanie tekstów w UE od października 2026 właśnie pod tę ustawę, a Google znakuje swoje wyjścia od premiery technologii w 2023 roku.
Źródła
- SynthID Detector, portal i FAQ (formaty plików, typy treści, wyniki, regulamin), odczyt: https://synthid.com/
- Pushmeet Kohli, We’re making it easier to identify AI-generated content globally, blog.google, 7.10.2026, odczyt: https://blog.google/innovation-and-ai/models-and-research/google-deepmind/synth-id-ai-content/
- Google SynthID, strona produktu DeepMind (działanie na obrazie, audio, tekście, weryfikacja w Geminie), odczyt: https://deepmind.google/models/synthid/
- SynthID Detector, ogłoszenie na I/O 2025, blog.google, 20.5.2025, odczyt: https://blog.google/technology/ai/google-synthid-ai-content-detector/
- Scalable watermarking for identifying large language model outputs, Nature, 23.10.2024, odczyt: https://www.nature.com/articles/s41586-024-08025-4
- SynthID-Image: Image watermarking at internet scale, arXiv, 10.10.2025, odczyt: https://arxiv.org/abs/2510.09263
- SynthID Text, dokumentacja dla deweloperów Google (open source, ograniczenia), odczyt: https://ai.google.dev/responsible/docs/safeguards/synthid
- Advancing content provenance for a safer, more transparent AI ecosystem, OpenAI (adopcja SynthID, update audio 31.7.2026), odczyt: https://openai.com/index/advancing-content-provenance/
- Our approach to EU text provenance rules, OpenAI, 5.10.2026, odczyt: https://openai.com/index/eu-text-provenance/
- Reverse-Engineering SynthID, repozytorium badawcze aloshdenny, odczyt: https://github.com/aloshdenny/reverse-SynthID
- Google’s AI Detection Tool Can’t Decide If Its Own AI Doctored Photo of Activist, The Intercept, 24.1.2026, odczyt: https://theintercept.com/2026/01/24/googles-ai-detection-white-house-synthid-gemini/
- AI watermarking, Wikipedia EN (historia, adopcje, Anthropic), odczyt: https://en.wikipedia.org/wiki/AI_watermarking
- Dyskusja pod premierą SynthID Detector, Hacker News, 7.10.2026, odczyt: https://news.ycombinator.com/item?id=49993188