Wyjaśnienie sztucznej inteligencji od czasu do czasu warto zacząć od czegoś, czego w interfejsie ChatGPT w ogóle nie zobaczysz. Temperatura to parametr, o którym najgłośniej jest w dokumentacji dla programistów, bo tam faktycznie się go ustawia: decyduje o tym, jak śmiało model dobiera kolejne słowa w trakcie pisania odpowiedzi. Przy niskiej wartości trzyma się najbezpieczniejszych wyborów, przy wysokiej pozwala sobie na dalsze zakątki słownika. To kolejna część cyklu Podstawy AI: opisuję mechanizm od środka, porównuję ustawienia trzech dużych dostawców i tłumaczę, czemu dwie rozmowy uruchomione tym samym poleceniem kończą się różnymi tekstami. Wszystko poniżej pochodzi z dokumentacji producentów i opublikowanych badań, bo nie robię tu własnych testów modeli i nie będę zmyślał zachowań, których nie sprawdziłem.
- Co to jest temperatura w modelach AI?
- Co zmienia niska, a co wysoka temperatura?
- Top_p: drugi suwak obok temperatury
- Gdzie ustawia się temperaturę, a gdzie jej nie ma?
- Czemu to samo polecenie daje różne odpowiedzi (i czy temperatura powoduje halucynacje)?
- Najważniejsze informacje
- Najczęstsze pytania
Co to jest temperatura w modelach AI?
Model językowy nie skleja zdań z gotowych fraz. Pisze je kawałek po kawałku, dobierając kolejne tokeny, czyli fragmenty słów, na które rozbija tekst (mechanizm opisywałem osobno w tekście Co to jest token AI). Przy każdym takim kroku model liczy dla całego swojego słownika listę prawdopodobieństw: które fragmenty najpewniej pasują do zdania uruchomionego w tym miejscu. IBM w swoim omówieniu opisuje to tak, że każdemu tokenowi przypisywana jest wartość numeryczna, a cały zbiór normalizowany jest do rozkładu prawdopodobieństwa softmax, w którym sumuje się on do jedności. O tym, jak z tej listy powstaje pełna odpowiedź, pisałem szerzej w tekście Jak działa ChatGPT.
Temperatura to pokrętło regulujące ten rozkład. W dokumentacji OpenAI parametr jest opisany wprost: wartości rzędu 0,8 powodują bardziej losowe wyniki, a wartości rzędu 0,2 bardziej skupione i deterministyczne. IBM formułuje to samo od strony mechanizmu: niższa temperatura czyni tokeny o najwyższym prawdopodobieństwie częściej wybieranymi, a wyższa zwiększa szansę, że model sięgnie po tokeny mniej prawdopodobne. Wikipedia w haśle o funkcji softmax sumuje to jednym zdaniem: wyższa temperatura daje bardziej równomierny rozkład wyniku, czyli „bardziej losowy”, a niższa rozkład ostrzejszy, w którym jedna wartość zwykle dominuje.
Temperatura nie dorabia modelowi wiedzy ani inteligencji. Zmienia wyłącznie sposób losowania z tej samej listy kandydatów, którą model i tak ułożył dla każdego miejsca w zdaniu. Ten sam model, ta sama wiedza, ta sama instrukcja, tylko inna skłonność do ryzyka przy wyborze słów. Dlatego w dokumentacji mówi się o losowości generowania w czasie odpowiedzi, a nie o „mądrości” albo „wyobraźni” wbudowanej w model.
Co zmienia niska, a co wysoka temperatura?
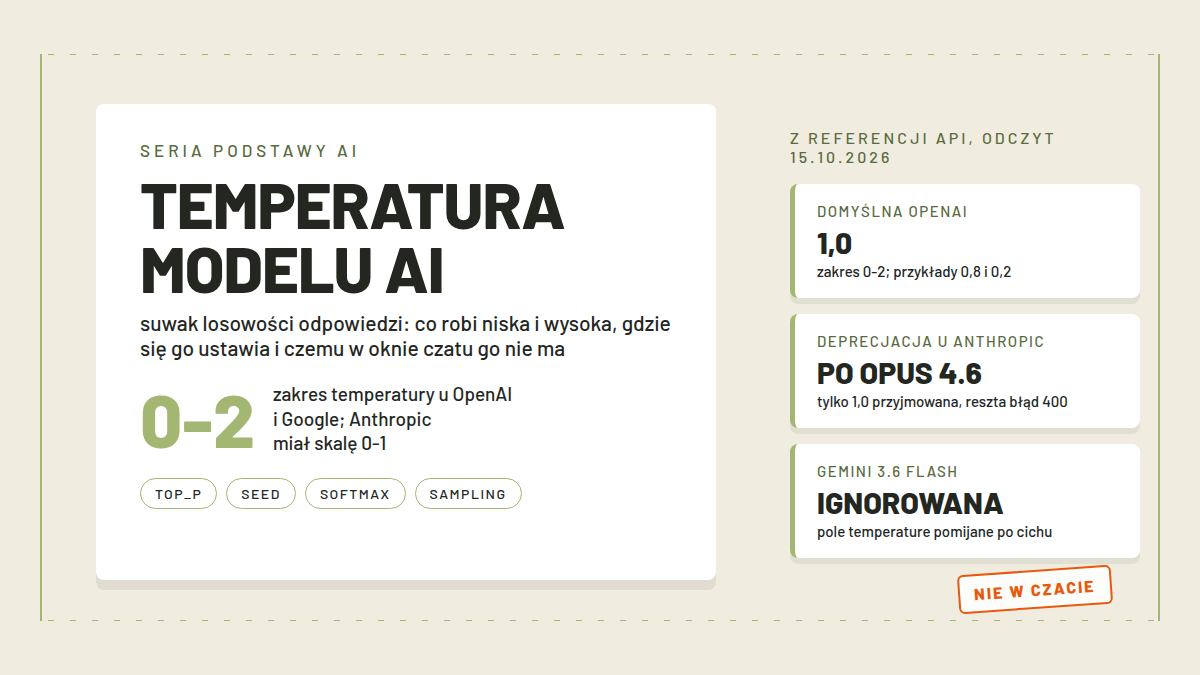
Dostawcy zgadzają się co do kierunku, różnią się detalami. Anthropic w referencji Messages API podaje zakres od 0,0 do 1,0 z wartością domyślną 1,0 i radzi ustawiać temperaturę bliżej zera dla zadań analitycznych i wyborów z opcji, a bliżej jedynki dla zadań twórczych i generatywnych. OpenAI dopuszcza zakres od 0 do 2, też z domyślną 1. Google w konfiguracji generowania Gemini podaje zakres od 0,0 do 2,0, przy czym domyślna wartość zależy od konkretnego modelu. Meta Llama uruchamiana w Amazon Bedrock ma zakres od 0 do 1 z domyślną 0,5. Ta sama liczba znaczy więc co innego u każdego dostawcy: 0,5 u Lammy to środek skali, a u OpenAI czwarta część drogi w dół.
Z zastosowań jest mniej tajemnic. IBM pisze wprost, że niska temperatura sprawdza się tam, gdzie potrzebna jest precyzja i zgodność z faktami, na przykład w dokumentacji technicznej czy odpowiedziach asystentów, bo pomaga modelowi trzymać spójny i zgodny tekst. Wysoka temperatura jest lepsza dla zadań twórczych: pisania kreatywnego czy burzy mózgów nad pomysłami. To zgodne z tym, co podpowiada intuicja: im ważniejsza jest zgodność z faktami, tym mniejsza skłonność do eksperymentów słowem.
Osobnym przypadkiem jest temperatura 0. W teorii oznacza ona rezygnację z losowania: zawsze wybierany jest token z czołówki rozkładu, co brzmi jak obietnica powtarzalnych wyników. Dokumentacje korygują tę intuicję. Anthropic pisze wprost, że nawet przy temperaturze 0,0 wyniki nie będą w pełni deterministyczne. OpenAI oferuje osobny parametr seed, przy którym system podejmuje „najlepszą próbę” deterministycznego losowania i powtarzalności, ale zastrzega, że determinizm nie jest gwarantowany. Jeśli ktoś obiecuje, że temperatura 0 daje zawsze identyczną odpowiedź, obiecuje więcej niż dokumentacja.
Top_p: drugi suwak obok temperatury
Obok temperatury w referencjach API prawie zawsze stoi parametr top_p, nazywany próbkowaniem jądrowym albo nucleus sampling. Mechanizm wygląda inaczej niż przy temperaturze: zamiast skalować rozkład, odcina się jego ogon. OpenAI w referencji podaje przykład: top_p 0,1 oznacza, że brane pod uwagę są wyłącznie tokeny tworzące górne 10% masy prawdopodobieństwa. IBM opisuje to od drugiej strony: model dobiera grupę tokenów, których łączne prawdopodobieństwo przekracza ustalony próg, na przykład 95%. Im niższa wartość, tym węższy krąg kandydatów i tym mniej miejsca na słowne ekscesy.
Oba parametry działają na to samo zjawisko, czyli na dobór kolejnego tokenu, tylko różnymi drogami. Dlatego OpenAI dodaje w referencji ostrzeżenie, które cytuje się dziś niemal w całości: zalecamy zmienianie tego albo temperatury, ale nie obu naraz. Anthropic każe trzymać się obu parametrów tylko dla zaawansowanych zastosowań i zwykle zostawiać samą temperaturę. Google w Gemini łączy z kolei próbkowanie top-k, czyli limit liczby kandydatów, z próbkowaniem top-p, opisując to jako podejście łączone. W praktyce, dopóki ktoś nie siedzi w tym na co dzień, rozsądna droga jest jedna: dotykać temperatury i zostawić top_p w spokoju.
Gdzie ustawia się temperaturę, a gdzie jej nie ma?
Skoro to parametr żądania, szukaj go tam, gdzie zapytanie do modelu buduje się samemu. W API OpenAI to pole temperature w żądaniu czatu, w API Anthropic to pole temperature w wywołaniu messages, w API Google pole temperature wewnątrz konfiguracji generowania. Amazon Bedrock wystawia je dla modeli Lammy, a narzędzia pracujące na otwartych modelach mają odpowiedniki: Hugging Face Transformers trzyma tę wartość w pliku generation_config.json dołączonym do modelu, z domyślną 1,0, gdy plik jej nie ustawia. Wszystkie te miejsca ma w jednym punkcie wspólnym: ustawia je osoba budująca aplikację, nie osoba pisząca do czatu.
Świeży zwrot w dokumentacjach jest pouczający. Anthropic oznaczył w referencji parametr temperature jako przestarzały: modele wydane po Claude Opus 4.6 nie wspierają jego ustawiania, wartość 1,0 jest przyjmowana dla zgodności wstecznej, a każda inna kończy się błędem 400. Podobnie top_p, z wartością 0,99 lub wyższą jako jedyną akceptowaną. Google z kolei zapisał w referencji konfiguracji generowania, że pole temperature nie jest już wspierane i jest po cichu ignorowane w Gemini 3.6 Flash i nowszych modelach. Dwaj dostawcy równolegle zabierają programistom suwak, którego zwykły użytkownik czatu nigdy nie miał. Trzeba to sprawdzać przy każdym kolejnym modelu, bo stan na 15.10.2026 może się zmienić szybciej, niż zdążymy zaktualizować ten tekst.
A jak to wygląda w czacie konsumenckim? W ustawieniach ChatGPT nie ma regulacji temperatury: pomoc OpenAI opisuje ten parametr w materiałach dla deweloperów, a interfejs aplikacji nie wystawia go użytkownikowi. Losowość ustawia po swojej stronie producent, zgodnie z domyślnymi wartościami swoich modeli. Zamiast suwaka zostaje narzędzie, które masz od zawsze: samo polecenie. Żądanie „suchego, rzeczowego opisu” albo „dwudziestu dzikich pomysłów bez cenzury” pcha model w jedną z tych stron mimo domyślnej temperatury, o czym piszę więcej w tekście Co to jest prompt. Jeśli chcesz mieć realny wpływ na to ustawienie, droga wiedzie przez API albo przez narzędzia do uruchamiania otwartych modeli AI na własnym sprzęcie, gdzie parametr jest na widoku i do ruszania.
Czemu to samo polecenie daje różne odpowiedzi (i czy temperatura powoduje halucynacje)?
Powtarzalność, o której wspominałem przy temperaturze 0, łączy się z drugim codziennym objawem: ta sama instrukcja wpisana dwa razy daje dwa różne teksty. To nie halucynacja ani błąd, tylko normalny skutek losowania przy każdym tokenie. Gdy zależy ci na porównywalnych wynikach, dokumentacje proponują ograniczone środki: parametr seed w API OpenAI, który ma dawać najlepszą próbę powtarzalności przy tym samym ziarnie i tych samych ustawieniach, z zastrzeżeniem, że determinizm nie jest gwarantowany, albo temperatura bliska zera z pełną świadomością, że identycznych odpowiedzi nie da się obiecać. Treść odpowiedzi zależy też od wielu rzeczy poza temperaturą: od wersji modelu po zmiany po jego stronie, których nie widzisz.
Temperaturę często obwinia się też o halucynacje, czyli zmyślone odpowiedzi podane z pewną miną. Dokumentacje producentów nie obiecują jednak, że niska temperatura je leczy, a dostępne badania rzucają na to inne światło. Zespół Renzego i Guvena zbadał na dziewięciu popularnych modelach, przy pięciu technikach promptowania, wpływ temperatury rosnącej od 0,0 do 1,6 na zadania problemowe i stwierdził, że zmiany od 0,0 do 1,0 nie mają statystycznie istotnego wpływu na wyniki. IBM przytacza z kolei analizę Peeperkorna i współpracowników: temperatura jest słabo skorelowana z nowością tekstu, umiarkowanie z niespójnością, a jej wpływ na „kreatywność” jest znacznie słabszy, niż każe przypuszczać nazwa „parametru kreatywności”. Korelacja to nie przyczynowość i żaden z tych wyników nie czyni temperatury terapią na zmyślanie.
Uczciwy stan wiedzy wygląda więc tak: temperatura steruje stylem wyborów, nie prawdziwością. Model, który nie zna odpowiedzi, przy temperaturze 0,0 też jej nie zna, tylko zmyśla spokojniej. Jeśli temat halucynacji cię ciągnie dalej, napisałem o nich osobny tekst Halucynacje AI, z przykładami i ze sposobami kontroli, które mają pokrycie w źródłach.
Najważniejsze informacje
| Ustawienie | Co zmienia | Kiedy używać |
|---|---|---|
| temperatura 0 | wybór zawsze z czołówki rozkładu, bez gwarancji powtarzalności | fakty, klasyfikacje, kod, dane |
| temperatura 0,1-0,4 | ostrożny dobór słów, mało zaskoczeń | dokumentacja techniczna, odpowiedzi o faktach |
| temperatura ok. 0,5 | środek skali u Lammy w Bedrock (domyślna) | zadania mieszane, uniwersalnie |
| temperatura ok. 0,7-1,0 | swobodniejszy język przy zachowanej spójności; 1,0 to domyślna OpenAI i Anthropic | rozmowy, maile, szkice tekstów |
| temperatura powyżej 1,0 | częste sięganie po rzadkie tokeny, rośnie ryzyko niespójności | burza mózgów, wiersze, szukanie nazw |
| top_p 0,1-0,5 | odcina długi słowny ogon, zostawia tylko czołówkę masy prawdopodobieństwa | precyzyjne zadania zamiast niskiej temperatury |
| top_p ok. 0,9-1,0 | pełny krąg kandydatów | twórcze zadania; zmieniaj tę wartość albo temperaturę, nie oba naraz |
Najczęstsze pytania
Co to jest temperatura AI?
To parametr sterujący losowością przy dobieraniu kolejnych tokenów, z których model składa odpowiedź. Niższa wartość zwiększa szansę wyboru tokenów najpewniejszych, wyższa otwiera drogę tokenom mniej prawdopodobnym. Ustawia się go w API i w narzędziach deweloperskich, nie w oknie czatu.
Czym jest temperatura modelu AI i od czego zależy jej skala?
Temperatura modelu AI to ten sam mechanizm, ale skala zależy od dostawcy. OpenAI i Google dopuszczają wartości od 0 do 2, Anthropic od 0 do 1, a Llama w Amazon Bedrock od 0 do 1 z domyślną 0,5. Dlatego nie ma jednej uniwersalnej liczby i zawsze trzeba patrzeć do referencji konkretnego API.
Czy temperatura ChatGPT jest dostępna w ustawieniach aplikacji?
Nie, czat ChatGPT nie wystawia tego ustawienia użytkownikowi. Parametr jest opisany w dokumentacji API, gdzie jego domyślna wartość wynosi 1, a ustawienia aplikacji konsumenckiej nie zawierają go wcale. Wpływ na styl odpowiedzi masz przez treść polecenia, na przykład przez żądanie suchego, rzeczowego tonu.
Co daje temperatura 0 w ChatGPT i w API?
Teoretycznie przy temperaturze 0 model zawsze wybiera token z czołówki rozkładu, więc odpowiedzi powinny być powtarzalne. Dokumentacja Anthropic przestrzega jednak wprost, że nawet przy temperaturze 0,0 wyniki nie są w pełni deterministyczne, a OpenAI zastrzega, że nawet parametr seed nie gwarantuje identycznych wyników. To ustawienie zmniejsza losowość, ale nie obiecuje kopii zapasowej tej samej odpowiedzi.
Jaka temperatura promptu w ChatGPT będzie najlepsza do pisania?
Temperatura nie jest częścią promptu, więc w czacie ChatGPT nie ustawisz jej do żadnego zadania; reguluje ją producent po swojej stronie. Do pisania masz dwa tory: formułować polecenie tak, by wymusić pożądany styl, albo skorzystać z API, gdzie do tekstów twórczych bierze się wartości bliższe 0,8 albo 1,0, a do rzeczowych bliższe 0,2, według przykładów z referencji OpenAI i wskazówek Anthropic.
Źródła
- OpenAI, referencja API Chat Completions (temperature, top_p, seed), odczyt 15.10.2026: https://platform.openai.com/docs/api-reference/chat/create
- Anthropic, referencja Messages API, odczyt 15.10.2026: https://docs.claude.com/en/api/messages
- Google AI, referencja GenerateContent, GenerationConfig, odczyt 15.10.2026: https://ai.google.dev/api/generate-content
- AWS, dokumentacja Bedrock, parametry inferencji Meta Llama, odczyt 15.10.2026: https://docs.aws.amazon.com/bedrock/latest/userguide/model-parameters-meta.html
- IBM, What is LLM Temperature?, odczyt 15.10.2026: https://www.ibm.com/think/topics/llm-temperature
- Renze, Guven, The Effect of Sampling Temperature on Problem Solving in Large Language Models, arXiv, odczyt 15.10.2026: https://arxiv.org/abs/2402.05201
- Wikipedia, Softmax function, sekcja Temperature, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Softmax_function
- Hugging Face, dokumentacja Transformers, text_generation, odczyt 15.10.2026: https://huggingface.co/docs/transformers/main_classes/text_generation