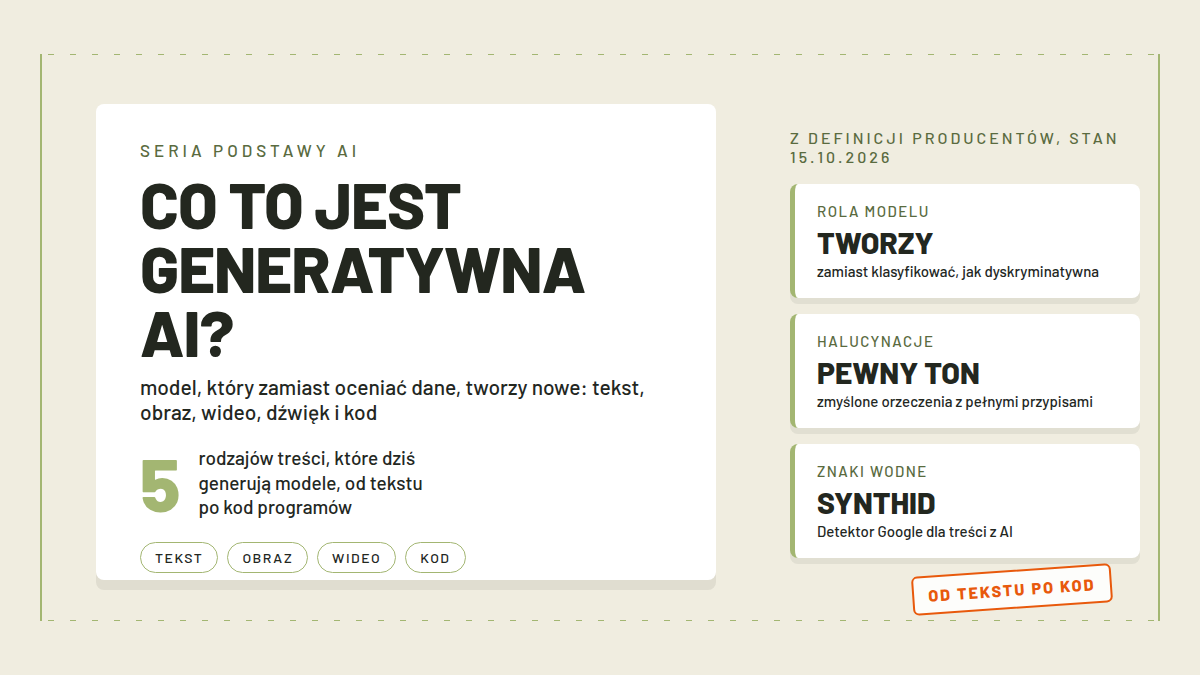
Maszyna, która widziała tysiące zdjęć polskiego wybrzeża, narysuje własny Bałtyk, choć nigdy nad nim nie postała. Najkrótsza odpowiedź na pytanie, co to jest generatywna AI, wygląda właśnie tak: to odłam sztucznej inteligencji, który zamiast oceniać i sortować istniejące dane, tworzy nowe. IBM opisuje ją jako AI zdolną wytwarzać oryginalne treści, od tekstu i obrazów po wideo, dźwięk i kod, zawsze w odpowiedzi na polecenie użytkownika. Google Cloud kładzie akcent inaczej i mówi o dziedzinie uczenia maszynowego, która buduje modele generujące nową zawartość. Piszę o tym w serii Podstawy AI, więc idziemy po kolei, od definicji po praktyczne konsekwencje, bez skakania po żargonie.
Z tego tekstu zostanie ci w głowie kilka rzeczy. Definicja u źródeł, czyli u Google, IBM, AWS i w obu Wikipediach, jedna analogia, która porządkuje różnicę między AI generatywną a dyskryminatywną, przegląd tego, co modele dziś generują, wyjaśnienie, jak LLM-y i modele multimodalne mają się do całej rodziny, spis typowych pomyłek razem z jednym głośnym przypadkiem z sądu oraz krótko o rozpoznawaniu treści generowanych. Na końcu FAQ z pytaniami, które ludzie naprawdę wpisują w wyszukiwarkę, przepisanymi z podpowiedzi Google.
- Co to jest generatywna AI? Definicja u źródeł
- Generatywna AI a dyskryminatywna: ekspert od fałszerzy i malarz
- Co dziś generują modele: tekst, obrazy, wideo, dźwięk i kod
- Jak generatywna AI ma się do LLM i modeli multimodalnych
- Czego generatywna AI nie robi i gdzie się myli
- Jak rozpoznać treści generowane
- FAQ
Co to jest generatywna AI? Definicja u źródeł
Encyklopedycznie sprawa jest prosta. Angielska Wikipedia nazywa generatywną sztuczną inteligencję subdziedziną AI, która używa modeli generatywnych do wytwarzania tekstu, obrazów, wideo, dźwięku, kodu i innych cyfrowych danych. Modele te uczą się wzorców i struktury danych treningowych, a potem generują nowe dane o podobnych cechach, zwykle w odpowiedzi na polecenie napisane zwykłym językiem. Polska Wikipedia prowadzi hasło pod nazwą generatywna sztuczna inteligencja i opisuje je niemal identycznie, jako ogół narzędzi AI służących do generowania tekstu, obrazów, filmów i innych danych, najczęściej na podstawie podpowiedzi od użytkownika. Spotykasz więc dwa układy tej nazwy, generatywna sztuczna inteligencja i sztuczna inteligencja generatywna, oba znaczą to samo i oba są poprawne, w tym tekście używam ich naprzemiennie.
Wśród definicji komercyjnych najbardziej konkretna jest ta od IBM, o której wspomniałem wyżej. AWS dokłada do listy generowanych rzeczy rozmowy, historie i muzykę, co dobrze pokazuje, że nie chodzi wyłącznie o słowa. Wspólny mianownik wszystkich tych definicji jest jeden: na wyjściu dostajesz nowy obiekt, a nie etykietę albo ocenę czegoś, co już istnieje.
Sposób rozmowy z takim modelem ma własną nazwę. Zgodnie z dokumentacją Google Clouda prompt to polecenie napisane naturalnym językiem, wysłane do modelu po to, żeby dostać odpowiedź; może ono zawierać tekst, obrazy, wideo, audio albo dokumenty. Model nie wyciąga tych rzeczy znikąd. Uczy się wzorców z ogromnych zbiorów danych, a następnie tworzy nowe dane, które pasują do wyuczonych cech. Jeśli chcesz zrozumieć fundament tej zdolności, osobno opisaliśmy uczenie maszynowe i sieci neuronowe, bo to na nich generatywna AI stoi.
Co to znaczy generatywna AI?
Sam przymiotnik mówi najwięcej: model generuje dane, zamiast je etykietować. Skoro pytasz, co to znaczy generatywna AI, najprościej przełożyć to na dwa kierunki jednej strzałki. Klasyczny model dostaje obiekt i odpowiada kategorią: na tym zdjęciu jest kot, ten mail to spam. Model generatywny działa w odwrotną stronę i, jak opisuje AWS, zamiast przewidywać etykietę na podstawie cech, przewiduje cechy na podstawie etykiety. Poproś o kota, a dostaniesz nowego kota, którego nikt nigdy nie sfotografował.
Dopowiedzmy jeszcze jedną rzecz o czasie, bo tę nazwę otacza kilka nieporozumień. Technologia nie wypadła z nieba w listopadzie 2022. AWS pisze, że generatywna AI wyrosła w drugiej połowie ubiegłej dekady razem z postępem głębokiego uczenia, a IBM w swojej osi czasu datuje pierwsze sieci GAN i modele dyfuzyjne na 2014 rok, publikację pracy o transformerach na 2017, a ChatGPT z masową popularnością na 2022, po którym, cytując, technologia wylądowała na czołówkach świata i uruchomiła bezprecedensową falę innowacji i adopcji. Data, którą pamięta większość ludzi, to więc moment popularyzacji, nie wynalazku.
Generatywna AI a dyskryminatywna: ekspert od fałszerzy i malarz
Teraz analogia, którą bierzesz za darmo i bez licencji. Wyobraź sobie dwóch profesjonalistów od malarstwa. Pierwszy to muzealny ekspert, który patrzy na płótno i rozstrzyga: oryginał albo sprytna kopia. Drugi to malarz, który bierze pędzel i maluje nowe płótno w duchu szkoły holenderskiej. Ekspert reprezentuje AI dyskryminatywną, bo patrzy na dane i przypisuje im kategorię. Malarz reprezentuje generatywną, bo z krótkiego polecenia buduje obiekt, którego wcześniej nie było. Obaj znają się na malarstwie doskonale, a ich praca jest odwrotnością siebie.
To rozróżnienie nie jest moim wymysłem. AWS pisze wprost, że tradycyjne modele uczenia maszynowego były dyskryminatywne, czyli skupione na klasyfikowaniu danych i szukaniu relacji między czynnikami znanymi a nieznanymi. Modele generatywne idą, jak to ujął, krok dalej. Angielska Wikipedia ilustruje to parą przykładów: klasyfikator obrazów jako sieć trenowana z celem dyskryminatywnym i model tekst na obraz jako sieć z celem generatywnym. W praktyce AI dyskryminatywna odpowiada na pytania typu czy, który i ile, czyli czy w mailu siedzi spam, czy na nagraniu jest przejście dla pieszych. Generatywna spełnia polecenia w stylu napisz, narysuj, zaśpiewaj, dopisz funkcję.
| Cecha | Dyskryminatywna | Generatywna |
|---|---|---|
| Pytanie do modelu | Co to jest? | Stwórz coś nowego |
| Wynik pracy | Etykieta, kategoria, ocena | Tekst, obraz, dźwięk, kod |
| Przykład | Filtr spamu, rozpoznawanie twarzy | ChatGPT, generator obrazów |
Nie czytaj tego jako podziału na dobre i złe albo na stare i nowe. Oba typy modeli stoją na tych samych fundamentach uczenia maszynowego i treningu na danych, różni je zadanie i kształt wyniku. Ta sama rodzina technologii, która dziś pisze wypracowania za uczniów, jeszcze dekadę temu była znana głównie z sortowania skrzynki pocztowej i rozpoznawania twarzy na zdjęciach. Gdybym miał zostawić ci jedną wskazówkę do czytania o technologii: skoro w tekście pojawia się rozpoznanie, klasyfikacja albo filtrowanie, myśl o modelu dyskryminatywnym, a skoro o pisaniu, rysowaniu czy komponowaniu, o generatywnym.
Co dziś generują modele: tekst, obrazy, wideo, dźwięk i kod
Lista rośnie z każdym rokiem, ale ramy są stabilne i dobrze udokumentowane. Idę przez nie po kolei, od tekstu do kodu, z nazwami systemów zamiast ogólników. Nazwy handlowe zmieniają się szybciej niż definicje, więc trzymam się ról, czyli tego, co model robi, a nie jak się akurat nazywa.
Tekst
Tekst to najbardziej znany obszar działania generatywnej AI. Wikipedia wymienia w jednym wyliczeniu chatboty ChatGPT, Claude, Microsoft Copilot, DeepSeek, Gemini, Grok i Qwen, a za nimi stoją duże modele językowe trenowane na gigantycznych zbiorach tekstu. Odpowiadają na pytania, streszczają, piszą eseje i listy na podstawie promptu. Mechanikę tego opisujemy w osobnym tekście co to jest LLM, więc tu zostanę przy miejscu w hierarchii: każdy LLM jest przykładem generatywnej AI, ale nie odwrotnie.
Obrazy
Obrazy powstają dziś najczęściej w modelach dyfuzyjnych. IBM opisuje ich mechanikę tak: najpierw dodaje się szum do danych treningowych, aż staną się losowe i nierozpoznawalne, a następnie uczy algorytm iteracyjnego usuwania tego szumu, żeby odsłonić pożądany wynik. Takie modele trenują się dłużej niż sieci GAN, ale dają drobniejszą kontrolę nad wynikiem, szczególnie przy generowaniu obrazów wysokiej jakości. Wikipedia wymienia po nazwisku DALL-E, Adobe Firefly, Stable Diffusion i Midjourney, a IBM dopowiada, że DALL-E napędza właśnie model dyfuzyjny. Jeśli chcesz zacząć bez kosztów, mieliśmy osobny tekst o darmowych obrazkach z AI.
Wideo
Wideo generują modele tekst na wideo, którymi według Wikipedii są między innymi Veo, LTX i Sora. Działają na podobnej zasadzie co generatory obrazów, tyle że wynikiem jest sekwencja klatek. Nie testowałem ich we własnych materiałach, więc ograniczam się do tego, co mówią źródła: obszar jest młody, a jakość i dostępność zmieniają się z kwartału na kwartał.
Dźwięk i mowa
Tu mieszczą się dwie rzeczy: synteza mowy i generowanie muzyki. Wikipedia wymienia modele tekst na mowę, na przykład ElevenLabs, oraz modele tekst na muzykę, takie jak Suno i Udio. IBM w pierwszym zdaniu definicji wymienia dźwięk obok tekstu, obrazów, wideo i kodu, więc nie jest to nisza, tylko pełnoprawny obszar tej rodziny technologii. Jak te narzędzia radzą sobie z językiem polskim, zależy od konkretnego produktu; w tym tekście tego nie testowałem, więc nie oceniam.
Kod
Kod jest w definicjach od początku. IBM wymienia kod komputerowy w pierwszym zdaniu opisu generatywnej AI, a Google Cloud wymienia generowanie kodu wśród możliwości swojego API. Najbardziej znany przykład to GitHub Copilot, opisywany przez producenta jako asystent podpowiadający kod w edytorze i towarzyszący programiście przez cały cykl życia oprogramowania. Darmowy plan Copilota zawiera, zgodnie ze stroną GitHuba, 2000 uzupełnień kodu miesięcznie.
Jak generatywna AI ma się do LLM i modeli multimodalnych
Najprościej: LLM to członek rodziny, a nie jej synonim. Google Cloud pisze, że modele generatywnej AI często nazywa się dużymi modelami językowymi ze względu na ich rozmiar i zdolność rozumienia oraz generowania języka naturalnego, ale zależnie od danych treningowych potrafią one pracować z wieloma rodzajami danych naraz. Ułóż to tak: każdy LLM jest generatywną AI, bo generuje tekst, ale generatywna AI to też generatory obrazów, wideo i mowy, które słowami nie handlują.
Granica między tymi obszarami zaciera się w modelach multimodalnych. Według dokumentacji Google Clouda model pracujący z wieloma rodzajami danych nazywa się właśnie multimodalnym, a prompt może zawierać tekst, obrazy, wideo i audio jednocześnie. Google jako przykład podaje rodzinę Gemini, projektowaną pod zastosowania multimodalne. To pojęcie rozbieramy osobno w tekście o modelu multimodalnym.
Jeśli wolisz porządek od sufitu, hierarchia wygląda tak. Sztuczna inteligencja to pojęcie najszersze, wewnątrz siedzi uczenie maszynowe, w nim głębokie uczenie, bo jak pisze IBM, generatywna AI opiera się na zaawansowanych modelach uczenia maszynowego, zwanych modelami głębokiego uczenia. Generatywna AI jest obszarem, w którym te modele zamiast klasyfikować, tworzą nowe dane, a LLM-y i generatory obrazów mieszczą się wewnątrz niego, każdy ze swoją specjalizacją. Taki porządek ratuje cię przed najczęstszą pomyłką terminologiczną, czyli traktowaniem pojęć AI, LLM i ChatGPT jako synonimów. Przydaje się też przy czytaniu komunikatów producentów, bo firmy chętnie mówią o AI w ogóle wtedy, gdy chodzi o jeden wąski model wyspecjalizowany w jednym zadaniu.
Czego generatywna AI nie robi i gdzie się myli
Najgłośniejsza wada ma własną nazwę. Z definicji IBM halucynacja to wynik generatywnej AI bezsensowny albo po prostu niedokładny, który mimo to zbyt często brzmi całkowicie wiarygodnie. IBM przywołuje klasyczny przykład prawnika, który użył narzędzia gen AI do researchu w głośnej sprawie; narzędzie wygenerowało kilka orzeczeń razem z cytatami i przypisami, kompletnie zmyślonych. Pisaliśmy o tym zjawisku osobno w tekście o halucynacjach AI. Wniosek praktyczny jest prosty: nazwiska, orzeczenia, cytaty i liczby z odpowiedzi modelu sprawdzaj u źródła, zanim cokolwiek z tego gdziekolwiek trafi.
Do liczenia generatywna AI nie została stworzona. Z opisu AWS wynika, że modelowanie generatywne szacuje prawdopodobieństwo wspólnego wystąpienia zmiennych, czyli dopasowuje do kontekstu to, co statystycznie pasuje, a nie sumuje kolumny jak arkusz kalkulacyjny. Model może więc wygenerować przekonawczo wyglądającą kwotę albo sumę bez pokrycia w rzeczywistości i zrobi to z miną pełnego spokoju. Do obliczeń służą kalkulatory i arkusze, a odpowiedź modelu traktuj jak tekst o liczbach, nie jak wynik obliczeń.
Wiedza modelu ma też datę ważności. Google Cloud zauważa, że choć modele trenuje się na ogromnych zbiorach danych, żeby były użyteczne w realnych zastosowaniach, potrzebują dostępu do informacji spoza danych treningowych. IBM dopowiada resztę: sam model bazowy aktualizuje się rzadko, może raz na rok albo półtora roku, i dlatego powstały frameworki typu RAG, które dorzucają do odpowiedzi aktualne źródła zewnętrzne. Jeśli narzędzie, którego używasz, nie ma podłączenia do wyszukiwarki ani własnych danych, pytanie o wydarzenia sprzed tygodnia może wrócić z odpowiedzią sprzed miesięcy.
AWS podsumowuje ograniczenia całej rodziny bez upiększania: systemy generatywne potrafią produkować informacje niedokładne albo wprowadzające w błąd, bo polegają na wzorcach z danych treningowych i odzwierciedlają zawarte w nich uprzedzenia. Ta sama dokumentacja przyznaje, że kreatywność takich modelów jest ograniczona tym, na czym się uczyły, więc wyniki bywają powtarzalne i wtórne. Do tego dochodzi różnica, o której rzadko się mówi: model nie doświadcza świata, tylko rekomponuje to, co widział w danych.
Jak rozpoznać treści generowane
Na oko, ruletką. Systemowe podejście to znaki wodne i tu najdalej zaszedł Google. SynthID, zgodnie ze stroną DeepMind, to narzędzie do znakowania treści wygenerowanych przez AI; osadza w obrazach, dźwięku, tekście i wideo cyfrowy znak wodny niedostrzegalny dla człowieka, który następnie potrafi wykryć technologia Google. W 2025 roku wystartował SynthID Detector, portal weryfikacyjny, w którym każdy może sprawdzić, czy obraz, wideo albo plik audio powstał z AI od Google lub jej partnerów, w tym OpenAI, NVIDII i Kakao. Piszę to za dokumentacją, bo sam detektora nie testowałem.
Uczciwie o granicach metody: detektor weryfikuje znak SynthID, więc materiał bez takiego znaku, na przykład zdjęcie z generatora, który treści nie znakuje, przechodzi bez śladu. Do sprawdzania obrazów mieliśmy osobny poradnik jak sprawdzić, czy zdjęcie jest z AI. Krótki kodeks na co dzień wygląda tak: patrz na źródło publikacji, porównuj z innymi materiałami z danego wydarzenia i nie traktuj jednego zrzutu ekranu jako dowodu. Rozpoznawanie treści generowanych to dziś umiejętność, nie usługa z gwarancją.
FAQ
Co to jest generatywna AI?
Generatywna AI to część sztucznej inteligencji, która po nauczeniu się wzorców z istniejących danych tworzy nowe, czyli tekst, obrazy, wideo, dźwięk albo kod. W odróżnieniu od klasycznych modeli klasyfikujących nie odpowiada etykietą, tylko wytworzonym materiałem.
Co to znaczy generatywna sztuczna inteligencja?
Znaczy tyle, co AI, która generuje: model wytwarza nowe treści w odpowiedzi na polecenie, zamiast kategoryzować te istniejące. Przymiotnik opisuje skutek pracy modelu, a nie jego wewnętrzną budowę, więc ta sama nazwa obejmuje generatory tekstu, obrazów, wideo, mowy i kodu.
Jakie są przykłady generatywnej AI?
Chatboty takie jak ChatGPT, Claude czy Gemini, generatory obrazów typu DALL-E, Midjourney, Stable Diffusion i Adobe Firefly, modele tekst na wideo jak Sora i Veo, synteza mowy i muzyki jak ElevenLabs czy Suno oraz asystenci kodu jak GitHub Copilot. To wyliczenie biorę z analizy Wikipedii i definicji IBM, nie z własnych upodobań.
Czy generatywna sztuczna inteligencja zagraża polskiemu rynkowi pracy?
Odpowiem uczciwie: twarde dane dla Polski w źródłach, które przeczytałem do tego tekstu, nie występują, więc liczby nie podam. Bezpieczne spojrzenie jest takie, że generatywna AI automatyzuje pojedyncze zadania, jak pisanie szkiców, streszczanie czy proste fragmenty kodu, a nie całe zawody od razu, i wymaga nadzoru, bo myli się z pełnym przekonaniem. To narzędzie zmieniające sposób pracy nad tekstem i kodem, a nie gotowa maszyna do zastępowania ludzi.
Czy ChatGPT to generatywna AI?
Tak. Wikipedia wymienia ChatGPT wśród chatbotów będących zastosowaniami generatywnej AI, a IBM wskazuje premierę ChatGPT w 2022 roku jako moment, w którym technologia trafiła na czołówki. ChatGPT działa na dużym modelu językowym, czyli na podtypie generatywnej AI wyspecjalizowanym w tekście.
Źródła
- Google Cloud dokumentacja, przewodnik Generative AI beginner’s guide, odczyt 15.10.2026: https://cloud.google.com/vertex-ai/generative-ai/docs/learn/overview
- IBM think, artykuł What is generative AI?, odczyt 15.10.2026: https://www.ibm.com/think/topics/generative-ai
- AWS, artykuł What is Generative AI?, odczyt 15.10.2026: https://aws.amazon.com/what-is/generative-ai/
- Wikipedia EN, hasło Generative AI, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Generative_AI
- Wikipedia PL, hasło Generatywna sztuczna inteligencja, odczyt 15.10.2026: https://pl.wikipedia.org/wiki/Generatywna_sztuczna_inteligencja
- Google DeepMind, strona SynthID, odczyt 15.10.2026: https://deepmind.google/models/synthid/
- GitHub, strona produktu Copilot, odczyt 15.10.2026: https://github.com/features/copilot