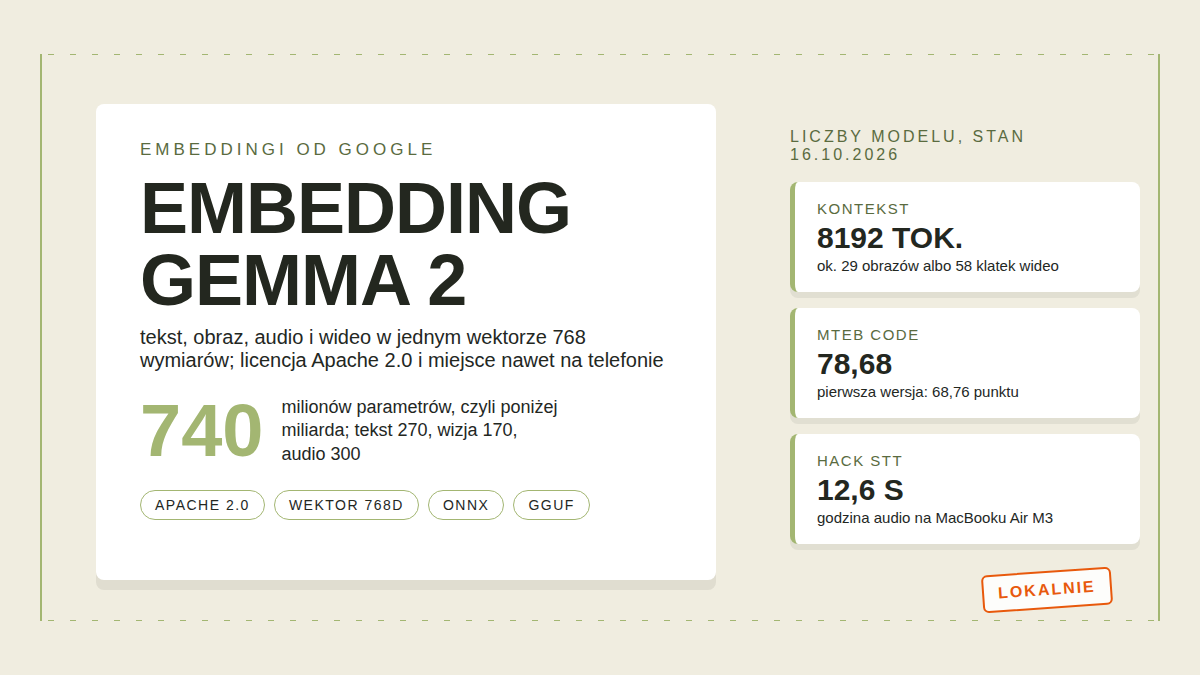
Google opublikował 6 października 2026 drugą odsłonę swojego najmniejszego modelu osadzeń. EmbeddingGemma 2 ma 740 mln parametrów, dziedziczy architekturę po Gemma 4 i wychodzi na licencji Apache 2.0, czyli bez ograniczeń w użytkowaniu komercyjnym. Różnica wobec pierwszej wersji jest jednocześnie przewagą: tam gdzie EmbeddingGemma z 2025 roku rozumiał tylko tekst, nowy model przyjmuje obrazy, wideo i dźwięk, a wszystko to mapuje do jednej wspólnej przestrzeni wektorowej. Wpis zebrał na Hacker News 439 punktów, a tydzień później temat wrócił na pierwszą stronę z drugą falą: ktoś wziął ten model i wyciągnął z niego rozpoznawanie mowy.
Dla czytelnika, który nie buduje modeli, tylko chce mieć u siebie na dysku sensowne wyszukiwanie po plikach, ten model jest ciekawszy niż kolejny czatbot. Osadzenia to warstwa, na której stoi wyszukiwanie semantyczne i lokalne RAG, a EmbeddingGemma 2 po kwantyzacji potrzebuje na telefonie Pixel 11 Pro około 191 MB aktywnej pamięci dla samej części tekstowej i około 567 MB dla pełnego wariantu multimodalnego. To sprzęt klasy codziennej, nie serwerownia. W tym tekście rozkładam model na liczby z dokumentacji producenta, pokazuję historię hacku mowy i przechodzę przez uruchomienie krok po kroku.
- Najważniejsze informacje
- Czym jest model osadzeń i czym różni się od czatbota
- Liczby i benchmarki
- Mniejszy wektor, mniejsza baza
- Jak z modelu osadzeń zrobiono model mowy
- Jak zacząć
- Kiedy ma sens, a kiedy nie
- Najczęstsze pytania
Najważniejsze informacje
| Co | Dane |
|---|---|
| Premiera | 6.10.2026, blog Google DeepMind |
| Parametry | 740 mln razem: 270 mln tekst, 170 mln wizja, 300 mln audio |
| Wymiar wektora | 768, skracany przez MRL do 512, 256 albo 128 |
| Kontekst | 8192 tokenów, wspólne dla wszystkich modalności |
| Języki | ponad 100, cutoff danych treningowych: styczeń 2025 |
| Licencja | Apache 2.0 |
| Pamięć po kwantyzacji | od ok. 191 MB (tekst) do ok. 567 MB (pełny model) na Pixel 11 Pro |
| Pobranie | Hugging Face, Kaggle, Ollama, ONNX, GGUF |
Czym jest model osadzeń i czym różni się od czatbota
EmbeddingGemma 2 nie prowadzi rozmów i nie odpowiada w języku naturalnym. Jego praca kończy się na tym, że zamienia wejście, czyli tekst, obraz, klatki wideo albo dźwięk, na wektor liczb o stałej długości. Ten wektor ma 768 wymiarów i trzyma sens wejścia w takiej formie, że dwa podobne fragmenty treści dostają wektory leżące blisko siebie, a niepowiązane daleko. Jeśli pojęcie jest niejasne, na blogu jest osobny tekst o tym, czym są embeddingi i po co się je stosuje, tam rozpisuję mechanizm od podstaw.
Z tej jednej własności wypada większość zastosowań. Wyszukiwanie po własnych dokumentach po znaczeniu, a nie po trafności słów. Grupowanie notatek w klastry. Wykrywanie duplikatów. Klasyfikacja zgłoszeń. I najbardziej popularny przypadek, czyli RAG, w którym model osadzeń znajduje fragmenty wiedzy, a model generatywny na ich podstawie pisze odpowiedź. Mechanizm tego układu rozpisałem w tekście jak działa RAG, a EmbeddingGemma 2 jest w nim tym elementem, który szuka. Google wprost sugeruje parowanie go z Gemma 4 E2B do mobilnych pipeline’ów RAG i podkreśla, że oba modele dzielą tokenizator tekstu i encoder audio, przez co wspólne uruchomienie kosztuje mniej pamięci.
Wspólna przestrzeń dla różnych modalności oznacza jedno zjawisko, które jeszcze dwa lata temu było ozdobą dużych modeli chmurowych: zapytanie tekstowe „jak brzmiał fragment o warranty” potrafi trafić w kawałek nagrania, bo dźwięk i tekst lądują w tej samej 768-wymiarowej przestrzeni. Dokumentacja podaje budżet tokenowy dla każdej modalności: obraz kosztuje 280 tokenów, klatka wideo 140, sekunda audio 25. W oknie 8192 tokenów mieści się stąd około 29 obrazów, 58 klatek wideo albo niecałe 5,5 minuty nagrania, a wejścia można mieszać, bo wszystko schodzi do jednego wektora.
Liczby i benchmarki
| Miara | EmbeddingGemma 2 | EmbeddingGemma 1 |
|---|---|---|
| Parametry razem | 740 mln | 308 mln |
| MTEB multilingual v2 (Mean Task) | 61,36 | 61,15 |
| MTEB code v1 (NDCG@10) | 78,68 | 68,76 |
| Kontekst | 8192 tokenów | 2048 tokenów |
| Modalności | tekst, obraz, wideo, audio | tekst |
| Baza architektury | Gemma 4 | Gemma 3 |
Najbardziej nośna liczba tej premiery to skok na kodzie. 78,68 wobec 68,76 punktów to prawie dziesięć punktów NDCG@10 między sąsiednimi generacjami i to właśnie ta różnica czyni model sensownym do lokalnego indeksowania repozytorium i wyszukiwania po kodzie zapytaniami w języku naturalnym. Na tekście ogólnym wynik praktycznie stoi w miejscu (61,36 wobec 61,15), więc kto używał pierwszej wersji do notatek, nie zobaczy przeskoku jakości, zobaczy za to czterokrotnie dłuższy kontekst. Na pozostałych modalnościach pierwsza wersja nie miała czego porównywać, bo nie brała ich na wejście: karta podaje 64,64 punktu na MIEB lite dla obrazów, 57,28 Hit@1 na MMEB v2 dla obrazów, 50,67 dla wideo i 49,39 na MAEB dla audio.
Blog producenta deklaruje czołowe wyniki wśród multimodalnych modeli osadzeń poniżej 1 miliarda parametrów i twierdzi, że model goni specjalistyczne modele ponad dwukrotnie większe. To deklaracja strony, która model zrobiła, ale lista benchmarków w karcie jest konkretna i policzalna, więc każdy może zweryfikować liczby u siebie na własnych danych.
Ten kontekst trzeba oddzielić od konkurencji, bo porównywarki mieszają różne miary. Nomic-embed-text-v1.5 to model czysto tekstowy na Apache 2.0, który też ma matryoszkowe skracanie wektora, a metryki w jego karcie pochodzą z angielskiej wersji MTEB, więc z wynikami multilingual tej tabeli nie wolno ich zestawiać obok siebie. BGE-M3 od BAAI działa na licencji MIT, ma wektor 1024-wymiarowy, kontekst 8192 tokenów i ponad 100 języków, a oprócz osadzeń gęstych liczy też rzadkie i multi-wektorowe w jednym przebiegu, co w praktyce znaczy, że w RAG potrafi zasilać wyszukiwanie hybrydowe. EmbeddingGemma 2 wyróżnia się na tym tle jedną rzeczą: jest jedynym z tej trójki, który oprócz tekstu bierze obraz, wideo i dźwięk, i robi to w rozmiarze, który mieści się na telefonie.
Mniejszy wektor, mniejsza baza
Matryoshka Representation Learning w tym modelu nie jest dodatkową opcją, tylko właściwością treningu. Wektor 768-wymiarowy można uciąć do 512, 256 albo 128 pierwszych wymiarów i po renormalizacji używać dalej. Karta pokazuje koszt: MTEB multilingual spada z 61,36 przy pełnym wymiarze do 61,17 przy 512 i 60,41 przy 256, a głębsze cięcie do 128 zabiera 57,89. Producent pisze wprost, że do 256 wymiarów spadek jest minimalny, a 128 wymiarów nadaje się głównie do zadań czysto tekstowych.
Dla kogoś, kto trzyma lokalnie sto tysięcy dokumentów, to najważniejszy przycisk w całym modelu. Kompresja 1:6 przy 128 wymiarach oznacza szóstek miejsca w bazie wektorowej i szybsze liczenie podobieństw, a przy wektorach 256-wymiarowych różnica jakości bywa niemierzalna na własnych danych. Dwie zasady z dokumentacji, o których ludzie zapominają: po skróceniu wektor trzeba ponownie znormalizować, bo ucięty fragment wektora jednostkowego nie jest jednostkowy, i zapytanie musi mieć ten sam wymiar co baza, bo 768-wymiarowym zapytaniem nie odpyta się kolekcji 128-wymiarowej.
Jak z modelu osadzeń zrobiono model mowy
Druga fala zainteresowania przyszła 13 października, gdy na Hacker News wylądował projekt Embedding Gemma Transcribe z opisem „We turned EmbeddingGemma 2 into a speech-to-text model”. Wątek zebrał 432 punkty i prawie sto komentarzy, a sama strona obiecuje godzinę audio przetranskrybowaną w około 13 sekund na zwykłym MacBooku Air, w całości lokalnie. To niezależny projekt, strona nosi zastrzeżenie o braku afiliacji z Google.
Mechanizm jest ciekawszy niż wynik. Autorzy nie dotknęli encoder audio modelu, zostawili go dokładnie takim, jakim go wytrenowano. Dorzucili małą sieć, którą nazywają readerem, i jej zadanie polega na tym, że przesuwa krótkie wycinki audio w stronę przestrzeni tekstowej modelu. Tam wybierane jest najbliższe z około 229 tysięcy angielskich słów, wycinki składają się w transkrypcję, a dodatkowy malutki model dokłada interpunkcję i wielkie litery. Cały trening objął tylko reader i zajął mniej niż dwie godziny na ośmiu kartach H100, na otwartych licencyjnie nagraniach mowy angielskiej. Baza nigdy nie była trenowana do rozpoznawania mowy, jak podkreślają sami autorzy.
Liczby z tabeli projektu trzeba czytać ostrożnie, bo autorzy sami piszą, że to „A rough guide, not a like-for-like ranking”. Ich aplikacja na Neural Engine w MacBooku Air M3 z 8 GB RAM osiąga 288x czasu rzeczywistego, czyli godzinę nagrania w 12,6 sekundy, a IBM Granite Speech 5.0 TurboCTC na tym samym laptopie robi to w 25,7 sekundy. Dalsze wiersze, Parakeet TDT 0.6B v3 i fine-tune Phonon-2, pochodzą z opublikowanych benchmarków FluidAudio na mocniejszych i nowszych maszynach, więc to tylko rząd wielkości. Jakość transkrypcji to około 5% błędu słownego wobec 2-3% u czołowych modeli mowy, więc do notatek głosowych i dyktowania się nadaje, do profesjonalnego transkrybowania niekoniecznie.
Ta historia ma wartość jako diagnoza, nie jako rekomendacja zakupu. Wspólna przestrzeń osadzeń okazała się na tyle dobrze ułożona, że tłumaczenie między dźwiękiem a tekstem dało się z niej wyczytać niemal na sucho, po dwóch godzinach treningu dodatkowej sieci. To pokazuje, do czego model został zaprojektowany: być uniwersalnym klejem semantycznym na urządzeniu, z którego da się ciągnąć zastosowania, których producent nie przewidział.
Jak zacząć
Najszybsza droga to Python z biblioteką sentence-transformers, bo cała obsługa prefiksów zadań siedzi w środku.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")
q = model.encode("faktura za internet październik", prompt_name="SearchQuery")
d = model.encode("title: none | text: Rachunek za internet za październik", prompt_name="Document")
print(model.similarity(q, d))
Prefiksy zadań to nie ozdoba, tylko element treningu. Zapytania szukające dostają prefiks „task: search result | query:”, dokumenty format „title: none | text:”, wyszukiwanie kodu ma własny prefiks, a zadania symetryczne, jak klasyfikacja i klastrowanie, dostają jednolity prefiks po obu stronach porównania. Pominięcie prefiksu nie psuje działania, ale obniża precyzję. Druga pułapka z karty dotyczy precyzji liczbowej: model uruchamiać w bfloat16 albo float32, nigdy w float16, bo zakres aktywacji przekracza dynamikę tej reprezentacji i model zwraca NaN albo po cichu zepsute wektory zamiast błędu.
Bez Pythona zostają gotowe paczki. Ollama ma model w swojej bibliotece pod nazwą embeddinggemma-2 w czterech wariantach pamięci (270m, 440m, 570m, 740m) i wystarczy polecenie „ollama pull embeddinggemma-2″, żeby liczyć osadzenia przez lokalne API. Pod frazę embeddinggemma onnx odpowiada repozytorium onnx-community z wariantami do transformers.js: skwantyzowany model tekstowy q4f16 zajmuje około 157 MB, pełny bez kwantyzacji ponad 1 GB, a encoder audio dochodzi kolejne 170 MB w q4f16. Do narzędzi na silniku llama.cpp Unsloth publikuje kwantyzacje GGUF, od 558 MB w pełnej precyzji BF16 przez 310 MB w Q8_0 do 176 MB w UD-Q4_K_XL, plus osobny projektor multimodalny, którego pełna wersja waży 982 MB. Wagi źródłowe siedzą na Hugging Face i Kaggle, a Google przygotował też warianty zoptymalizowane pod urządzenia w repozytorium LiteRT Community. Dla zadań przeglądarkowych blog wspomina transformers.js i WebGPU, a w aplikacji Google AI Edge Gallery model obsługuje funkcje Instant Media Search i Video Moments Finder. Pełniejsze tło o tym, co w ogóle znaczy trzymanie modeli u siebie, jest w naszym materiale o lokalnym AI na komputerze i na hubie o lokalnych modelach.
Tego modelu nie uruchamialiśmy na własnym sprzęcie, w tym tekście liczą się odczyty z dokumentacji producenta, karty modelu i strony projektu Transcribe. Gdy będziemy mieli własny pomiar jakości na polskich tekstach, dopiszemy go z notą aktualizacji.
Kiedy ma sens, a kiedy nie
EmbeddingGemma 2 ma sens wszędzie tam, gdzie liczy się prywatność, brak internetu albo koszt API przy dużym wolumenie. Lokalne wyszukiwanie po firmowej dokumentacji bez wysyłania czegokolwiek w chmurę. Indeks kodu w repozytorium, po którym szuka się zapytaniami naturalnojęzycznymi, tu skok na MTEB Code robi różnicę. RAG offline na laptopie z modelem generatywnym obok. Wyszukiwanie po archiwum nagrań i zdjęć na dysku. Klasyfikacja i grupowanie skarg klientów bez podpisywania umowy z dostawcą chmury. Wszystkie te przypadki to praca, którą Google pokazuje we własnych demo, od Instant Media Search po silniki decyzyjne w aplikacji Foresight, gdzie model współgra z Gemma 4 w roli rozumującej.
Nie ma sensu tam, gdzie potrzebna jest jakość szczytowa niezależnie od kosztów. Duże osadzenia serwerowe od AWS, Cohere czy OpenAI wygrywają na trudnych kolekcjach wielojęzycznych i nie mają limitu kontekstu liczonego tokenami telefonu. Model też nie zamieni Whispera ani Parakeeta w transkrypcji na produkcji, o czym przekonuje sam projekt Transcribe swoim 5% błędem słownym. I na koniec oczywistość, którą karta zapisuje czarno na białym: model osadzeń nie pisze odpowiedzi, więc bez modelu generatywnego obok nie zbuduje się z niego czatbota. Zastrzeżenie językowe też jest ważne: dokumentacja obiecuje ponad 100 języków, ale wprost mówi, że wydajność między językami nie jest równa, a my jakości na polskich danych nie mierzyliśmy.
Najczęstsze pytania
Czy EmbeddingGemma 2 obsługuje polski
Karta modelu deklaruje ponad 100 obsługiwanych języków, więc polski mieści się w założeniach projektu. Ten sam dokument zastrzega jednak, że wydajność nie jest równa między językami i nie publikuje wyników dla poszczególnych języków. Nie testowaliśmy modelu na polskich tekstach, więc jakości po polsku nie potwierdzamy ani nie zaprzeczamy.
Ile pamięci RAM potrzebuje EmbeddingGemma 2
Po kwantyzacji na Google Pixel 11 Pro od około 191 MB aktywnej pamięci dla samych wag tekstowych do około 567 MB dla pełnego modelu multimodalnego. Dla tekstowego workflow wystarczy laptop z 8 GB RAM z dużym zapasem, o czym świadczy hack STT działający na MacBooku Air M3 z 8 GB. Warianty kwantyzacji GGUF zaczynają się od około 176 MB samego modelu tekstowego.
Czy można używać EmbeddingGemma 2 komercyjnie
Tak, licencja Apache 2.0 pozwala na użycie komercyjne, dostrajanie i wdrażanie we własnych produktach. Obowiązują przy tym zasady Gemma Prohibited Use Policy, czyli standardowy wykaz zakazanych zastosowań dla rodziny Gemma. Pierwszy model z tej linii przekroczył 20 milionów pobrań. Co w praktyce znaczy otwarta licencja modelu i na co uważać przy wdrożeniu, rozpisuję w tekście o otwartych modelach AI.
Czym różni się model osadzeń od czatbota
Czatbot generuje tekst odpowiedzi, model osadzeń generuje wektor liczb opisujący sens wejścia. Wektor służy do porównywania, szukania, grupowania i klasyfikowania, nie do pisania. W praktycznym układzie RAG oba się uzupełniają: osadzenia znajdują właściwe fragmenty wiedzy, model generatywny na ich podstawie formułuje odpowiedź.
Czy EmbeddingGemma 2 da się uruchomić w przeglądarce
Tak. Blog producenta wskazuje transformers.js i WebGPU jako ścieżki budowania pod przeglądarkę, a repozytorium onnx-community utrzymuje warianty ONNX przygotowane pod transformers.js, ze skwantyzowanym modelem tekstowym około 157 MB w formacie q4f16. Całe liczenie dzieje się wtedy na maszynie użytkownika.
Źródła
- Blog Google: EmbeddingGemma 2, an open, lightweight multimodal embedding model (Sahil Dua, Henrique Schechter Vera, 6.10.2026), odczyt: https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
- Karta modelu google/embeddinggemma-2 na Hugging Face (benchmarki, architektura, limity kontekstu, prefiksy zadań), odczyt: https://huggingface.co/google/embeddinggemma-2
- Dokumentacja Gemma w Google AI for Developers, sekcja EmbeddingGemma (opis modelu, EmbeddingGemma 1, wskazówka RAG z Gemma 4 E2B), odczyt: https://ai.google.dev/gemma/docs/embeddinggemma
- Strona projektu Embedding Gemma Transcribe (hack modelu mowy, tabele szybkości, WER, opis mechanizmu), odczyt: https://eg2.haku.sh/
- Wyszukiwanie HN Algolia, wątki o EmbeddingGemma (punkty, komentarze, daty obu fal), odczyt: https://hn.algolia.com/api/v1/search?query=EmbeddingGemma&tags=story
- Karta modelu nomic-embed-text-v1.5 na Hugging Face (licencja, tabela MTEB ang., MRL), odczyt: https://huggingface.co/nomic-ai/nomic-embed-text-v1.5
- Karta modelu BAAI/bge-m3 na Hugging Face (licencja MIT, wymiar 1024, kontekst 8192, tryby dense/sparse/colbert), odczyt: https://huggingface.co/BAAI/bge-m3
- Biblioteka Ollamy, model embeddinggemma-2 (warianty pamięci, instalacja), odczyt: https://ollama.com/library/embeddinggemma-2
- Repozytorium onnx-community/embeddinggemma-2-ONNX na Hugging Face (warianty ONNX i rozmiary plików), odczyt: https://huggingface.co/onnx-community/embeddinggemma-2-ONNX
- Repozytorium unsloth/embeddinggemma-2-GGUF na Hugging Face (kwantyzacje GGUF i rozmiary plików), odczyt: https://huggingface.co/unsloth/embeddinggemma-2-GGUF