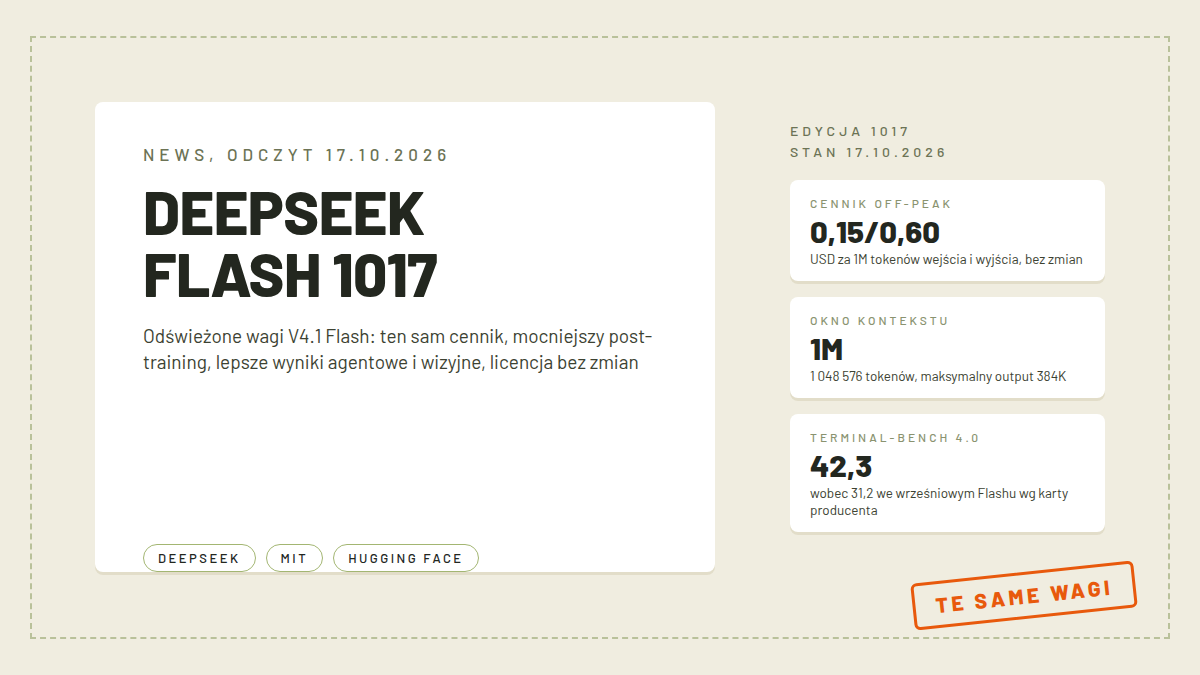
DeepSeek wypuścił w nocy z 16 na 17 października nowe wagi swojego najtańszego dużego modelu, oznaczone DeepSeek-V4.1-Flash-1017. Liczba na końcu to data wydania, bo konwencja zapisu jest prosta: 1017 znaczy 17 października. Karta na Hugging Face powstała o 02:40 UTC, czyli o 04:40 czasu polskiego, a kilkanaście godzin później model miał ponad 700 lajków i dwa osobne wątki na Hacker News, w tym jeden z blisko 500 punktami (odczyt 17.10, liczniki żywe). To bardzo głośne przyjęcie jak na odświeżenie istniejącego modelu, nie premiery czegoś zupełnie nowego.
I właśnie o to chodzi: DeepSeek-V4.1-Flash-1017 to nie nowa architektura ani nowy członek rodziny, tylko mocniej wytrenowana edycja wrześniowego V4.1 Flash, modelu, którego pełny opis rodziny V4 ukazał się u nas wczoraj. Architektura i pliki wag zostały te same, ceny API bez zmian, a producent obiecuje, że przy tych samych stawkach dostajesz krótsze odpowiedzi, szybsze wykonywanie zadań i wyraźnie lepsze wyniki w benchmarkach agentowych. Jeśli używasz API przez nazwę deepseek-flash, nowy model dostajesz automatycznie, bez zmiany ani jednej linijki kodu. Poniżej rozbieram, co dokładnie się zmieniło, ile to kosztuje i czy jest sens trzymać te wagi na własnym sprzęcie. Tekst powstał w całości na kartach modeli, cenniku i wątkach dyskusyjnych, bez własnych testów; wszystkie odczyty mają datę 17 października 2026.
- Co dokładnie wydano 17 października
- Te same wagi, inny trening
- Benchmarki producenta: stare i nowe liczby obok siebie
- Multimodalność i licencja MIT nie są nowością
- Ceny: cennik bez zmian, nazwa też
- Co to znaczy przy pracy z Polski
- Lokalnie: kto to w ogóle uruchomi
- Rodzina V4: co dalej, a czego nadal nie ma
- Najczęstsze pytania
Co dokładnie wydano 17 października
Formalnie rzecz biorąc, DeepSeek opublikował trzy rzeczy naraz. Po pierwsze wagi nowej edycji na Hugging Face i ModelScope, po drugie komunikat na stronie dokumentacji API pod tytułem „Wish-Driven Programming Made Real”, po trzecie udostępnienie wszystkim swoim interfejsów Search & Fetch, czyli wyszukiwania i pobierania stron obsługiwanych przez własną wyszukiwarkę firmy. Komunikat nazywa nową edycję ulepszeniem Pareto: mocniejsze wyniki, krótsze odpowiedzi i szybsze wykonywanie zadań w tej samej cenie. Dla pracy agentowej zaleca aktualizację DeepSeek Harness do wersji 0.2.1-rc.1 albo nowszej. W treści pojawia się też informacja, że model poprawiono metodą uczenia ze wzmocnieniem z własną informacją zwrotną, po angielsku reinforcement learning with self-feedback, szczególnie w budowaniu kompletnych projektów od zera, od prostej gry po modelowanie 3D.
Karta modelu mówi o tym samym krócej: to minor update względem DeepSeek-V4.1-Flash, z istotnymi poprawami w rozumowaniu, kodowaniu, zadaniach agentowych i benchmarkach wizyjnych. Sceptycyzm pojawił się od razu, bo różnice w tabelach są duże jak na minor update. Jeden z komentujących na Hacker News napisał wprost: „a minor update” they say before showing off benchmarks that display a substantial improvement. Inny przyznał wprost, że nie wierzy w te liczby. Odpowiedź na taką wątpliwość jest jedna i uczciwa: to deklaracje producenta, mierzone w jego własnym środowisku testowym, i tak trzeba je czytać do czasu niezależnych powtórek.
Te same wagi, inny trening
Porównałem pliki konfiguracyjne obu edycji bajt po bajcie i są identyczne. Metadane wag liczą 763,2 mld zapisanych parametrów, a karta rozkłada rodzinę na szkielet o 552 mld parametrów i moduł pamięci warunkowej Engram o 196 mld, sięgany wybiórczo przy przetwarzaniu tokenów. Aktywnych podczas pracy jest tylko 8 mld parametrów na wejściu i 16 mld na generowaniu, i właśnie ta oszczędność czyni Flasha tak tanim w stosunku do możliwości. Architektura CED, czyli koder-kaskadowy dekoder, skompresowana uwaga CSA2 i bufor KV wielkości 890 bajtów na token, wszystko to zostaje z września bez zmian.
Zmienia się etap post-training, czyli trening następujący po pretreningu na 45 bln tokenów. To ta część, która decyduje o tym, jak model radzi sobie z narzędziami, długimi zadaniami i poleceniami użytkownika, i to ją przećwiczyli od nowa. Całą mechanikę architektury, od przepływu danych między koderem a dekoderem po oszczędności bufora KV, rozpisaliśmy zresztą osobno w artykule o rodzinie DeepSeek V4, tu wystarczy konstatacja, że nic z tego nie ruszono. Zmieniło się za to zalecenie dotyczące próbkowania: poprzednia edycja dopuszczała top_p 0,95 albo 1,0, nowa karta podaje wyłącznie 1,0 przy temperature 1,0. Osobny akapit karty tłumaczy, że wydanie nie zawiera szablonu rozmów w formacie Jinja i odsyła do własnego pakietu deepseek-recipe, czyli bibliotek Rust z wiązaniami Pythona. To istotne dla kogoś, kto uruchamia wagi samodzielnie: tokenizacja rozmowy idzie przez ich narzędzia, nie przez standardowy szablon.
Benchmarki producenta: stare i nowe liczby obok siebie
Karta nowej edycji podaje bezpośrednie porównanie obu wersji w jedenastu testach. Zastrzeżenie co do metodyki: nowa karta wymienia harnessy, Claude Code dla Terminal-Bench 4.0 i Mini-SWE-V2 dla DeepSWE, ale nie precyzuje nakładu rozumowania. Wartości starszej edycji zgadzają się co do punktu z wrześniową kartą, gdzie pomiary wykonywano przy maksymalnym reasoning_effort równym 100, więc tabela porównuje rząd z rzędem.
| Benchmark | edycja 1017 | V4.1 Flash z września |
|---|---|---|
| HLE bez narzędzi | 42,6 | 36,8 |
| Terminal-Bench 4.0 | 42,3 | 31,2 |
| DeepSWE v1.1 | 77,0 | 74,2 |
| ProgramBench | 29,1 | 20,3 |
| NL2Repo-Bench | 68,2 | 65,4 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 |
| Agents’ Last Exam | 35,4 | 31,8 |
| Apex Bench v1.1 | 72,1 | 64,6 |
| Chartography z narzędziami | 83,0 | 78,9 |
| BabyVision z narzędziami | 92,5 | 89,6 |
| ZeroBench-main z narzędziami | 51,0 | 49,0 |
Największe skoki dotyczą pracy terminalowej i programowania: Terminal-Bench rośnie o jedenaście punktów, ProgramBench o prawie dziewięć. W tej samej tabeli leżą punkty odniesienia konkurencji: K3, GLM-5.3, GPT-5.6 Sol i Opus 5. W dziewięciu z jedenastu wierszy wynik nowej edycji jest wyższy niż GPT-5.6 Sol, niżej wypada tylko w HLE bez narzędzi i ZeroBench, a do Opus 5 wszędzie jeszcze brakuje. Czytelnicy Hacker News oceniali pozycję modelu chłodniej niż tabela: jeden z nich podsumował, że to poziom blisko Opus 5, daleko za Sol 6.1 i Opus 5.5, i że dla większości zastosowań to i tak w zupełności wystarcza.
Multimodalność i licencja MIT nie są nowością
W opisach tego wydania powtarza się teza, że 1017 przyniósł obsługę obrazów. Nieprawda. Poprzedni V4.1 Flash od premiery 10 września był modelem image-text-to-text: przetwarza obrazy wejściowe przez własny enkoder wizji DeepSeek-ViT i generuje tekst. Tag image-text-to-text siedzi w metadanych obu kart, identycznie jak w API OpenRouter oba wpisy mają modalność text+image->text. Edycja 1017 poprawia wyniki wizyjne w trzech testach z narzędziami, widać to w tabeli powyżej, ale sama zdolność widzenia nie jest nowa.
To samo dotyczy licencji. Obie karty stoją na MIT, czyli wagi można używać komercyjnie, łączyć z własnym kodem i hostować u siebie bez opłat na rzecz DeepSeek. W kontekście otwartych modeli to nadal jeden z najłagodniejszych zestawów warunków na rynku i główny powód, dla którego rodzina V4 jest tak chętnie wdrażana u dostawców. Zmieniła się za to drobnostka, która może kogoś zaskoczyć przy samodzielnym uruchamianiu: nowe wagi są zapisane w formacie fp8 z kopiami 8-bitowymi, całe repozytorium waży około 510 GB, a instrukcja konwersji do lokalnej inferencji siedzi w katalogu inference karty.
Ceny: cennik bez zmian, nazwa też
Cennik first-party, odczyt 17 października: model deepseek-flash kosztuje poza szczytem 0,15 USD za milion tokenów wejścia z pominięciem cache, 0,60 USD za milion tokenów wyjścia i 0,003 USD za odczyt z cache. W godzinach szczytu stawki podwajają się do 0,30 USD i 1,20 USD. Szczyt to 01:00-04:00 oraz 06:00-10:00 UTC od poniedziałku do piątku, z wyłączeniem chińskich świąt, w polskim czasie letnim daje to przedziały 03:00-06:00 i 08:00-12:00. Kontekst to 1M tokenów, maksymalna odpowiedź 384K, limit równoległych żądań 2500, najwyższy w całej ofercie.
Dwie rzeczy robią tu wrażenie. Pierwsza: producent wprost pisze, że legacy nazwy deepseek-v4-flash i deepseek-v4-flash-vision-exp zostały wycofane, a żądania pod nimi obsługuje od dziś właśnie edycja 1017, rozliczana po cenie Flasha. Druga: cena się nie ruszyła, mimo że benchmarki poszły w górę, więc za te same pieniądze dostajesz po prostu lepszy model. Na OpenRouter oba wpisy, stary deepseek-v4.1-flash i nowy deepseek-v4.1-flash-1017, wiszą po identycznych 0,15/0,60 USD za 1M z cache read po 0,003 USD i oknem 1 048 576 tokenów, a nowa pozycja ma w opisie snapshot z 17 października serwowany pod nazwą deepseek-flash (odczyt 17.10). Portal Artificial Analysis wykazuje dla nowej edycji indeks inteligencji 39,5, reszta swoich indeksów jeszcze pusta.
Drobny, ale praktyczny akcent: interfejsy Search & Fetch rozlicza się osobno, po 0,75 USD za tysiąc udanych zapytań każdy. Do 31 października 2026, 16:00 UTC, wywołania tych narzędzi po stronie serwera z DeepSeek Harness, Claude Code i Codex są darmowe, potem zacznie się liczyć rachunek. Jeśli masz agenta, który intensywnie szuka w sieci, ten termin warto mieć w kalendarzu.
Co to znaczy przy pracy z Polski
Warstwa techniczna nie zmienia się dla nikogo: jeśli wołasz API przez deepseek-flash, od dziś dostajesz 1017, jeśli przez OpenRouter, wybierasz wpis z 1017 albo czekasz na przełączenie aliasu flash-latest. Ceny w dolarach przeliczaj przy kursie z danego dnia, a godziny szczytu masz rozpisane wyżej, więc przy dużych batchach opłaca się je spychać w noc albo wczesne popołudnie. Odczyt z cache po 0,003 USD za milion tokenów robi robotę przy agentach, które wielokrotnie przepychają ten sam kontekst, a pojęcia tokena i wyceny za token rozpisujemy dokładnie w osobnym tekście o tym, czym jest token AI.
W dyskusji na Hacker News wrócił też wątek, który przy chińskich wagach zawsze wraca: jeden z komentujących zauważył, że OpenCode kieruje żądania do DeepSeek do Chin, i rozwinęła się z tego dłuższa wymiana o prywatności i zaufaniu do dostawców, bez rozstrzygnięcia. Dla firmy podlegającej RODO czy regulacjom branżowym to argument, który trzeba rozważyć osobno, niezależnie od ceny. Rozwiązaniem pośrednim jest hostowanie wag u europejskiego dostawcy albo u siebie, o czym niżej.
W ekosystemie narzędzi przełączenie poszło szybko: w wątku OpenRouter użytkownicy raportowali, że OpenCode ma model dostępny od razu, na razie bezpłatnie w ramach limitów. Pisano też, że V4.1 Flash w opencode za 8 USD miesięcznie dawało więcej tokenów i możliwości niż subskrypcja za 200 USD u amerykańskich dostawców, i że model błyskawicznie generuje odpowiedzi, z widocznym łańcuchem myśli i bez losowych blokad recenzji bezpieczeństwa. To opinie użytkowników, nie nasze pomiary, ale spójne z tym, co o kosztach pracy agentowej pisaliśmy przy okazji otwartych modeli AI.
Lokalnie: kto to w ogóle uruchomi
Tu należy powiedzieć wprost: to nie jest model na domowy komputer. 510 GB wag w oryginale, do tego zapotrzebowanie na pamięć operacyjną przy 1M okna, sprawiają, że realny odbiorca lokalnej kopii ma serwerownię albo przynajmniej stację z pół terabajtem szybkiej pamięci. Na Hacker News ktoś zapytał o parę urządzeń DGX Spark, a odpowiedź brzmiała, że model jest za duży już dla dwóch takich pudełek i realnie wchodzi w grę dopiero cztery sztuki. Jeśli szukasz modeli do własnej maszyny, spokojniej zacząć od naszych poradników o lokalnym AI na komputerze i o tym, jaki model AI wybrać na słaby komputer, a rodzinę DeepSeek traktować jako kandydata na serwer, nie na laptopa.
Społeczność i tak zareagowała błyskawicznie. W kilkanaście godzin po publikacji na Hugging Face wisiały już kwantyzacje od społeczności: GGUF od użytkownika mrfakename z godziny 08:28 UTC, wariant VQ-GGUF z tagami pod DGX Spark od Baekpiki z godziny 10:10, wersje EXL3 2,9 bpw i 3,5 bpw, kwantyzacje MLX oQ4e i niższe oraz NVFP4. Pobrań w chwili odczytu miały po zero, więc o jakości tych plików na razie nie sposób cokolwiek twierdzić, traktujesz je na własne ryzyko. Wcześniejsza edycja Flasha ma na koncie ponad 1,3 mln pobrań i 4,6 tys. lajków, więc po pole do wzrostu nie trzeba się martwić.
Rodzina V4: co dalej, a czego nadal nie ma
W skrócie: edycja 1017 wzmacnia pozycję Flasha jako głównego modelu API i czatu DeepSeek, a V4.1-Pro nadal nie istnieje. W cenniku first-party za bardziej zaawansowany model odpowiada deepseek-v4-pro w wariancie DeepSeek-V4-Pro-0813 z sierpnia, żądania legacy routed od 14 września przez młodszego Flasha, a na liście wydań producenta po 10 września nie ma żadnej pozycji Pro. Czy V4.1-Pro w ogóle nadejdzie, producent nie zapowiedział, w komunikatach nie ma ani daty, ani nazwy. Wszystko, co wiemy o konfiguracji rodziny, limitach i kwantyzacjach poprzednich modeli, mamy rozpisane w artykule o rodzinie DeepSeek V4, a dzisiejsza edycja wpisuje się w schemat, który ta rodzina już nam pokazała: częste, tanie odświeżenia zamiast wielkich premier.
Najczęstsze pytania
Czy DeepSeek V4.1 Flash 1017 jest darmowy?
Wagi są darmowe na warunkach MIT, więc możesz je pobrać, hostować i używać komercyjnie bez opłat dla producenta. Czat DeepSeek działa bez opłat po założeniu konta, ale producent nie publikuje limitów darmowego planu. API jest płatne wg cenniku poniżej, a na OpenCode model pojawił się w ofercie bezpłatnej w ramach limitów serwisu.
Ile kosztuje API DeepSeek V4.1 Flash 1017?
Poza szczytem 0,15 USD za milion tokenów wejścia bez cache i 0,60 USD za milion tokenów wyjścia, w godzinach szczytu 0,30 USD i 1,20 USD, odczyt z cache 0,003 USD. Ceny po edycji 1017 pozostały takie same jak przy wrześniowym Flashu.
Czy DeepSeek V4.1 Flash 1017 obsługuje obrazy?
Tak, przyjmuje obrazy na wejściu i generuje tekst, jak cały V4.1 Flash od 10 września. Nowa edycja podniosła wyniki testów wizyjnych z narzędziami, sama zdolność widzenia nie jest jednak nowością.
Czy DeepSeek V4.1 Flash 1017 uruchomię na własnym komputerze?
Bez poważnego sprzętu nie: oryginalne wagi mają około 510 GB, a model aktywuje 8-16 mld parametrów przy oknie do miliona tokenów. Społeczność publikuje już kwantyzacje GGUF, EXL3 i MLX, ale przy tej skali mówimy o serwerze, nie o komputerze osobistym.
Czym różni się deepseek-flash od deepseek-v4-pro?
deepseek-flash to najtańszy model oferty, dziś w wariancie 1017, z obsługą obrazów, limitem 2500 żądań równoległych i cenami od 0,15/0,60 USD za 1M. deepseek-v4-pro to droższy model z sierpnia, bez obsługi wizji, z limitem 500 żądań i stawkami 0,66/1,98 USD poza szczytem. Wersji V4.1-Pro nie ma w ofercie.
Źródła
- Karta modelu DeepSeek-V4.1-Flash-1017 na Hugging Face (metadane, licencja, data utworzenia, tabela benchmarków), odczyt: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- README karty DeepSeek-V4.1-Flash-1017 (porównanie benchmarków z poprzednią edycją, parametry próbkowania), odczyt: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017/raw/main/README.md
- README karty DeepSeek-V4.1-Flash z 10 września (architektura, 552 mld parametrów, Engram 196 mld, pretrening 45T tokenów), odczyt: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/raw/main/README.md
- API Hugging Face dla DeepSeek-V4.1-Flash-1017 (metadane safetensors, liczniki lajków), odczyt: https://huggingface.co/api/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Cennik API DeepSeek (stawki deepseek-flash i deepseek-v4-pro, godziny szczytu, limity równoległości, wycofanie legacy nazw, ceny Search & Fetch), odczyt: https://api-docs.deepseek.com/quick_start/pricing
- Komunikat o wydaniu DeepSeek-V4.1-Flash-1017 na stronie dokumentacji (tytuł Wish-Driven Programming Made Real, reinforcement learning with self-feedback, Search & Fetch dla wszystkich), odczyt: https://api-docs.deepseek.com/news/news261017
- API OpenRouter, pełna lista modeli z cenami wpisu deepseek/deepseek-v4.1-flash-1017 (0,15/0,60 USD, okno 1 048 576 tokenów, indeks AA 39,5), odczyt: https://openrouter.ai/api/v1/models
- Wątek Hacker News o karcie OpenRouter, 496 punktów w chwili odczytu, odczyt: https://hn.algolia.com/api/v1/items/50129121
- Wątek Hacker News o karcie Hugging Face, 330 punktów w chwili odczytu, odczyt: https://hn.algolia.com/api/v1/items/50129045
- Wyszukiwarka Hugging Face po frazie DeepSeek-V4.1-Flash-1017 (kwantyzacje społeczności GGUF, EXL3, MLX, NVFP4 z godzinami publikacji), odczyt: https://huggingface.co/api/models?search=V4.1-Flash-1017
- API Hugging Face dla DeepSeek-V4.1-Flash (liczba pobrań 1 306 744 i 4592 lajków starej edycji), odczyt: https://huggingface.co/api/models/deepseek-ai/DeepSeek-V4.1-Flash
- Autouzupełnianie Google po polsku dla fraz deepseek, deepseek v4, deepseek api cena i deepseek po polsku, odczyt: https://suggestqueries.google.com/complete/search?client=firefox&hl=pl&q=deepseek